Pandas: как добавить данные в существующий файл CSV
Вы можете использовать следующий синтаксис в pandas для добавления данных в существующий файл CSV:
df.to_csv('existing.csv', mode='a', index= False , header= False ) Вот как интерпретировать аргументы в функции to_csv() :
- «existing.csv»: имя существующего CSV-файла.
- mode=’a’: используйте режим «добавления» вместо «w» — режима «записи» по умолчанию.
- index=False: не включать столбец индекса при добавлении новых данных.
- header=False: не включать заголовок при добавлении новых данных.
В следующем пошаговом примере показано, как использовать эту функцию на практике.
Шаг 1. Просмотр существующего CSV-файла
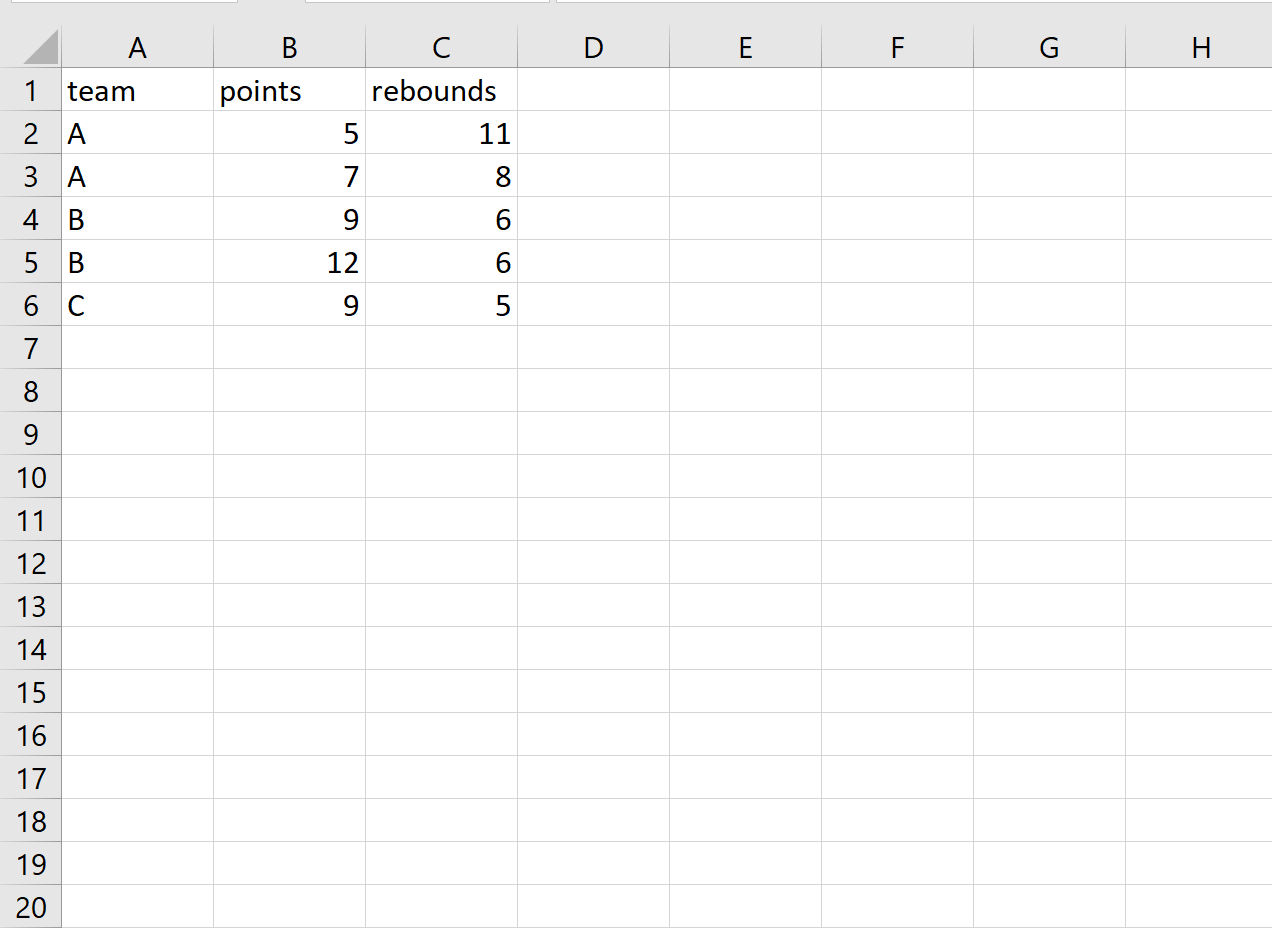
Предположим, у нас есть следующий существующий файл CSV:
Шаг 2: Создайте новые данные для добавления
Давайте создадим новый кадр данных pandas для добавления к существующему файлу CSV:
import pandas as pd #create DataFrame df = pd.DataFrame() #view DataFrame df team points rebounds 0 D 6 15 1 D 4 18 2 E 4 9 3 E 7 12 Шаг 3. Добавьте новые данные в существующий CSV-файл.
В следующем коде показано, как добавить эти новые данные в существующий CSV-файл:
df.to_csv('existing.csv', mode='a', index= False , header= False ) Шаг 4. Просмотрите обновленный файл CSV
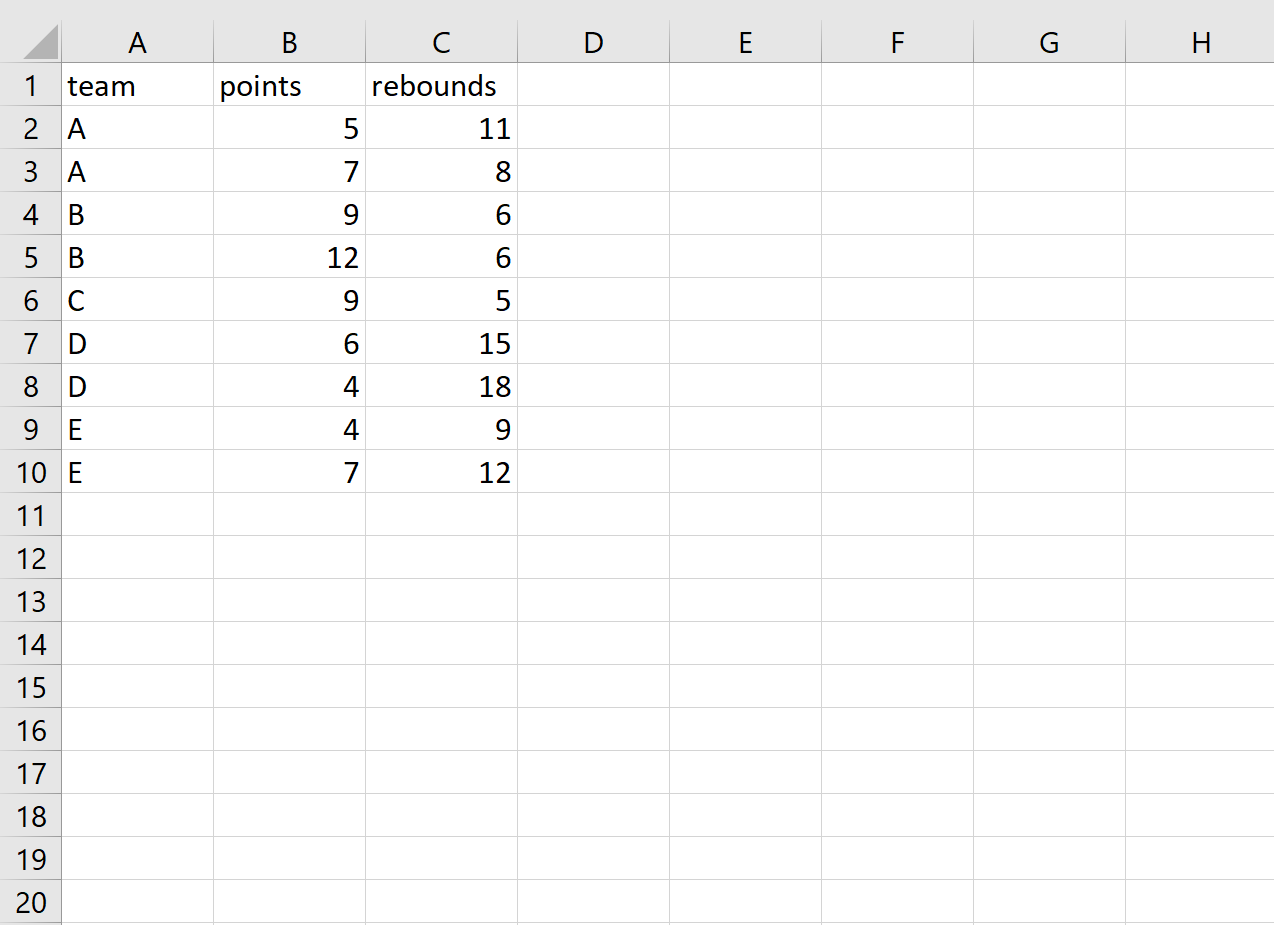
Когда мы открываем существующий файл CSV, мы видим, что новые данные были добавлены:
Примечания по добавлению данных
При добавлении данных в существующий CSV-файл обязательно проверьте, есть ли в существующем CSV-файле столбец индекса или нет.
Если в существующем CSV-файле нет индексного файла, вам нужно указать index=False в функции to_csv() при добавлении новых данных, чтобы Pandas не добавляли индексный столбец.
Как читать и записывать файлы CSV в Python
Давайте запишем следующие данные в наш файл CSV. Он содержит информацию о трех разных штатах США в виде списка, отдельные элементы которого представляют собой словарь.
state_info = [ < "Name": "Colorado", "Largest City": "Denver", "Capital City": "Denver", "Population": "5773714" >, < "Name": "Connecticut", "Largest City": "Hartford", "Capital City": "Bridgeport", "Population": "3605944" >, < "Name": "Delaware", "Largest City": "Dover", "Capital City": "Wilmington", "Population": "989948" >]Код показан ниже.
import csv fields = ['Name', 'Capital City', 'Largest City', 'Population']; with open('state-data.csv', 'a', newline='') as state_file: writer = csv.DictWriter(state_file, fields) writer.writerows(state_info)Сначала мы определяем имена полей в виде списка и сохраняем их в переменных полей ( fields ). Это позволяет объекту записи ( writer ) знать, каким будет заголовок каждого столбца в файле CSV. Метод writerows() сразу записывает все строки, которые мы ему передаем, в CSV-файл. Единственное условие для writerows() состоит в том, что строки, которые мы хотим записать, являются итерируемыми.
Каждая отдельная строка сама по себе также должна быть итерируемой строкой или числом, если мы используем функцию writer() , как мы делали в предыдущем примере. В противном случае каждая строка должна быть словарем, который сопоставляет имена полей ( fieldnames )со строками или числами, чтобы класс DictWriter мог ее обработать.
Теперь попробуем записать в наш CSV-файл следующие данные:
state_info = [ < "Name": "Florida", "Capital City": "Tallahassee" >, < "Name": "Georgia", "Area": "153910", "Largest City": "Atlanta", "Population": "10711908", "Capital City": "Atlanta", >]В приведенных выше данных есть два примечательных момента. Во-первых, в нашем штате Флорида отсутствует некоторая информация. Во-вторых, у штата Джорджия есть дополнительная информация, основанная на том, что мы храним в таблице. В-третьих, ключи для штата Джорджия расположены не в том порядке, в котором мы определили поля для нашего CSV-файла.
Как мы можем обрабатывать такие нестандартные данные? Класс DictWriter предлагает решение. Для отсутствующих ключей мы можем просто указать значение по умолчанию, используя параметр restval . По умолчанию это пустая строка. Однако вы также можете указать пользовательское значение, например Неизвестно (Unknown). Для дополнительных ключей вы можете использовать параметр extrasaction , чтобы указать DictWriter игнорировать эти ключи. Этот параметр по умолчанию вызовет ошибку ValueError .
Вот как писать во все строки сразу.
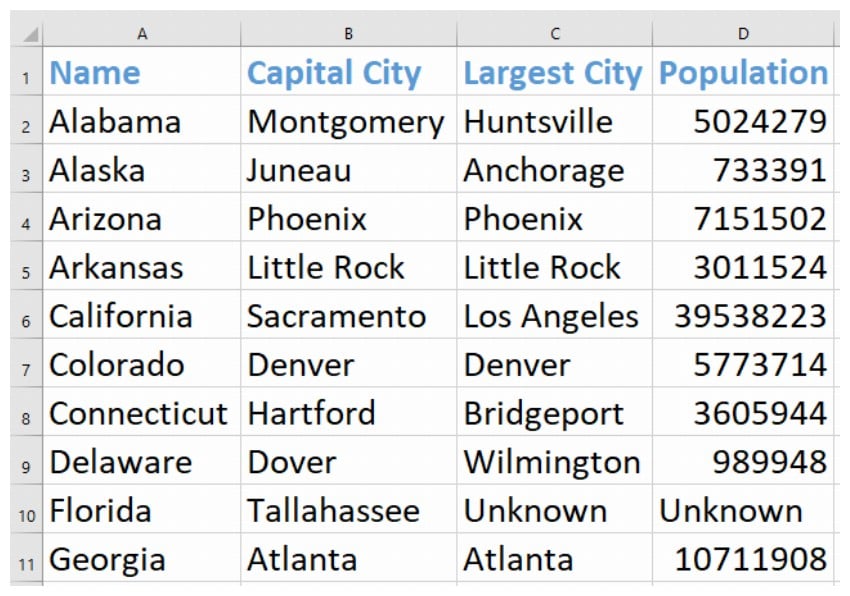
import csv fields = ['Name', 'Capital City', 'Largest City', 'Population'] with open('state-data.csv', 'a', newline='') as state_file: writer = csv.DictWriter(state_file, fields, restval='Unknown', extrasaction='ignore') writer.writerows(state_info)Наш CSV-файл после всех операций записи будет выглядеть так:
Вывод
В этом руководстве рассмотрена большая часть того, что требуется для успешного чтения и записи в CSV-файл с использованием различных функций и классов, предоставляемых Python. Файлы CSV широко используются в программных приложениях, потому что их легко читать и ими легко управлять, а их небольшой размер делает их относительно быстрыми для обработки и передачи.
Модуль csv — чтение и запись CSV файлов

Формат CSV (Comma Separated Values) является одним из самых распространенных форматов импорта и экспорта электронных таблиц и баз данных. CSV использовался в течение многих лет до того, как был стандартизирован в RFC 4180. Запоздание четко определенного стандарта означает, что в данных, создаваемых различными приложениями, часто существуют незначительные различия. Эти различия могут вызвать раздражение при обработке файлов CSV из нескольких источников. Тем не менее, хотя разделители, символы кавычек и некоторые другие свойства различаются, общий формат достаточно универсален. Значит, возможно написать один модуль, который может эффективно манипулировать такими данными, скрывая детали чтения и записи данных от программиста.
Функции обработки CSV-файлов
csv.reader(csvfile, dialect=’excel’, **fmtparams) — возвращает объект reader, который построчно итерирует csvfile. Если csvfile является файловым объектом, то его нужно открыть с параметром newline=». Дополнительный параметр dialect используется для определения ряда параметров, характерных для специфического CSV диалекта. Он может быть подклассом Dialect или одной из строк, возвращаемой функцией list_dialects(). Также могут передаваться дополнительные ключевые аргументы fmtparams для переопределения отдельных параметров форматирования в текущем диалекте.
Каждая строка, считанная из файла csv, возвращается в виде списка строк. Автоматическое преобразование типов данных не выполняется, если не указан параметр формата QUOTE_NONNUMERIC (в этом случае все поля без кавычек преобразуются в числа с плавающей точкой).
Короткий пример использования:
csv.writer(csvfile, dialect=’excel’, **fmtparams) — возвращает объект writer, конвертирующий пользовательские данные в CSV-файл csvfile. csvfile может быть любым объектом с методом write(). Если csvfile является файловым объектом, то его нужно открыть с параметром newline=». Параметры dialect и fmtparams идентичны параметрам в функции csv.reader.
Необходимые методы экземпляра класса writer:
csvwriter.writerow(row) — записывает данные, представляющие одну строку CSV в файл, форматируя согласно текущему диалекту writer.
csvwriter.writerows(rows) — записывает данные, представляющие несколько строк CSV в файл, форматируя согласно текущему диалекту writer.
Пример использования writer :
csv.field_size_limit([new_limit]) — текущий максимальный размер поля. Если задан new_limit, то он становится новым макс. размером.
class csv.DictReader(f, fieldnames=None, restkey=None, restval=None, dialect=’excel’, *args, **kwds) — как reader, но отображает информацию о столбцах в словарь, ключи которого заданы в параметре fieldnames.
fieldnames это последовательность ключей. Если параметр опущен, в качестве ключей используются значения из первой строки файла. Если строка имеет больше полей, чем длина fieldnames , оставшиеся данные будут помещены в список с ключом из переменной restkey . Если строка имеет меньше полей, оставшиеся значения будут установлены в значение restval .
Остальные аргументы пробрасываются далее в экземпляр reader.
class csv.DictWriter(f, fieldnames, restval=», extrasaction=’raise’, dialect=’excel’, *args, **kwds) — как writer, но отображает словари в CSV-файл.
Обязательный параметр fieldnames — последовательность ключей, определяющие порядок, в котором значения из словаря будут записаны в строке CSV-файла f.
Параметр restval определяет значение в случае, если в словаре будет отсутствовать запись с данным ключом. Если словарь содержит лишние ключи, то поведение определяется параметром extrasaction . Если он ‘raise’, то выдаст ошибку. Если ‘ignore’, то такие ключи игнорируются.
Остальные аргументы пробрасываются далее в экземпляр writer.
Помимо методов writerow и writerows, DictWriter имеет также метод
DictWriter.writeheader() — записывает данные строки заголовка в CSV-файл, форматируя согласно текущему диалекту writer.
Пример использования DictWriter:
class csv.Dialect — для упрощения задания формата входных и выходных записей, конкретные параметры форматирования группируются в диалекты, подклассы csv.Dialect . Диалекты поддерживают следующие атрибуты:
Dialect.delimiter — разделитель столбцов в строке CSV-файла. По умолчанию ‘,’.
Dialect.quotechar — символ, использующийся для «склейки» поля, содержащего специальные символы, такие как delimiter, quotechar, или символы новой строки. По умолчанию используется значение ‘»‘.
Dialect.doublequote — как Dialect.quotechar , появляющийся внутри поля, должен экранироваться. Когда True, символ удваивается. Когда False, Dialect.escapechar используется как префикс к quotechar. По умолчанию True.
При записи файла, если doublequote=False и не установлен escapechar, выдаст ошибку при обнаружении quotechar в столбце.
Dialect.escapechar — символ, используемый writer для экранирования delimiter , если quoting установлен в QUOTE_NONE и quotechar , если doublequote=False . При чтении escapechar удаляет какое-либо особое значение со следующего символа. По умолчанию используется значение None, которое отключает экранирование.
Dialect.lineterminator — символы, используемые для завершения строки при записи. По умолчанию ‘\r\n’.
Dialect.skipinitialspace — если True, пробелы, непосредственно следующие за delimiter, игнорируются. Значение по умолчанию — False.
Dialect.strict — когда True, поднимает исключение если CSV файл не распознается. По умолчанию — False.
Dialect.quoting — контролирует, когда кавычки должны генерироваться writer и распознаваться reader. Он может принимать любые константы QUOTE_* и по умолчанию имеет значение QUOTE_MINIMAL.
csv.QUOTE_ALL — writer оборачивает в кавычки все поля.
csv.QUOTE_MINIMAL — writer оборачивает в кавычки только поля, содержащие специальные символы (delimiter, quotechar, lineterminator).
csv.QUOTE_NONNUMERIC — writer оборачивает в кавычки все поля, не являющиеся числами. reader преобразует все поля без кавычек к типу float.
csv.QUOTE_NONE — writer не оборачивает никакие поля в кавычки. Если в данных попадается delimiter или lineterminator, он предваряется символом escapechar, если установлен (исключение, если не установлен). reader не обрабатывает кавычки.
csv.register_dialect(name[, dialect[, **fmtparams]]) — связывает dialect с именем name. Подробности о диалектах см. в разделе «Диалекты и параметры форматирования»
csv.unregister_dialect(name) — удаляет связь диалекта с данным именем.
csv.get_dialect(name) — возвращает класс диалекта, свзанного с именем name.
csv.list_dialects() — список доступных диалектов. На данный момент это ‘excel’, ‘excel-tab’, ‘unix’.
Предустановленные диалекты
class csv.excel — диалект CSV-файла, обычно генерируемого программой Excel.
class csv.excel_tab — диалект CSV-файла, обычно генерируемого программой Excel с настройкой «разделитель с помощью TAB».
class csv.unix_dialect — диалект CSV-файла, обычно генерируемого в UNIX-системах (‘\n’ для новой строки, закавычивание всех полей).
Определение диалекта
class csv.Sniffer — используется для угадывания диалекта CSV-файла. Имеет следующие методы:
csvsniffer.sniff(sample, delimiters=None) — анализирует пример и возвращает Dialect, соответствующий обнаруженным параметрам. Если задан параметр delimiters , он интерпретируется как все возможные разделители.
csvsniffer.has_header(sample) — анализирует текст и возвращает True, если первая строка похожа на строку заголовков.
Методы определения диалекта являются эвристическими; это означает, что Sniffer может ошибаться.
Пример использования Sniffer:
Примеры
Простейший пример чтения CSV файла:
Чтение файла формата passwd:
Простейший пример записи CSV файла:
Для вставки кода на Python в комментарий заключайте его в теги
- Модуль csv - чтение и запись CSV файлов
- Создаём сайт на Django, используя хорошие практики. Часть 1: создаём проект
- Онлайн-обучение Python: сравнение популярных программ
- Книги о Python
- GUI (графический интерфейс пользователя)
- Курсы Python
- Модули
- Новости мира Python
- NumPy
- Обработка данных
- Основы программирования
- Примеры программ
- Типы данных в Python
- Видео
- Python для Web
- Работа для Python-программистов
- Сделай свой вклад в развитие сайта!
- Самоучитель Python
- Карта сайта
- Отзывы на книги по Python
- Реклама на сайте
Чтение и запись табличных данных в файловую систему — Python: Pandas
Библиотека Pandas разрабатывалась для работы с табличными данными. Популярными типами файлов для их хранения являются:
- csv — текстовый формат, в котором значения в столбцах отделены друг от друга разделителем, часто запятой
- xlsx или xls — форматы файлов электронных таблиц Microsoft Excel
Для чтения и записи таблиц в указанные форматы в Pandas существуют специальные методы. О них пойдет речь в этом уроке.
Чтение данных
Начнем работу с продажами в сети из четырех магазинов за одну неделю, которые хранятся в формате csv с запятой в качестве разделителя. Воспользуемся методом read_csv() :
df_orders = pd.read_csv('./data/Shop_orders.csv') print(df_orders.head()) # => Weekday Shop_1 Shop_2 Shop_3 Shop_4 # 0 mon 7 1 7 8 # 1 tue 4 2 4 5 # 2 wed 3 5 2 3 # 3 thu 8 12 8 7 # 4 fri 15 11 13 9 При чтении данных метод не знает, что считать за индекс в данных, поэтому расставляет индексы самостоятельно. Это возрастающая последовательность целых чисел, которая начинается с нуля. В нашем примере явным индексом является первый столбец — Weekday. Дополним метод параметром index_col с явным указанием номера столбца, который хранит индексы:
df_orders = pd.read_csv('./data/Shop_orders.csv', index_col=0) print(df_orders.head()) # => Shop_1 Shop_2 Shop_3 Shop_4 # Weekday # mon 7 1 7 8 # tue 4 2 4 5 # wed 3 5 2 3 # thu 8 12 8 7 # fri 15 11 13 9 У разделителя в данных формата csv есть важное значение при чтении. По умолчанию это запятая. Попытка считать данные с разделителем в виде точки с запятой приведет к некорректному чтению. В примере ниже в результате получается пустой DataFrame , в котором индексами стали данные в строках — не то, что хотелось получить:
df_orders = pd.read_csv('./data/Shop_orders_sep.csv', index_col=0) print(df_orders.head()) # => Empty DataFrame # Columns: [] # Index: [mon;7;1;7;8, tue;4;2;4;5, wed;3;5;2;3, thu;8;12;8;7, fri;15;11;13;9] Для корректного чтения в данном случае достаточно воспользоваться параметром sep :
df_orders = pd.read_csv('./data/Shop_orders_sep.csv', index_col=0, sep=';') print(df_orders.head()) # => Shop_1 Shop_2 Shop_3 Shop_4 # Weekday # mon 7 1 7 8 # tue 4 2 4 5 # wed 3 5 2 3 # thu 8 12 8 7 # fri 15 11 13 9 Иногда описание данных может предшествовать началу самих табличных данных. В примере ниже файл начинается со строк:
Попытка прочитать данный файл повлечет ошибку:
df_orders = pd.read_csv('./data/Shop_orders_abstract.csv', index_col=0) print(df_orders.head()) # => ParserError: Error tokenizing data. C error: Expected 1 fields in line 4, saw 5 Чтобы пропустить ряд строк с описанием, нужно воспользоваться параметром skiprows . Его значение — это количество опускаемых из рассмотрения первых строк в файле:
df_orders = pd.read_csv('./data/Shop_orders_abstract.csv', index_col=0, skiprows=3) print(df_orders.head()) # => Shop_1 Shop_2 Shop_3 Shop_4 # Weekday # mon 7 1 7 8 # tue 4 2 4 5 # wed 3 5 2 3 # thu 8 12 8 7 # fri 15 11 13 9 Запись данных
После чтения и трансформации данных результаты могут быть сохранены в файловую систему. Для этого в Pandas есть ряд специальных методов. Для рассматриваемых типов данных это to_csv() и to_excel() :
df_orders.to_csv('./data/Shop_orders_restore.csv') В примере выше метод to_csv() позволяет сохранить DataFrame в изначальном виде. Если в качестве индекса сохранить значения, которые присвоены Pandas по умолчанию, то это может мешать дальнейшему чтению и обработке. Также такие индексы не несут важной информации.
У нас есть такие данные:
# => Weekday Shop_1 Shop_2 Shop_3 Shop_4 # 0 mon 7 1 7 8 # 1 tue 4 2 4 5 # 2 wed 3 5 2 3 # 3 thu 8 12 8 7 # 4 fri 15 11 13 9 Для них с индексами по умолчанию достаточно воспользоваться параметром index , чтобы не сохранять их файл:
df_orders.to_csv('./data/Shop_orders_restore.csv', index=False) В команде разработки можно проговорить, что будет использоваться в качестве разделителя в csv-файле. Также это может быть продиктовано совместимостью с другими частями программного продукта. Чтобы задать разделитель, нужно использовать параметр sep :
df_orders.to_csv('./data/Shop_orders_restore_sep.csv', index=False, sep=';') Метод to_excel() позволяет сохранять табличные данные в формат MS Excel. Параметризация аналогична методу to_csv() . Меняется только название метода и расширение файла с .csv на .xlsx :
df_orders.to_excel('./data/Shop_orders_restore.xlsx', index=False) В некоторых случаях сохранение названий столбцов также можно отключить. Это может потребоваться, когда нужно сохранить значения в ячейках таблицы, или когда названия столбцов не несут дополнительной информации, и не предполагается их использование. Для этого достаточно задать параметр header значением False:
df_orders.to_excel('./data/Shop_orders_restore_noheader.xlsx', index=False, header=False) Большие таблицы текстовых данных занимают большой объем. Чтобы уменьшить его, можно создавать архивы методами Pandas. Для этого нужно определить метод сжатия и названия файла в архиве, при этом указать их в виде словаря в параметре compression :
df_orders.to_csv( './data/Shop_orders_restore.zip', index=False, compression='method': 'zip', 'archive_name': 'Shop_orders_restore_archive.csv'> ) Выводы
Данные для долгосрочного хранения размещают в виде файлов на жестких дисках. В данном уроке методами библиотеки Pandas выполнялись операции чтения и записи csv и xlsx файлов — наиболее популярных форматов хранения табличных данных.
Данные форматы позволяют хранить таблицы в структурированной форме, но при этом данная форма может сильно варьироваться:
- Могут использоваться различные варианты разделителей значений в столбцах
- Строки описания данных могут появляться в шапке таблице
- Индексы могут храниться не в привычном крайнем левом столбце
В уроке на практических примерах показано, как действовать в таких ситуациях. Конфигурацией параметров методов мы научились:
- Пропускать первые строки в таблице
Открыть доступ
Курсы программирования для новичков и опытных разработчиков. Начните обучение бесплатно
- 130 курсов, 2000+ часов теории
- 1000 практических заданий в браузере
- 360 000 студентов
Наши выпускники работают в компаниях: