Какие синтаксические конструкции можно группировать
Доброго вечера!
1.64.
Сколько конфигураций обязательно должно существовать в прикладном решении?
ответ 2
Это получается Основная К. и К. базы данных?
(0) бд и поставщика
(1) какого ещё поставщика?
(0) да
(1) а если нет поставщика?
(1) а поставщик тот тут причем?
Что, если не сдашь профа, то тебя уволят уже?
(4) он поставляет.
я видал одно отраслевое решение от суровых хабаровчан. 31 «если» по количеству дней в таблице. определённо, без поставщика не обошлось. да и Китай там рядом
бедные рабы прикладных решений.
Даже злопыхать совесть не позволяет.
А вот еще вопросец:
2.20 Какие синтаксические конструкции можно группировать?
1. Процедуры и функции
2. Комментарии к процедурам и функциям
3. Циклы и условия
4. Верно все вышеперечисленное
5. Только процедуры и функции, циклы и условия
что-то я не помню чтобы циклы моно было группировать. А оказывается можно. странно. эм
(9) а их таки можно группировать
КонецЦикла;
можно сгруппировать только в процедуре\функции или области.
«что-то я не помню чтобы циклы моно было группировать» // Это не должно тебя останавливать от ответа на вопрос, ибо у тебя нет варианта ответа «Все, кроме циклов»
(9) Помнится я как-то сделал группировку циклов и условий, долго плевался. больше не рискую.
(9)Группировать можно что угодно.
Пример:
#Область МойКрутойГрппировк
.
#КонецОбласти Извините за мой французский
Группирование данных (C#)
Группированием называют операцию объединения данных в группы таким образом, чтобы у элементов в каждой группе был общий атрибут.
На следующем рисунке показаны результаты операции группирования последовательности символов. Ключ для каждой группы — это символ.

Далее перечислены методы стандартных операторов запроса, которые группируют элементы данных.
Методы
| Имя метода | Описание | Синтаксис выражения запроса C# | Дополнительные сведения |
|---|---|---|---|
| GroupBy | Группирует элементы с общим атрибутом. Каждая группа представлена объектом IGrouping . | group … by |
Пример синтаксиса выражения запроса
В следующем примере кода предложение group by используется для группирования целых чисел в списке на основании четности.
List numbers = [35, 44, 200, 84, 3987, 4, 199, 329, 446, 208]; IEnumerable> query = from number in numbers group number by number % 2; foreach (var group in query) < Console.WriteLine(group.Key == 0 ? "\nEven numbers:" : "\nOdd numbers:"); foreach (int i in group) Console.WriteLine(i); >/* This code produces the following output: Odd numbers: 35 3987 199 329 Even numbers: 44 200 84 4 446 208 */ См. также
- System.Linq
- Общие сведения о стандартных операторах запроса (C#)
- предложение group
- Создание вложенной группы
- Группировка файлов по расширению (LINQ) (C#)
- Группировка результатов запросов
- Вложенный запрос в операции группирования
- Разделение файла на несколько файлов с помощью групп (LINQ) (C#)
Совместная работа с нами на GitHub
Источник этого содержимого можно найти на GitHub, где также можно создавать и просматривать проблемы и запросы на вытягивание. Дополнительные сведения см. в нашем руководстве для участников.
Редактор текста и модуля
Редактор текста и модуля — это один из инструментов разработки. Он используется для редактирования текстовых документов и для редактирования программных модулей конфигурации.
Редактор текстов и модулей предоставляет пользователю все основные функции, необходимые при редактировании как простых текстов, так и текстов программных модулей. Конфигуратор 1С:Предприятия 8 использует этот редактор в двух режимах:
- для редактирования текстовых документов;
- для редактирования текстов модулей (как составную часть редактора формы).
Редактирование текстовых документов
В режиме редактирования текстовых документов редактор поддерживает все стандартные функции редактирования текста:
- создание нового документа или открытие одного из существующих документов;
- ввод и редактирование текста;
- сохранение отредактированного текста;
- печать текста.
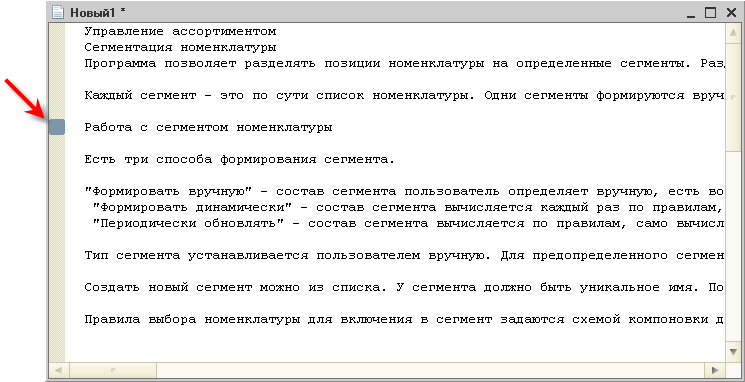
В процессе редактирования текста можно переходить к конкретной строке документа, сдвигать блоки текста на позицию табуляции, выполнять поиск и замену и использовать закладки. Закладки могут быть размещены на любой строке текста:
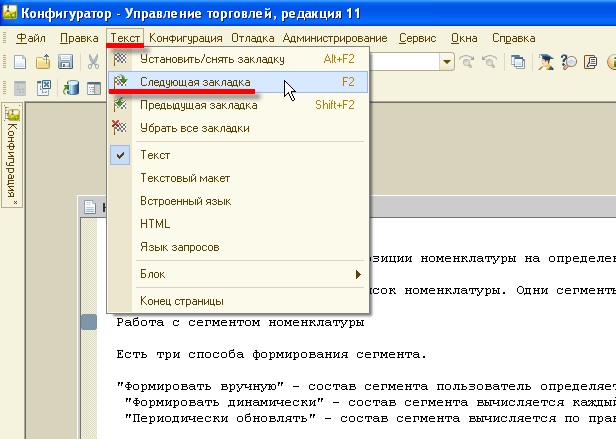
В дальнейшем быстрый переход по закладкам возможен по сочетанию клавиш или команде меню:
Редактирование текстов модулей
Редактирование текстов модулей может выполняться в процессе создания формы объекта прикладного решения, непосредственно при разработке модулей объектов или всего приложения, и при редактировании внешнего текстового файла, содержащего текст модуля.
Помимо стандартных действий, присущих любому текстовому редактору, редактор текстов и модулей имеет ряд специфических особенностей:
Выделение цветом синтаксических конструкций
Для удобства редактирования текстов модулей редактор выделяет цветом элементы встроенного языка: ключевые слова, языковые константы, операторы, комментарии и пр.:
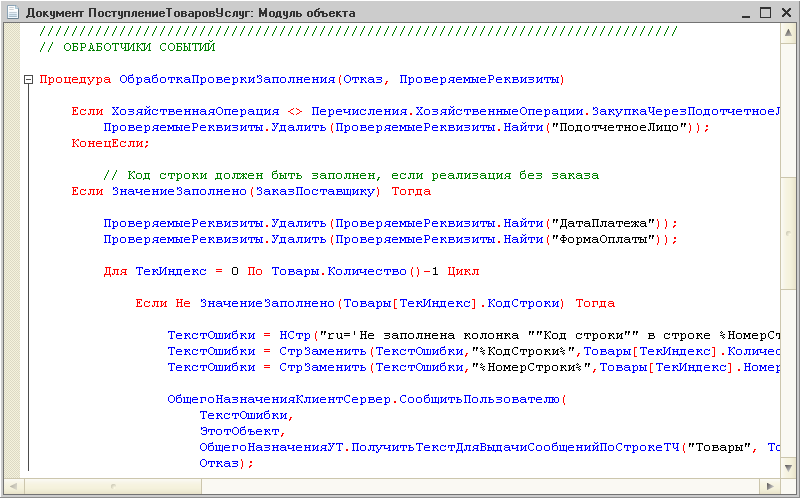
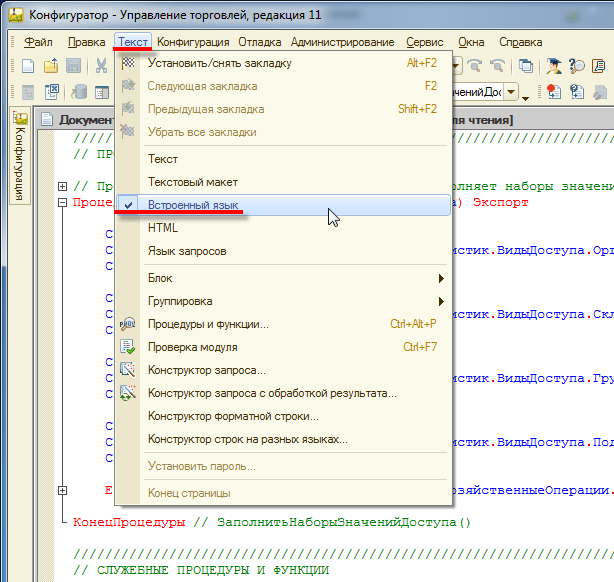
Разработчик может использовать цвета выделения, установленные по умолчанию, или настроить их самостоятельно. В общем случае система сама отслеживает необходимость включения режима выделения цветом. Однако в ситуации, когда система «не знает» о том, что редактируется текст модуля (например, если редактируется внешний текстовый файл, содержащий текст модуля), разработчик может включить режим выделения цветом вручную, используя меню конфигуратора:
Группировка
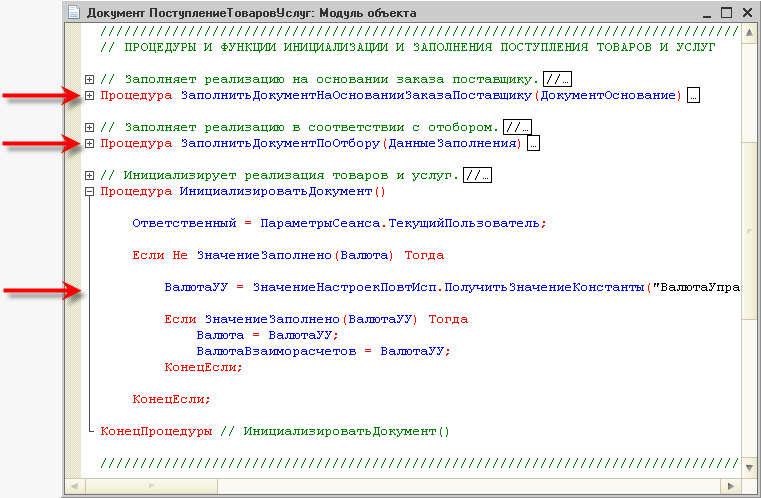
При просмотре модулей редактор позволяет объединять некоторые синтаксические конструкции языка в группы, сворачивать и разворачивать их. Использование группировки синтаксических конструкций позволяет лучше воспринимать различные части текста, а также переносить и копировать группы целиком:
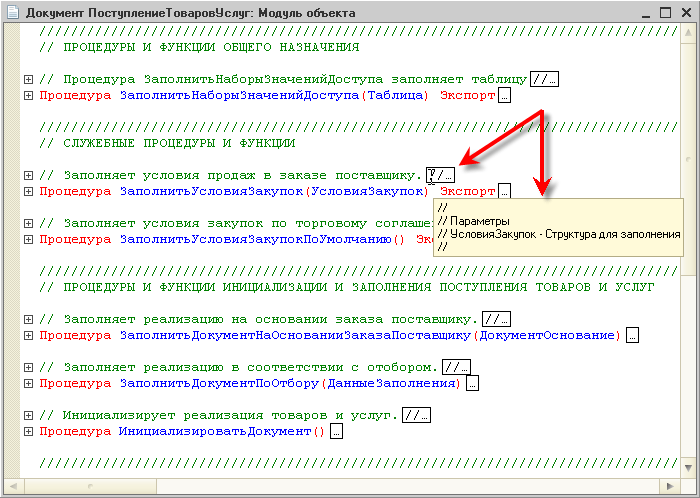
Свернутый текст замещается специальным маркером, который позволяет просмотреть содержимое свернутой группы в виде подсказки:
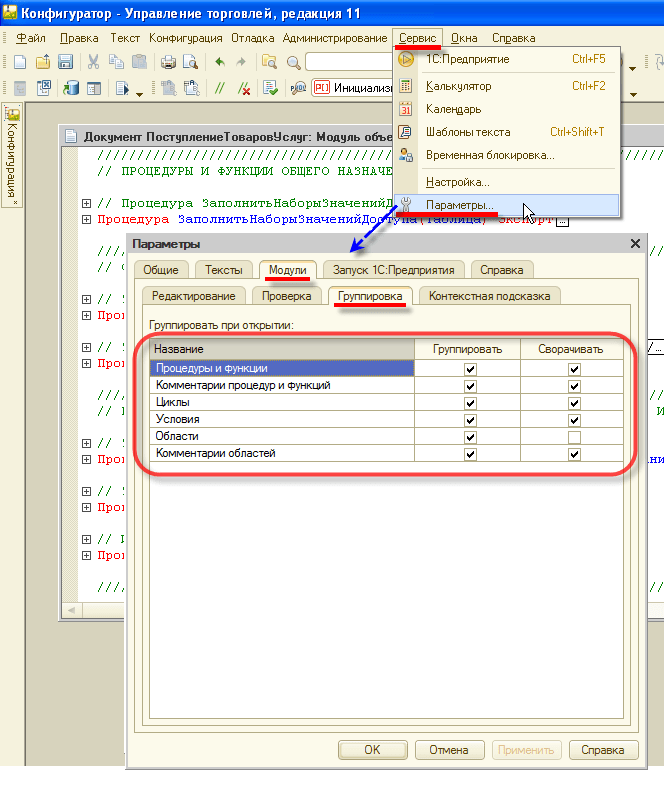
Разработчику предоставляется возможность настраивать режим группировки, указывая, какие синтаксические конструкции могут группироваться, и каким должно быть исходное состояние группировки (свернутая или развернутая) при открытии документа. Таким образом, он может настроить, например, использование группировок «по максимуму»:
Области
Разработчик может выделять произвольные области текста, группировать и сворачивать их подобно тому, как сворачиваются инструкции циклов, условий, процедур и функций.
Каждой области текста, которую выделяет разработчик, он может дать собственное имя. Это позволяет простым и понятным образом выделять части модуля, имеющие сходный смысл.
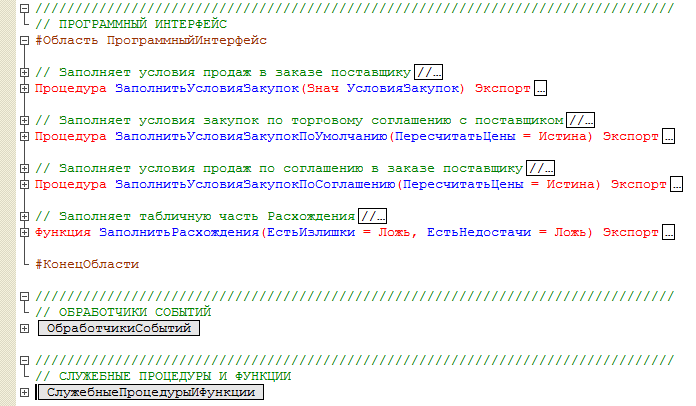
Области выделяются с помощью двух инструкций препроцессора: #Область и #КонецОбласти. Единственное назначение этих инструкций — обозначить группируемые и сворачиваемые строки модуля.
Области могут быть вложены друг в друга или в другие группируемые конструкции языка.
Операции с блоками
Редактор позволяет выполнять ряд операций над выделенными блоками текста модуля: автоматическое форматирование, изменение отступа, добавление/удаление комментариев и переносов строк.
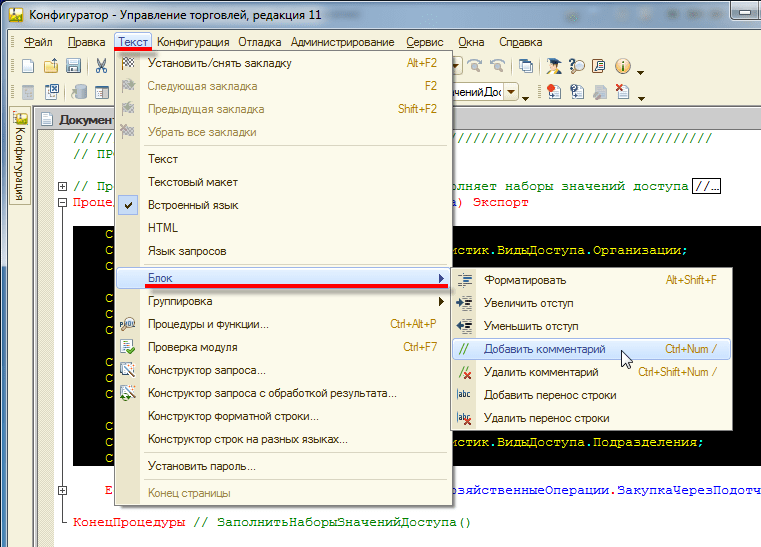
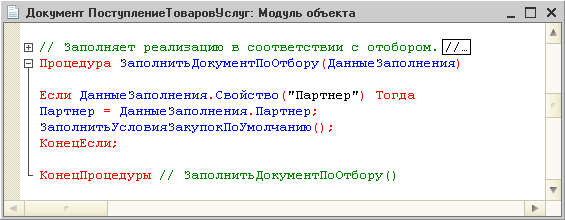
Форматирование модуля
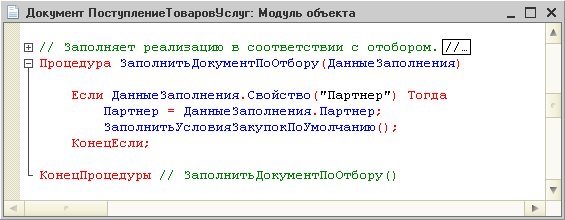
Хорошим стилем написания модулей считается использование синтаксического отступа для выделения управляющих конструкций встроенного языка. Редактор позволяет автоматически форматировать текст при его вводе, и кроме этого, выполнять автоматическое форматирование уже введенного текста.
Результат автоматического форматирования:
Увеличение/уменьшение отступа
Наряду с автоматическим форматированием всего выделенного текста, редактор поддерживает также операции сдвига выделенного блока вправо или влево на шаг табуляции.
Это облегчает ручное форматирование больших фрагментов кода.
Добавление/удаление комментариев
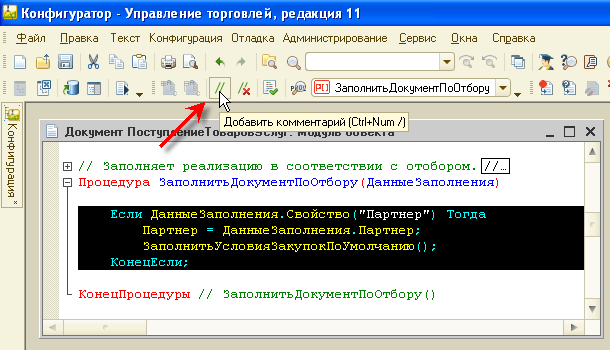
Также редактор содержит очень удобную для разработчика функцию автоматической (одним нажатием мыши) установки и снятия комментариев на выделенный текст. Такая возможность часто используется при отладке модулей:
Добавление/удаление переноса строки
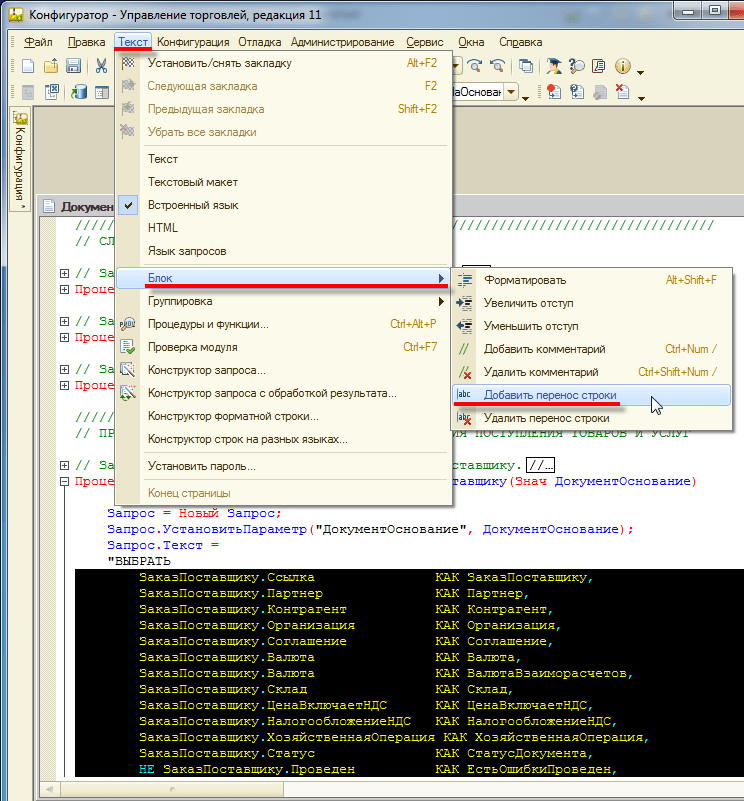
Использование добавления и удаления переноса строки часто применяется при переносе текстов запроса между модулем и, например, консолью запросов.
Таким образом, отладив запрос в консоли запросов, разработчик может просто скопировать текст запроса из консоли, вставить его в модуль и одним движением добавить перенос строки ко всем строкам текста запроса:
Переход по процедурам и функциям
В ситуации, когда модуль содержит большое количество процедур и функций, удобно использовать режим поиска процедур, который поддерживается редактором. Процедуры и функции отображаются в отдельном окне в порядке их расположения в модуле, однако разработчик может отсортировать их по алфавиту. Пиктограммы слева от названия обозначают имеющиеся процедуры и функции, а имена в угловых скобках соответствуют предопределенным процедурам, которые в настоящий момент отсутствуют, но могут быть размещены в данном модуле.
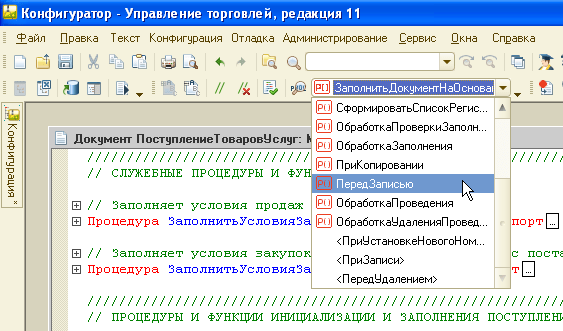
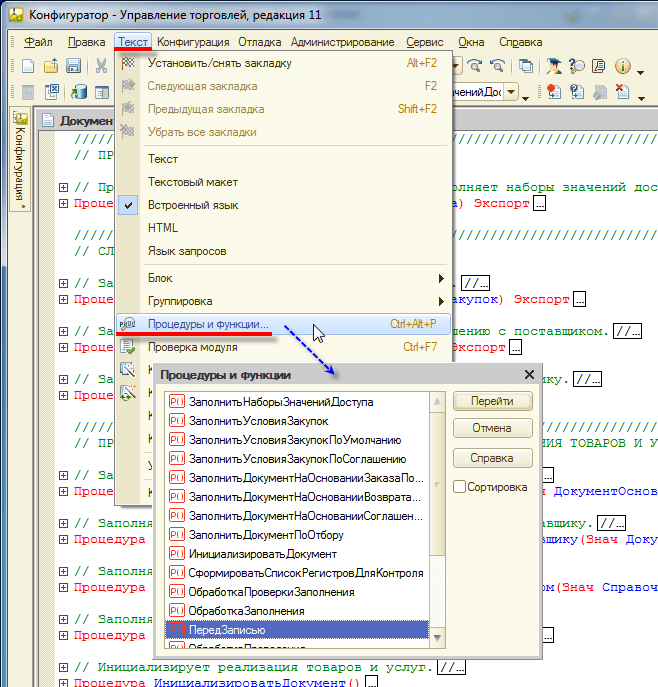
Если установить курсор на той процедуре, которая еще отсутствует в модуле, и нажать Перейти, конструктор автоматически вставит в текст модуля заголовок предопределенной процедуры.
Переход к определению процедур и функций
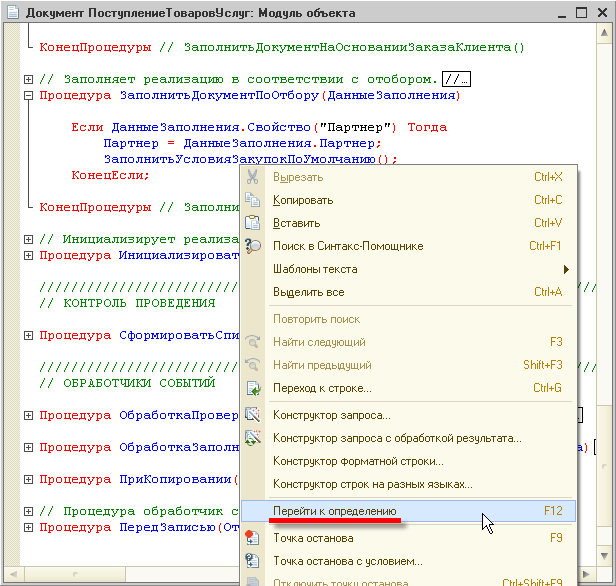
Редактор позволяет автоматически переходить к определению процедуры или функции, использованной в тексте модуля. Для этого достаточно установить курсор на имени нужной функции в теле модуля и выполнить команду контекстного меню или нажать «горячую» клавишу. В окне редактора будет открыт текст искомой процедуры или функции:
Контекстная подсказка
Редактор предоставляет средство контекстного ввода выражений с использованием системных объектов, их свойств, методов и пр. В процессе ввода текста или при нажатии комбинации клавиш редактор выводит контекстный список, позволяющий выбрать нужное свойство, метод, функцию и т. д., что позволяет быстро и правильно набирать тексты модулей:
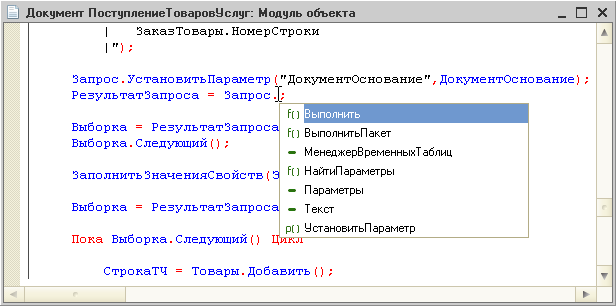
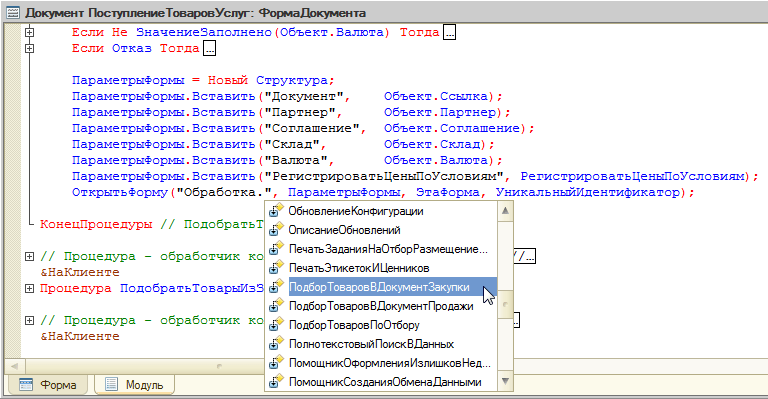
Контекстная подсказка также работает и для параметров некоторых методов, если эти параметры задаются строковыми литералами.
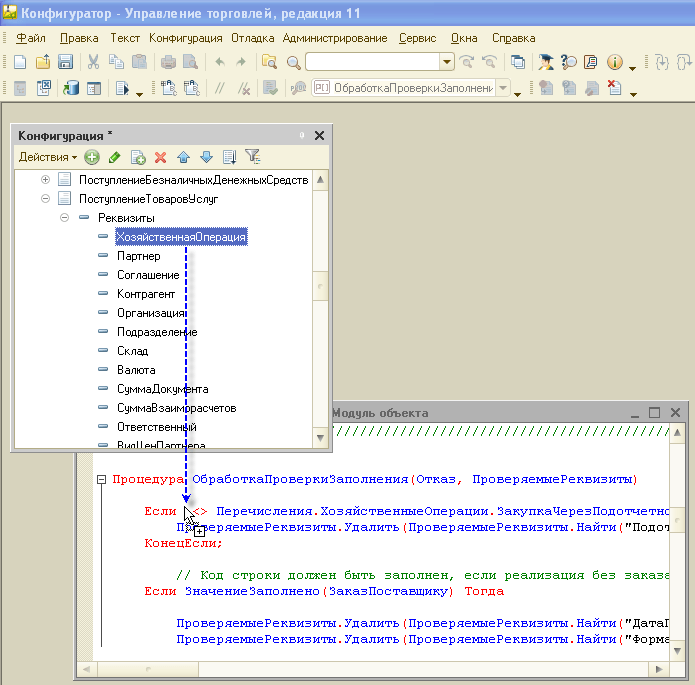
Копирование имен объектов и реквизитов
При написании текста модуля разработчик может просто перетаскивать мышью имена объектов или их реквизитов из дерева метаданных в нужное место модуля:
Проверка модуля
Редактируемый модуль может быть проверен на правильность использования синтаксических конструкций встроенного языка, корректность обращений к методам и свойствам объектов «через точку», а также на корректность некоторых параметров, имеющих тип «Строка»:
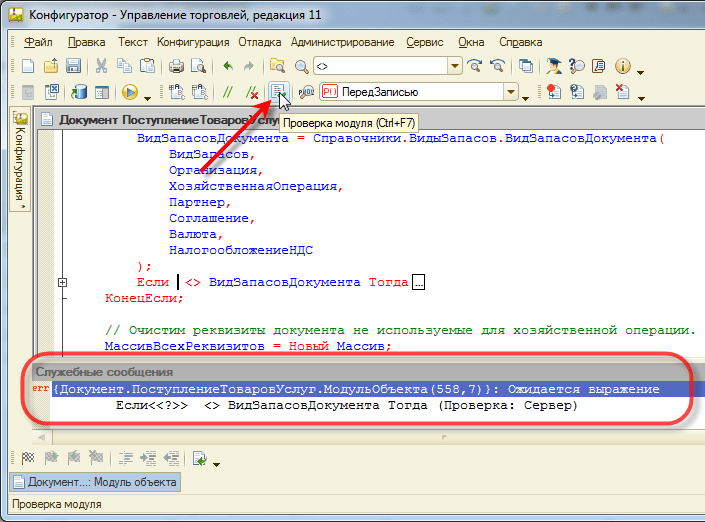
При наличии ошибок в модуле, их список выдается в окне состояния. Щелкнув мышью на сообщении об ошибке, можно перейти к строке модуля, вызвавшей ошибку. При желании разработчик может включить автоматическое выполнение синтаксического контроля модуля при его закрытии или сохранении всей конфигурации.
Кроме этого конфигуратор поддерживает выполнение полной проверки всех модулей, содержащихся в прикладном решении.
В процессе работы с модулем разработчик имеет возможность получать контекстную подсказку по встроенному языку, используя синтакс-помощник. Для этого достаточно установить курсор на интересующий элемент языка и нажатием комбинации клавиш (или по контекстному меню) перейти к описанию этого элемента языка в синтакс-помощнике.
Ограничение доступа к модулю
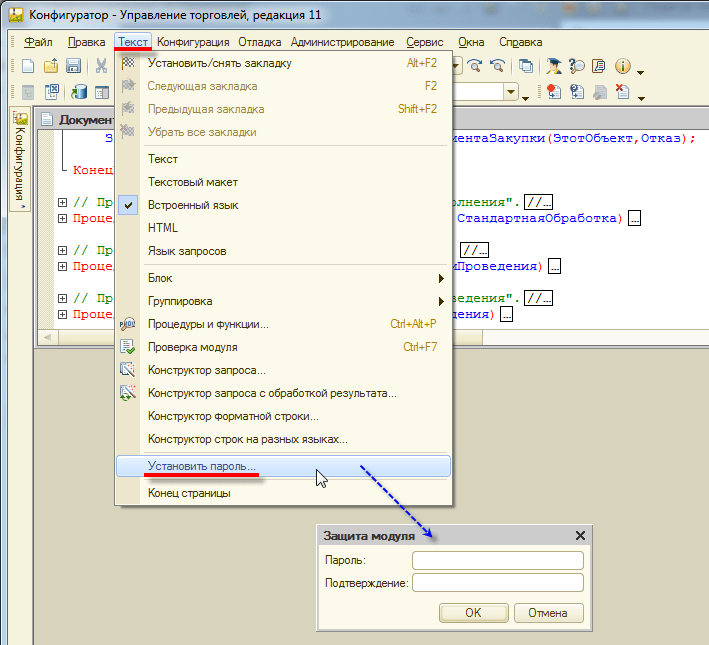
Для большинства модулей прикладного решения можно установить пароль доступа, защищающий авторские права разработчика конфигурации. При попытке открыть защищенный модуль выводится диалог ввода пароля:
Использование шаблонов
При редактировании текстовых документов и модулей конфигуратор предоставляет разработчику возможность использовать механизм шаблонов для автоматической подстановки часто используемых фрагментов текста.
Конструкции группировки в регулярных выражениях
Конструкции группирования отображают части выражений регулярных выражений и захватывают части строки входной строки. Конструкции группирования можно использовать в следующих целях.
- Совпадение с вложенным выражением, повторяющимся во входной строке.
- Применение квантификатору к части выражения с несколькими языковыми элементами регулярных выражений. Дополнительные сведения о квантификаторах см. в разделе Quantifiers.
- Включите часть выражения в строку, возвращаемую методами Regex.Replace и Match.Result .
- Извлечение отдельных частей выражения из свойства Match.Groups и обработка их по отдельности от всего текста.
В следующей таблице перечислены конструкции группирования, поддерживаемые подсистемой регулярных выражений .NET, и указано, являются ли они перехватываемые или не захватываемые.
| Конструкция группирования | Захватываемая или незахватываемая |
|---|---|
| Сопоставляемые части выражения | Захватываемая |
| Именованные сопоставленные части выражения | Захватываемая |
| Сбалансированные определения группы | Захватываемая |
| Незахватываемые группы | Незахватываемая |
| Параметры группы | Незахватываемая |
| Утверждения положительного просмотра вперед нулевой ширины | Незахватываемая |
| Утверждения отрицательного просмотра вперед нулевой ширины | Незахватываемая |
| Утверждения положительного просмотра назад нулевой ширины | Незахватываемая |
| Утверждения отрицательного просмотра назад нулевой ширины | Незахватываемая |
| Атомарные группы | Незахватываемая |
Сведения о группах и объектной модели регулярных выражений см. в разделе Конструкции группирования и объекты регулярных выражений.
Сопоставляемые части выражения
Следующая конструкция группирования выделяет сопоставленную часть выражения:
Здесь subexpression — это любой допустимый шаблон регулярного выражения. Записи, использующие круглые скобки, нумеруются автоматически слева направо в зависимости от порядка открывающих круглых скобок в регулярном выражении, начиная с 1. Однако именованные группы записи всегда упорядочены последними после неимянных групп записи. Запись с нумерованным номером 0 — это текст, соответствующий всему шаблону регулярного выражения.
По умолчанию языковой элемент ( часть выражения ) выделяет сопоставленную часть выражения. Но если RegexOptions параметр метода сопоставления шаблонов регулярных выражений включает RegexOptions.ExplicitCapture флаг или параметр n применяется к этой части выражения (см. раздел Параметры группы далее в этой статье), сопоставленное выражение не фиксируется.
Доступ к захватываемым группам можно получить четырьмя способами:
- Используя конструкцию обратной ссылки в регулярном выражении. Сопоставленная часть выражения указывается в том же регулярном выражении с помощью синтаксиса \ number, где number — это порядковый номер выделенной части выражения.
- Используя именованную конструкцию обратной ссылки в регулярном выражении. Сопоставленная часть выражения указывается в том же регулярном выражении с помощью синтаксиса \k< name > , где name — это имя захватываемой группы, или \k< number > , где number — это порядковый номер захватываемой группы. Имя захватываемой группы по умолчанию совпадает с ее порядковым номером. Дополнительные сведения см. в разделе Именованные сопоставляемые части выражения далее в этой статье.
- Используя последовательность замены $ number в вызове метода Regex.Replace или Match.Result , где number — это порядковый номер выделенной части выражения.
- Программным способом, используя объект GroupCollection , возвращаемый свойством Match.Groups . Член коллекции в нулевой позиции представляет все сопоставление регулярного выражения. Каждый последующий член представляет сопоставленную часть выражения. Дополнительные сведения см. в разделе Grouping Constructs and Regular Expression Objects .
В следующем примере показано регулярное выражение, которое определяет повторяющиеся слова в тексте. Две захватываемые группы шаблона регулярного выражения представляют два экземпляра повторяющегося слова. Второй экземпляр выделяется для определения его начальной позиции во входной строке.
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string pattern = @"(\w+)\s(\1)\W"; string input = "He said that that was the the correct answer."; foreach (Match match in Regex.Matches(input, pattern, RegexOptions.IgnoreCase)) Console.WriteLine("Duplicate '' found at positions and .", match.Groups[1].Value, match.Groups[1].Index, match.Groups[2].Index); > > // The example displays the following output: // Duplicate 'that' found at positions 8 and 13. // Duplicate 'the' found at positions 22 and 26. Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "(\w+)\s(\1)\W" Dim input As String = "He said that that was the the correct answer." For Each match As Match In Regex.Matches(input, pattern, RegexOptions.IgnoreCase) Console.WriteLine("Duplicate '' found at positions and .", _ match.Groups(1).Value, match.Groups(1).Index, match.Groups(2).Index) Next End Sub End Module ' The example displays the following output: ' Duplicate 'that' found at positions 8 and 13. ' Duplicate 'the' found at positions 22 and 26. Шаблон регулярного выражения выглядит следующим образом:
В следующей таблице показано, как интерпретируется шаблон регулярного выражения.
| Шаблон | Описание |
|---|---|
| (\w+) | Совпадение с одним или несколькими символами слова. Это первая группа записи. |
| \s | Соответствует пробелу. |
| (\1) | Сопоставление строки в первой захватываемой группе. Это вторая группа записи. Этот пример назначает ее захватываемой группе таким образом, что начальную позицию повторяющегося слова можно извлечь из свойства Match.Index . |
| \W | Сопоставление несловообразующего символа, включая пробел и знак пунктуации. Это не позволяет шаблону регулярного выражения сопоставить слово, которое начинается со слова из первой захватываемой группы. |
Именованные сопоставленные части выражения
Следующая конструкция группировки выделяет сопоставленную часть выражения и позволяет получить к ней доступ по имени или номеру:
Здесь name — это допустимое имя группы, а subexpression — любой допустимый шаблон регулярного выражения. Параметримя не должен содержать знаки пунктуации и не может начинаться с цифры.
Если параметр RegexOptions метода сопоставления шаблона регулярного выражения содержит флаг RegexOptions.ExplicitCapture или к части выражения применен параметр n (см. Параметры группы далее в этой статье), выделить часть выражения можно только с помощью явного имени захватываемых групп.
Доступ к именованным захватываемым группам можно получить следующими способами:
- Используя именованную конструкцию обратной ссылки в регулярном выражении. Сопоставленная часть выражения указывается в том же регулярном выражении с помощью синтаксиса \k< name > , где name — это имя захватываемой части выражения.
- Используя конструкцию обратной ссылки в регулярном выражении. Сопоставленная часть выражения указывается в том же регулярном выражении с помощью синтаксиса \ number, где number — это порядковый номер выделенной части выражения. Именованные сопоставленные части выражения нумеруются последовательно слева направо после сопоставленных частей выражения.
- Используя последовательность замены $< name > в вызове метода Regex.Replace или Match.Result , где name — это имя захватываемой части выражения.
- Используя последовательность замены $ число в вызове метода Regex.Replace или Match.Result, где число обозначает порядковый номер захваченной части выражения.
- Программным способом, используя объект GroupCollection , возвращаемый свойством Match.Groups . Член коллекции в нулевой позиции представляет все сопоставление регулярного выражения. Каждый последующий член представляет сопоставленную часть выражения. Именованные захватываемые группы хранятся в коллекции после нумерованных захватываемых групп.
- Программно, передавая имя части выражения индексатору объекта GroupCollection (в C#) или свойству Item[] (в Visual Basic).
В простом шаблоне регулярного выражения показано, как нумерованные (безымянные) и именованные группы можно указывать программно или с помощью языка регулярных выражений. Регулярное выражение ((?abc)\d+)?(?xyz)(.*) формирует следующие захватываемые группы по номеру и имени. Первая захватываемая группа (с номером 0) всегда указывает на весь шаблон. (Именованные группы всегда упорядочены последними.)
| number | name | Шаблон |
|---|---|---|
| 0 | 0 (имя по умолчанию) | ((?abc)\d+)?(?xyz)(.*) |
| 1 | 1 (имя по умолчанию) | ((?abc)\d+) |
| 2 | 2 (имя по умолчанию) | (.*) |
| 3 | Один | (?abc) |
| 4 | Два | (?xyz) |
В следующем примере показано регулярное выражение, которое определяет повторяющиеся слова и слова, которые следуют за каждым повторяющимся словом. Шаблон регулярного выражения определяет две именованные части выражения: duplicateWord , которая представляет повторяющееся слово, и nextWord , представляющую слово, следующее за повторяющимся словом.
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string pattern = @"(?\w+)\s\k\W(?\w+)"; string input = "He said that that was the the correct answer."; foreach (Match match in Regex.Matches(input, pattern, RegexOptions.IgnoreCase)) Console.WriteLine("A duplicate '' at position is followed by ''.", match.Groups["duplicateWord"].Value, match.Groups["duplicateWord"].Index, match.Groups["nextWord"].Value); > > // The example displays the following output: // A duplicate 'that' at position 8 is followed by 'was'. // A duplicate 'the' at position 22 is followed by 'correct'. Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "(?\w+)\s\k\W(?\w+)" Dim input As String = "He said that that was the the correct answer." Console.WriteLine(Regex.Matches(input, pattern, RegexOptions.IgnoreCase).Count) For Each match As Match In Regex.Matches(input, pattern, RegexOptions.IgnoreCase) Console.WriteLine("A duplicate '' at position is followed by ''.", _ match.Groups("duplicateWord").Value, match.Groups("duplicateWord").Index, _ match.Groups("nextWord").Value) Next End Sub End Module ' The example displays the following output: ' A duplicate 'that' at position 8 is followed by 'was'. ' A duplicate 'the' at position 22 is followed by 'correct'. Шаблон регулярного выражения выглядит следующим образом:
В следующей таблице показано, как интерпретируется регулярное выражение.
| Шаблон | Описание |
|---|---|
| (?\w+) | Совпадение с одним или несколькими символами слова. Установка для группы имени duplicateWord . |
| \s | Соответствует пробелу. |
| \k | Сопоставление строки из захватываемой группы с именем duplicateWord . |
| \W | Сопоставление несловообразующего символа, включая пробел и знак пунктуации. Это не позволяет шаблону регулярного выражения сопоставить слово, которое начинается со слова из первой захватываемой группы. |
| (?\w+) | Совпадение с одним или несколькими символами слова. Установка для группы имени nextWord . |
Имя группы может повторяться в регулярном выражении. Например, можно назвать несколько групп digit , как показано в следующем примере. В случае повторяющихся имен значение объекта Group определяется последней успешной записью во входной строке. Кроме того, коллекция CaptureCollection заполняется сведениями о каждой записи так же, как и в случае, когда имя группы не повторяется.
В примере ниже регулярное выражение \D+(?\d+)\D+(?\d+)? включает два вхождения группы с именем digit . Первая группа с именем digit записывает одну или несколько цифр. Вторая группа с именем digit записывает нуль или одно вхождение одной или нескольких цифр. Как видно из выходных данных примера, если вторая захватывающая группа соответствует тексту, этот текст определяет значение объекта Group . Если вторая захватываемая группа не соответствует входной строке, значение последнего успешного Group совпадения определяет значение объекта .
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < String pattern = @"\D+(?\d+)\D+(?\d+)?"; String[] inputs = < "abc123def456", "abc123def" >; foreach (var input in inputs) < Match m = Regex.Match(input, pattern); if (m.Success) < Console.WriteLine("Match: ", m.Value); for (int grpCtr = 1; grpCtr < m.Groups.Count; grpCtr++) < Group grp = m.Groups[grpCtr]; Console.WriteLine("Group : ", grpCtr, grp.Value); for (int capCtr = 0; capCtr < grp.Captures.Count; capCtr++) Console.WriteLine(" Capture : ", capCtr, grp.Captures[capCtr].Value); > > else < Console.WriteLine("The match failed."); >Console.WriteLine(); > > > // The example displays the following output: // Match: abc123def456 // Group 1: 456 // Capture 0: 123 // Capture 1: 456 // // Match: abc123def // Group 1: 123 // Capture 0: 123 Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "\D+(?\d+)\D+(?\d+)?" Dim inputs() As String = For Each input As String In inputs Dim m As Match = Regex.Match(input, pattern) If m.Success Then Console.WriteLine("Match: ", m.Value) For grpCtr As Integer = 1 to m.Groups.Count - 1 Dim grp As Group = m.Groups(grpCtr) Console.WriteLine("Group : ", grpCtr, grp.Value) For capCtr As Integer = 0 To grp.Captures.Count - 1 Console.WriteLine(" Capture : ", capCtr, grp.Captures(capCtr).Value) Next Next Else Console.WriteLine("The match failed.") End If Console.WriteLine() Next End Sub End Module ' The example displays the following output: ' Match: abc123def456 ' Group 1: 456 ' Capture 0: 123 ' Capture 1: 456 ' ' Match: abc123def ' Group 1: 123 ' Capture 0: 123 В следующей таблице показано, как интерпретируется регулярное выражение.
| Шаблон | Описание |
|---|---|
| \D+ | Совпадение с одной или несколькими недесятичными цифрами. |
| (?\d+) | Совпадение с одной или несколькими десятичными цифрами. Назначение соответствия для группы с именем digit . |
| \D+ | Совпадение с одной или несколькими недесятичными цифрами. |
| (?\d+)? | Совпадение с нулем или одним вхождением одной или нескольких десятичных цифр. Назначение соответствия для группы с именем digit . |
Сбалансированные определения группы
Сбалансированное определение группы удаляет определение ранее заданной группы и сохраняет в текущей группе интервал между предыдущей и текущей группами. Конструкция группировки использует следующий формат:
Здесь name1 — это текущая группа (необязательно), name2 — ранее определенная группа, а часть выражения — любой допустимый шаблон регулярного выражения. Это сбалансированное определение группы удаляет определение name2 и сохраняет интервал между name2 и name1 в name1. Если группа name2 не определена, для соответствия выполняется обратный поиск. Так как удаление последнего определения name2 предоставляет доступ к предыдущему определению name2, эта конструкция позволяет использовать стек выделений для группы name2 в качестве счетчика вложенный конструкций, например круглых скобок или открывающих и закрывающих квадратных скобок.
Сбалансированное определение группы использует в качестве стека name2 . Начальный символ каждой вложенной конструкции размещается в группе и в коллекции Group.Captures . При сопоставлении закрывающего символа соответствующий открывающий символ удаляется из группы, а коллекция Captures уменьшается на один элемент. После сопоставления открывающих и закрывающих символов всех вложенных конструкций, группа name2 оказывается пустой.
Если изменить регулярное выражение в следующем примере для использования соответствующего открывающего и закрывающего символа вложенной конструкции, вы сможете использовать его для обработки большинства вложенных конструкций, таких как математические выражения или строки программного кода, которые могут содержать множества вложенных вызовов методов.
В следующем примере определение группы балансировки используется для сопоставления левых и правых угловых скобок (<>) во входной строке. В примере определены две именованные группы, Open и Close , которые используются как стек для отслеживания соответствующих пар угловых скобок. Каждая выделенная левая угловая скобка помещается в коллекцию группы Open , а каждая выделенная правая угловая скобка помещается в коллекцию группы Close . Сбалансированное определение группы позволяет убедиться, что для каждой левой угловой скобки существует соответствующая правая угловая скобка. В противном случае последний подшаблон, (?(Open)(?!)) , вычисляется, только если группа Open не пуста (следовательно, все вложенные конструкции не закрыты). Если последний подшаблон вычисляется, сопоставление вызывает ошибку, так как подшаблон (?!) является утверждением отрицательного поиска вперед нулевой ширины, которое всегда возвращает ошибку.
using System; using System.Text.RegularExpressions; class Example < public static void Main() < string pattern = "^[^<>]*" + "(" + "((?'Open'<)[^<>]*)+" + "((?'Close-Open'>)[^<>]*)+" + ")*" + "(?(Open)(?!))$"; string input = ">"; Match m = Regex.Match(input, pattern); if (m.Success == true) < Console.WriteLine("Input: \"\" \nMatch: \"\"", input, m); int grpCtr = 0; foreach (Group grp in m.Groups) < Console.WriteLine(" Group : ", grpCtr, grp.Value); grpCtr++; int capCtr = 0; foreach (Capture cap in grp.Captures) < Console.WriteLine(" Capture : ", capCtr, cap.Value); capCtr++; > > > else < Console.WriteLine("Match failed."); >> > // The example displays the following output: // Input: ">" // Match: ">" // Group 0: > // Capture 0: > // Group 1: > // Capture 0: // Capture 1: > // Group 2: // Capture 0: > // Capture 1: > // Capture 2: > // Group 4: // Group 5: mno // Capture 0: abc // Capture 1: xyz // Capture 2: mno
Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "^[^<>]*" & _ "(" + "((?'Open'<)[^<>]*)+" & _ "((?'Close-Open'>)[^<>]*)+" + ")*" & _ "(?(Open)(?!))$" Dim input As String = ">" Dim rgx AS New Regex(pattern) ' Dim m As Match = Regex.Match(input, pattern) If m.Success Then Console.WriteLine("Input: """" " & vbCrLf & "Match: """"", _ input, m) Dim grpCtr As Integer = 0 For Each grp As Group In m.Groups Console.WriteLine(" Group : ", grpCtr, grp.Value) grpCtr += 1 Dim capCtr As Integer = 0 For Each cap As Capture In grp.Captures Console.WriteLine(" Capture : ", capCtr, cap.Value) capCtr += 1 Next Next Else Console.WriteLine("Match failed.") End If End Sub End Module ' The example displays the following output: ' Input: ">" ' Match: ">" ' Group 0: > ' Capture 0: > ' Group 1: > ' Capture 0: ' Capture 1: > ' Group 2: ' Capture 0: > ' Capture 1: > ' Capture 2: > ' Group 4: ' Group 5: mno ' Capture 0: abc ' Capture 1: xyz ' Capture 2: mno
Шаблон регулярного выражения выглядит следующим образом:
Регулярное выражение интерпретируется следующим образом:
| Шаблон | Описание |
|---|---|
| ^ | Начало с первого символа строки. |
| [^<>]* | Сопоставление нуля или большего числа символов, которые не являются правой или левой угловой скобкой. |
| (?’Open’ <) | Сопоставление левой угловой скобки и ее назначение группе Open . |
| [^<>]* | Сопоставление нуля или большего числа символов, которые не являются правой или левой угловой скобкой. |
| ((?’Open’<)[^<>]*)+ | Сопоставление одного или нескольких вхождений левой угловой скобки, за которой следует ноль или больше символов, не являющихся левой или правой угловой скобкой. Это вторая группа записи. |
| (?’Close-Open’>) | Сопоставление правой угловой скобки, назначение подстроки между группой Open и текущей группой группе Close и удаление определения группы Open . |
| [^<>]* | Сопоставление нуля или большего числа вхождений любого символа, не являющегося левой или правой угловой скобкой. |
| ((?’Close-Open’>)[^<>]*)+ | Сопоставление одного или нескольких вхождений правой угловой скобки, за которой следует ноль или больше символов, не являющихся левой или правой угловой скобкой. При сопоставлении правой угловой скобки подстрока между группой Open и текущей группой назначается группе Close , а определение группы Open удаляется. Это третья группа записи. |
| (((?’Open’<)[^<>]*)+((?’Close-Open’>)[^<>]*)+)* | Сопоставление нуля или большего числа вхождений следующего шаблона: одно или несколько вхождений левой угловой скобки, за которой следуют ноль или большее число символов, отличных от угловых скобок, одно или несколько вхождений правой угловой скобки и ноль или большее число символов, отличных от угловых скобок. При сопоставлении правой угловой скобки определение группы Open удаляется, а подстрока между группой Open и текущей группой назначается группе Close . Это первая группа записи. |
| (?(Open)(?!)) | Если группа Open существует, поиск совпадения прекращается, если возможно сопоставление пустой строки, но позиция механизма регулярных выражений в строке не изменяется. Это утверждение отрицательного просмотра вперед нулевой ширины. Так как пустая строка всегда неявно присутствует во входной строке, это сопоставление всегда возвращает ошибку. Ошибка этого сопоставления указывает на то, что угловые скобки не сбалансированы. |
| $ | Соответствует концу входной строки. |
Последняя часть выражения, (?(Open)(?!)) , указывает, правильно ли сбалансированы вложенные конструкции во входной строке (например, существует ли для каждой левой угловой скобки соответствующая правая угловая скобка). В ней используется условное сопоставление на основе действительной захватываемой группы. Дополнительные сведения см. в разделе Конструкции изменения в регулярных выражениях. Если группа Open определена, механизм регулярных выражений пытается сопоставить часть выражения (?!) во входной строке. Группа Open должна быть определена, только если вложенные конструкции не сбалансированы. Поэтому шаблон для сопоставления во входной строке должен всегда вызывать ошибку соответствия. В этом случае (?!) — это утверждение отрицательного просмотра вперед нулевой ширины, которое всегда вызывает ошибку, так как пустая строка всегда неявно присутствует в следующей позиции во входной строке.
В этом примере обработчик регулярных выражений вычисляет входную строку «>», как показано в следующей таблице.
| Шаг | Шаблон | Результат |
|---|---|---|
| 1 | ^ | Начало соответствия в начале входной строки. |
| 2 | [^<>]* | Поиск символов, отличных от угловых скобок, до левой угловой скобки. Совпадения не найдены. |
| 3 | (((?’Open’ <) | Соответствует левой угловой скобке в abc<> и назначает ее Open группе. |
| 4 | [^<>]* | Сопоставляется строка «abc». |
| 5 | )+ | « |
Незахватываемые группы
Следующая конструкция группирования не захватывает подстроку, соответствующую вложенному выражению:
Здесь subexpression — это любой допустимый шаблон регулярного выражения. Незахватываемая конструкция группировки обычно используется, если к группе применяется квантификатор, но подстроки, выделенные группой, не представляют интереса.
Если регулярное выражение содержит вложенные конструкции группировки, внешняя незахватываемая конструкция группировки не применяется к внутренним вложенным конструкциям группировки.
В следующем примере показано регулярное выражение, содержащее незахватываемые группы. Обратите внимание, что результат не содержит захватываемые группы.
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string pattern = @"(?:\b(?:\w+)\W*)+\."; string input = "This is a short sentence."; Match match = Regex.Match(input, pattern); Console.WriteLine("Match: ", match.Value); for (int ctr = 1; ctr < match.Groups.Count; ctr++) Console.WriteLine(" Group : ", ctr, match.Groups[ctr].Value); > > // The example displays the following output: // Match: This is a short sentence. Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "(?:\b(?:\w+)\W*)+\." Dim input As String = "This is a short sentence." Dim match As Match = Regex.Match(input, pattern) Console.WriteLine("Match: ", match.Value) For ctr As Integer = 1 To match.Groups.Count - 1 Console.WriteLine(" Group : ", ctr, match.Groups(ctr).Value) Next End Sub End Module ' The example displays the following output: ' Match: This is a short sentence. Регулярное выражение (?:\b(?:\w+)\W*)+\. сопоставляет предложение, которое заканчивается точкой. Так как оно ищет предложения, а не отдельные слова, конструкции группировки используются только как квантификаторы. Возможные интерпретации шаблона регулярного выражения показаны в следующей таблице.
| Шаблон | Описание |
|---|---|
| \b | Совпадение должно начинаться на границе слова. |
| (?:\w+) | Совпадение с одним или несколькими символами слова. Сопоставленные текст не назначается захватываемой группе. |
| \W* | Совпадение с нулем или большим числом несловообразующих символов. |
| (?:\b(?:\w+)\W*)+ | Совпадение шаблона с одним или несколькими словообразующими символами начиная с границы слова, за которыми следует ноль и более несловообразующих символов, один или более раз. Сопоставленные текст не назначается захватываемой группе. |
| \. | Сопоставляется точка. |
Параметры группы
Следующая конструкция группировки применяет или отключает указанные параметры в части выражения:
Здесь subexpression — это любой допустимый шаблон регулярного выражения. Например, (?i-s:) отключает учет регистра и однострочный режим. Дополнительные сведения о доступных встроенных параметрах см. в разделе Параметры регулярных выражений.
Вы можете указать параметры, которые применяются ко всему регулярному выражению, а не его части, используя конструктор класса System.Text.RegularExpressions.Regex или статичный метод. Также можно указать встроенные параметры, которые применяются после определенной точки в регулярном выражении с использованием языковой конструкции (?imnsx-imnsx) .
Конструкция параметров группы не является захватываемой группой. Это значит, что несмотря на то, что любая часть строки, захватываемая частью выражения , включается в соответствие, она не добавляется в захватываемую группу и не используется для заполнения объекта GroupCollection .
Например, регулярное выражение \b(?ix: d \w+)\s в следующем примере использует встроенные параметры в конструкции группировки, чтобы включить сопоставление без учета регистра и игнорировать пробелы при определении слов, начинающихся с буквы «d». Определение регулярного выражения показано в следующей таблице.
| Шаблон | Описание |
|---|---|
| \b | Совпадение должно начинаться на границе слова. |
| (?ix: d \w+) | Выполняется сопоставление буквы «d», за которой следует один или более словообразующих символов без учета регистра, пробелы в шаблоне пропускаются. |
| \s | Соответствует пробелу. |
string pattern = @"\b(?ix: d \w+)\s"; string input = "Dogs are decidedly good pets."; foreach (Match match in Regex.Matches(input, pattern)) Console.WriteLine("'// found at index .", match.Value, match.Index); // The example displays the following output: // 'Dogs // found at index 0. // 'decidedly // found at index 9. Dim pattern As String = "\b(?ix: d \w+)\s" Dim input As String = "Dogs are decidedly good pets." For Each match As Match In Regex.Matches(input, pattern) Console.WriteLine("'' found at index .", match.Value, match.Index) Next ' The example displays the following output: ' 'Dogs ' found at index 0. ' 'decidedly ' found at index 9. Утверждения положительного просмотра вперед нулевой ширины
Следующая конструкция группировки определяет утверждение положительного просмотра вперед нулевой ширины:
Здесь subexpression — это любой шаблон регулярного выражения. Для успешного сопоставления входная строка должна соответствовать шаблону регулярного выражения в части выражения, хотя сопоставленная подстрока не включается в результат сопоставления. Утверждение положительного просмотра вперед нулевой ширины не выполняет обратный поиск.
Обычно утверждение положительного просмотра вперед нулевой ширины находится в конце шаблона регулярного выражения. Оно определяет подстроку, которую необходимо найти в конце строки для сопоставления, но которая не включается в сопоставление. Это также полезно для предотвращения излишнего обратного поиска. Утверждение положительного просмотра вперед нулевой ширины можно использовать, чтобы определенная захватываемая группа начиналась с текста, соответствующего подмножеству шаблона, заданного для этой группы. Например, если захватываемая группа соответствует последовательным словообразующим символом, вы можете использовать утверждение положительного просмотра вперед нулевой ширины, чтобы указать, что первый символ должен быть прописной буквой.
Следующий пример использует утверждение положительного просмотра вперед нулевой ширины для сопоставления слова, которое идет перед глаголом «is» во входной строке.
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string pattern = @"\b\w+(?=\sis\b)"; string[] inputs = < "The dog is a Malamute.", "The island has beautiful birds.", "The pitch missed home plate.", "Sunday is a weekend day." >; foreach (string input in inputs) < Match match = Regex.Match(input, pattern); if (match.Success) Console.WriteLine("'' precedes 'is'.", match.Value); else Console.WriteLine("'' does not match the pattern.", input); > > > // The example displays the following output: // 'dog' precedes 'is'. // 'The island has beautiful birds.' does not match the pattern. // 'The pitch missed home plate.' does not match the pattern. // 'Sunday' precedes 'is'. Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "\b\w+(?=\sis\b)" Dim inputs() As String = For Each input As String In inputs Dim match As Match = Regex.Match(input, pattern) If match.Success Then Console.WriteLine("'' precedes 'is'.", match.Value) Else Console.WriteLine("'' does not match the pattern.", input) End If Next End Sub End Module ' The example displays the following output: ' 'dog' precedes 'is'. ' 'The island has beautiful birds.' does not match the pattern. ' 'The pitch missed home plate.' does not match the pattern. ' 'Sunday' precedes 'is'. Возможные интерпретации регулярного выражения \b\w+(?=\sis\b) показаны в следующей таблице.
| Шаблон | Описание |
|---|---|
| \b | Совпадение должно начинаться на границе слова. |
| \w+ | Совпадение с одним или несколькими символами слова. |
| (?=\sis\b) | Определяется, следуют ли за словообразующими словами пробел и строка «is», которая оканчивается на границе слова. Если это так, совпадение успешно. |
Утверждения отрицательного просмотра вперед нулевой ширины
Следующая конструкция группировки определяет утверждение отрицательного просмотра вперед нулевой ширины:
Здесь часть выражения — это любой шаблон регулярного выражения. Для успешного сопоставления входная строка не должна соответствовать шаблону регулярного выражения в части выражения, хотя сопоставленная подстрока не включается в результат сопоставления.
Утверждение отрицательного просмотра вперед нулевой ширины обычно используется в начале или в конце регулярного выражения. В начале регулярного выражения оно может определить шаблон, для которого не должно быть совпадения, когда в начале регулярного выражения определен похожий, но более общий шаблон для сопоставления. В этом случае утверждение часто используется для ограничения обратного поиска. В конце регулярного выражения утверждение может определять часть выражения, которое не должно присутствовать в конце совпадения.
В следующем примере определяется регулярное выражение, использующее утверждение просмотра вперед нулевой ширины в начале регулярного выражения для сопоставления слов, которые не начинаются на «un».
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string pattern = @"\b(?!un)\w+\b"; string input = "unite one unethical ethics use untie ultimate"; foreach (Match match in Regex.Matches(input, pattern, RegexOptions.IgnoreCase)) Console.WriteLine(match.Value); >> // The example displays the following output: // one // ethics // use // ultimate Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "\b(?!un)\w+\b" Dim input As String = "unite one unethical ethics use untie ultimate" For Each match As Match In Regex.Matches(input, pattern, RegexOptions.IgnoreCase) Console.WriteLine(match.Value) Next End Sub End Module ' The example displays the following output: ' one ' ethics ' use ' ultimate Возможные интерпретации регулярного выражения \b(?!un)\w+\b показаны в следующей таблице.
| Шаблон | Описание |
|---|---|
| \b | Совпадение должно начинаться на границе слова. |
| (?!un) | Определяется, являются ли два следующих символа «un». Если это не так, сопоставление возможно. |
| \w+ | Совпадение с одним или несколькими символами слова. |
| \b | Совпадение должно заканчиваться на границе слова. |
В следующем примере определяется регулярное выражение, использующее утверждение просмотра вперед нулевой ширины в конце регулярного выражения для сопоставления слов, которые не начинаются на знак пунктуации.
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string pattern = @"\b\w+\b(?!\p)"; string input = "Disconnected, disjointed thoughts in a sentence fragment."; foreach (Match match in Regex.Matches(input, pattern)) Console.WriteLine(match.Value); > > // The example displays the following output: // disjointed // thoughts // in // a // sentence Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "\b\w+\b(?!\p)" Dim input As String = "Disconnected, disjointed thoughts in a sentence fragment." For Each match As Match In Regex.Matches(input, pattern) Console.WriteLine(match.Value) Next End Sub End Module ' The example displays the following output: ' disjointed ' thoughts ' in ' a ' sentence Возможные интерпретации регулярного выражения \b\w+\b(?!\p) показаны в следующей таблице.
| Шаблон | Описание |
|---|---|
| \b | Совпадение должно начинаться на границе слова. |
| \w+ | Совпадение с одним или несколькими символами слова. |
| \b | Совпадение должно заканчиваться на границе слова. |
| \p) | Если следующий символ — не знак пунктуации (например, точка или запятая), сопоставление выполняется успешно. |
Утверждения положительного просмотра назад нулевой ширины
Следующая конструкция группировки определяет утверждение положительного просмотра назад нулевой ширины:
Здесь часть выражения — это любой шаблон регулярного выражения. Для успешного сопоставления часть выражения должна содержаться во входной строке слева от текущей позиции, хотя subexpression не включается в результат. Утверждение положительного просмотра назад нулевой ширины не выполняет обратный поиск.
Утверждения положительного просмотра назад нулевой ширины обычно используются в начале регулярных выражений. Определяемый ими шаблон — это предварительное условие сопоставления, но не часть результата сопоставления.
Например, следующий пример сопоставляет две последних цифры года для 21-го века (т. е. сопоставляемой строке должны предшествовать цифры «20»).
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string input = "2010 1999 1861 2140 2009"; string pattern = @"(?<=\b20)\d<2>\b"; foreach (Match match in Regex.Matches(input, pattern)) Console.WriteLine(match.Value); > > // The example displays the following output: // 10 // 09 Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim input As String = "2010 1999 1861 2140 2009" Dim pattern As String = "(?<=\b20)\d<2>\b" For Each match As Match In Regex.Matches(input, pattern) Console.WriteLine(match.Value) Next End Sub End Module ' The example displays the following output: ' 10 ' 09 Возможные интерпретации шаблона регулярного выражения (?<=\b20)\d<2>\b показаны в следующей таблице.
| Шаблон | Описание |
|---|---|
| \d | Совпадение с двумя десятичными цифрами. |
| (? <=\b20) | Сопоставление продолжается, если двум десятичным цифрам предшествуют десятичные цифры «20» на границе слова. |
| \b | Совпадение должно заканчиваться на границе слова. |
Утверждения положительного просмотра назад нулевой ширины также используются для ограничения обратного поиска, если последний символ или символы в захватываемой группе должны быть подмножеством символов, соответствующих шаблону регулярного выражения. Например, если группа захватывает все последовательные словообразующие символы, вы можете использовать утверждение положительного просмотра назад нулевой ширины, чтобы указать, что последний символ должен быть буквой.
Утверждения отрицательного просмотра назад нулевой ширины
Следующая конструкция группировки определяет утверждение отрицательного просмотра назад нулевой ширины:
Здесь часть выражения — это любой шаблон регулярного выражения. Для успешного сопоставления часть выражения не должна находиться во входной строке слева от текущей позиции. Однако любая подстрока, не соответствующая subexpression , не включается в результат сопоставления.
Утверждения отрицательного просмотра назад нулевой ширины обычно используются в начале регулярных выражений. Определяемый ими шаблон препятствует сопоставлению в последующей строке. Они также используются для ограничения обратного поиска, если последний символ или символы в захватываемой группе не должны соответствовать одному или нескольким символам, соответствующим шаблону регулярного выражения группы. Например, если группа захватывает все последовательные словообразующие символы, вы можете использовать утверждение отрицательного просмотра назад нулевой ширины, чтобы указать, что последний символ не должен быть символом подчеркивания (_).
Следующий пример сопоставляет дату каждого дня буднего недели (т. е. не субботы или воскресенья).
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string[] dates = < "Monday February 1, 2010", "Wednesday February 3, 2010", "Saturday February 6, 2010", "Sunday February 7, 2010", "Monday, February 8, 2010" >; string pattern = @"(?, \d\b"; foreach (string dateValue in dates) < Match match = Regex.Match(dateValue, pattern); if (match.Success) Console.WriteLine(match.Value); >> > // The example displays the following output: // February 1, 2010 // February 3, 2010 // February 8, 2010 Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim dates() As String = Dim pattern As String = "(?, \d\b" For Each dateValue As String In dates Dim match As Match = Regex.Match(dateValue, pattern) If match.Success Then Console.WriteLine(match.Value) End If Next End Sub End Module ' The example displays the following output: ' February 1, 2010 ' February 3, 2010 ' February 8, 2010 Возможные интерпретации шаблона регулярного выражения (?, \d\b показаны в следующей таблице.
| Шаблон | Описание |
|---|---|
| \b | Совпадение должно начинаться на границе слова. |
| \w+ | Сопоставляется один или несколько словообразующих символов, за которыми следует пробел. |
| \d, | Сопоставляется одна или две десятичные цифры, за которыми следует пробел и запятая. |
| \d\b | Сопоставляются 4 десятичные цифры, сопоставление прекращается на границе слова. |
| (? | Если сопоставлению предшествуют строки, отличные от «Saturday» или «Sunday», за которыми следует пробел, сопоставление выполняется успешно. |
Атомарные группы
Следующая конструкция группировки представляет атомарную группу (в некоторых других обработчиках регулярных выражений называемую частью выражения без обратного отслеживания, атомарной частью выражения или однократной частью выражения):
Здесь часть выражения — это любой шаблон регулярного выражения.
Обычно, если регулярное выражение содержит необязательный или альтернативный шаблон сопоставления, а сопоставление завершается неудачно, механизм регулярных выражений может разветвляться по разным направлениям для сопоставления входной строки с шаблоном. Если сопоставление не найдено в первой ветви, механизм регулярных выражений может вернуться к точке, где было найдено первое сопоставление и повторить попытку во второй ветви. Этот процесс может продолжаться, пока не будут обойдены все ветви.
Группа (?> часть выражения ) отключает обратное отслеживание. Механизм регулярных выражений сопоставляет максимально возможное число символов во входной строке. Если дальнейшее сопоставление невозможно, обратный поиск для применения альтернативных шаблонов не выполняется. (Т. е. часть выражения сопоставляет только строки, которые могут быть сопоставлены только частью выражения, попытка сопоставить строку на основе этой и последующих частей выражения не осуществляется.)
Этот вариант рекомендуется, если вы знаете, что обратный поиск не даст результатов. Если запретить механизму регулярных выражений выполнять ненужные операции поиска, производительность станет выше.
В следующем примере показано, как атомарная группа изменяет результаты сопоставления шаблона. Возвращающееся регулярное выражение успешно сопоставляет ряд повторяющихся символов, за которыми следует один или более экземпляров того же символа на границе слова, а невозвращающееся регулярное выражение — нет.
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string[] inputs = < "cccd.", "aaad", "aaaa" >; string back = @"(\w)\1+.\b"; string noback = @"(?>(\w)\1+).\b"; foreach (string input in inputs) < Match match1 = Regex.Match(input, back); Match match2 = Regex.Match(input, noback); Console.WriteLine(": ", input); Console.Write(" Backtracking : "); if (match1.Success) Console.WriteLine(match1.Value); else Console.WriteLine("No match"); Console.Write(" Nonbacktracking: "); if (match2.Success) Console.WriteLine(match2.Value); else Console.WriteLine("No match"); > > > // The example displays the following output: // cccd.: // Backtracking : cccd // Nonbacktracking: cccd // aaad: // Backtracking : aaad // Nonbacktracking: aaad // aaaa: // Backtracking : aaaa // Nonbacktracking: No match Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim inputs() As String = Dim back As String = "(\w)\1+.\b" Dim noback As String = "(?>(\w)\1+).\b" For Each input As String In inputs Dim match1 As Match = Regex.Match(input, back) Dim match2 As Match = Regex.Match(input, noback) Console.WriteLine(": ", input) Console.Write(" Backtracking : ") If match1.Success Then Console.WriteLine(match1.Value) Else Console.WriteLine("No match") End If Console.Write(" Nonbacktracking: ") If match2.Success Then Console.WriteLine(match2.Value) Else Console.WriteLine("No match") End If Next End Sub End Module ' The example displays the following output: ' cccd.: ' Backtracking : cccd ' Nonbacktracking: cccd ' aaad: ' Backtracking : aaad ' Nonbacktracking: aaad ' aaaa: ' Backtracking : aaaa ' Nonbacktracking: No match Определение невозвращающегося регулярного выражения (?>(\w)\1+).\b показано в следующей таблице.
| Шаблон | Описание |
|---|---|
| (\w) | Сопоставляется один словообразующий символ, который назначается первой захватываемой группе. |
| \1+ | Значение первой захваченной подстроки сопоставляется один или несколько раз. |
| . | Сопоставляется любой символ. |
| \b | Сопоставление заканчивается на границе слова. |
| (?>(\w)\1+) | Сопоставление одного или нескольких вхождений повторяющегося символа слова, но не возвращайтесь к последнему символу на границе слова. |
Конструкции группировки и объекты регулярных выражений
Подстроки, сопоставляемые захватываемой группой регулярного выражения, представлены объектами System.Text.RegularExpressions.Group , которые можно извлечь из объекта System.Text.RegularExpressions.GroupCollection , возвращаемого свойством Match.Groups . Объект GroupCollection заполняется следующим образом:
- Первый объект Group в коллекции (объект с нулевым индексом) представляет все сопоставление.
- Следующий набор объектов Group представляет неименованные (нумерованные) захватываемые группы. Они указываются в том порядке, в котором они определены в регулярном выражении, слева направо. Значения индекса этих групп лежат в диапазоне от 1 до числа неименованных захватываемых групп в коллекции. (Индекс определенной группы эквивалентен ее нумерованной обратной ссылке. Дополнительные сведения о обратных ссылках см. в разделе Конструкции обратной ссылки.)
- Последний набор объектов Group представляет именованные захватываемые группы. Они указываются в том порядке, в котором они определены в регулярном выражении, слева направо. Значение индекса первой именованной захватываемой группы на единицу больше индекса, последней неименованной захватываемой группы. Если в регулярном выражении нет неименованных захватываемых групп, индекс первой именованной захватываемой группы равен единице.
Если к захватываемой группе применяется квантификатор, соответствующие свойства Group , Capture.Valueи Capture.Indexобъекта Capture.Length отражают последнюю подстроку, выделяемую захватываемой группой. Вы можете получить полный набор подстрок, выделяемые группами с квантификаторами, из объекта CaptureCollection , возвращаемого свойством Group.Captures .
В следующем примере показана связь между объектами Group и Capture .
using System; using System.Text.RegularExpressions; public class Example < public static void Main() < string pattern = @"(\b(\w+)\W+)+"; string input = "This is a short sentence."; Match match = Regex.Match(input, pattern); Console.WriteLine("Match: ''", match.Value); for (int ctr = 1; ctr < match.Groups.Count; ctr++) < Console.WriteLine(" Group : ''", ctr, match.Groups[ctr].Value); int capCtr = 0; foreach (Capture capture in match.Groups[ctr].Captures) < Console.WriteLine(" Capture : ''", capCtr, capture.Value); capCtr++; > > > > // The example displays the following output: // Match: 'This is a short sentence.' // Group 1: 'sentence.' // Capture 0: 'This ' // Capture 1: 'is ' // Capture 2: 'a ' // Capture 3: 'short ' // Capture 4: 'sentence.' // Group 2: 'sentence' // Capture 0: 'This' // Capture 1: 'is' // Capture 2: 'a' // Capture 3: 'short' // Capture 4: 'sentence' Imports System.Text.RegularExpressions Module Example Public Sub Main() Dim pattern As String = "(\b(\w+)\W+)+" Dim input As String = "This is a short sentence." Dim match As Match = Regex.Match(input, pattern) Console.WriteLine("Match: ''", match.Value) For ctr As Integer = 1 To match.Groups.Count - 1 Console.WriteLine(" Group : ''", ctr, match.Groups(ctr).Value) Dim capCtr As Integer = 0 For Each capture As Capture In match.Groups(ctr).Captures Console.WriteLine(" Capture : ''", capCtr, capture.Value) capCtr += 1 Next Next End Sub End Module ' The example displays the following output: ' Match: 'This is a short sentence.' ' Group 1: 'sentence.' ' Capture 0: 'This ' ' Capture 1: 'is ' ' Capture 2: 'a ' ' Capture 3: 'short ' ' Capture 4: 'sentence.' ' Group 2: 'sentence' ' Capture 0: 'This' ' Capture 1: 'is' ' Capture 2: 'a' ' Capture 3: 'short' ' Capture 4: 'sentence' Шаблон регулярного выражения (\b(\w+)\W+)+ извлекает отдельные слова из строки. Определяется, как показано в следующей таблице.
| Шаблон | Описание |
|---|---|
| \b | Совпадение должно начинаться на границе слова. |
| (\w+) | Совпадение с одним или несколькими символами слова. Вместе эти символы формируют слово. Это вторая группа записи. |
| \W+ | Совпадение с одним или большим числом несловообразующих символов. |
| (\b(\w+)\W+) | Шаблон из одного или нескольких словообразующих символов, за которыми следует ноль или несколько словообразующих слов, выделяется один или несколько раз. Это первая группа записи. |
Вторая группа сопоставляет каждое слово предложения. Первая группа сопоставляет каждое слово вместе со знаками пунктуации и пробелом после слова. Объект Group с индексом 2 предоставляет сведения о тексте, сопоставленном второй группой. Полный набор слов, выделенных захватываемой группой, доступен в объекте CaptureCollection , который возвращается свойством Group.Captures .
См. также
- Элементы языка регулярных выражений — краткий справочник
- Поиск с возвратом
Совместная работа с нами на GitHub
Источник этого содержимого можно найти на GitHub, где также можно создавать и просматривать проблемы и запросы на вытягивание. Дополнительные сведения см. в нашем руководстве для участников.