Лабораторная работа № 3 Обработка статистических данных на основе приложения ms excel
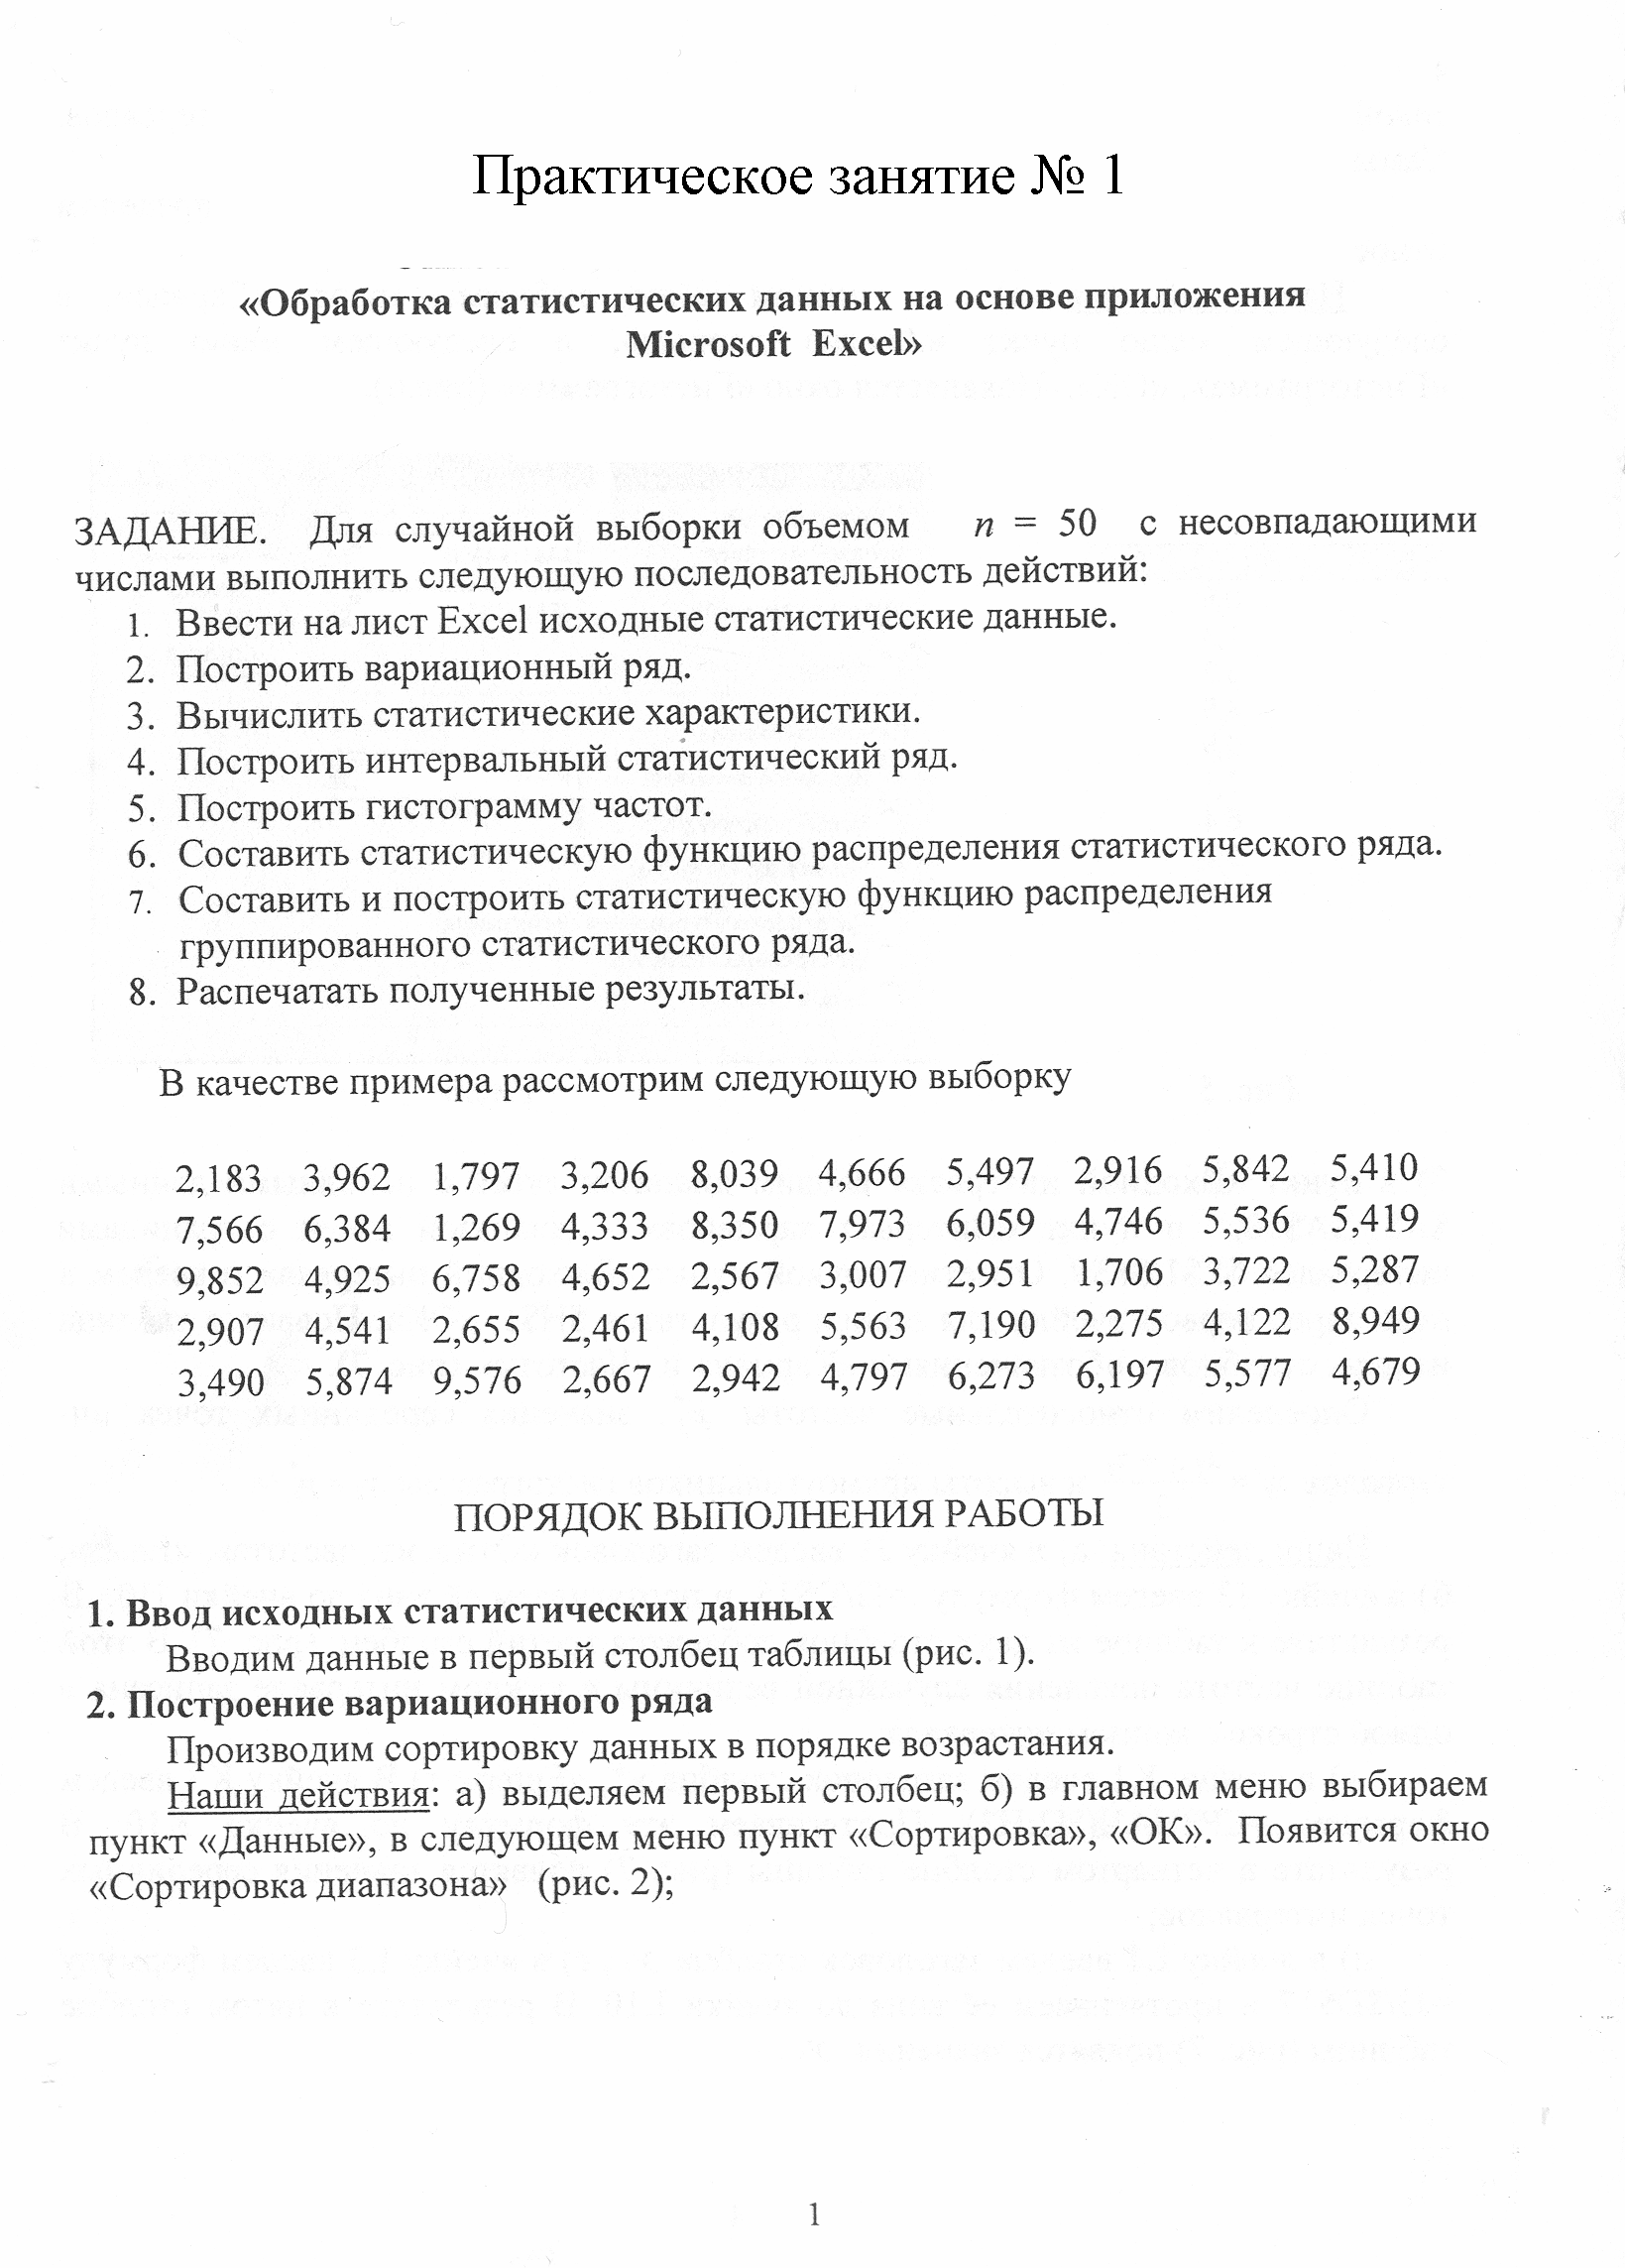
Для случайной выборки объемом n=50 с несовпадающими числами выполнить следующую последовательность действий:
1.Вывести на лист Excel исходные статистические данные.
2. Построить вариационный ряд.
3. Вычислить статистические характеристики.
4. Построить интервальный статистический ряд.
5.Построить гистограмму частот.
6. Составить статистическую функцию распределения статистического ряда.
7. Составить и постоить статистическую функцию распределения группированного статистического ряда.
В качестве примера рассмотрим следующую выборку
Порядок выполнения работы
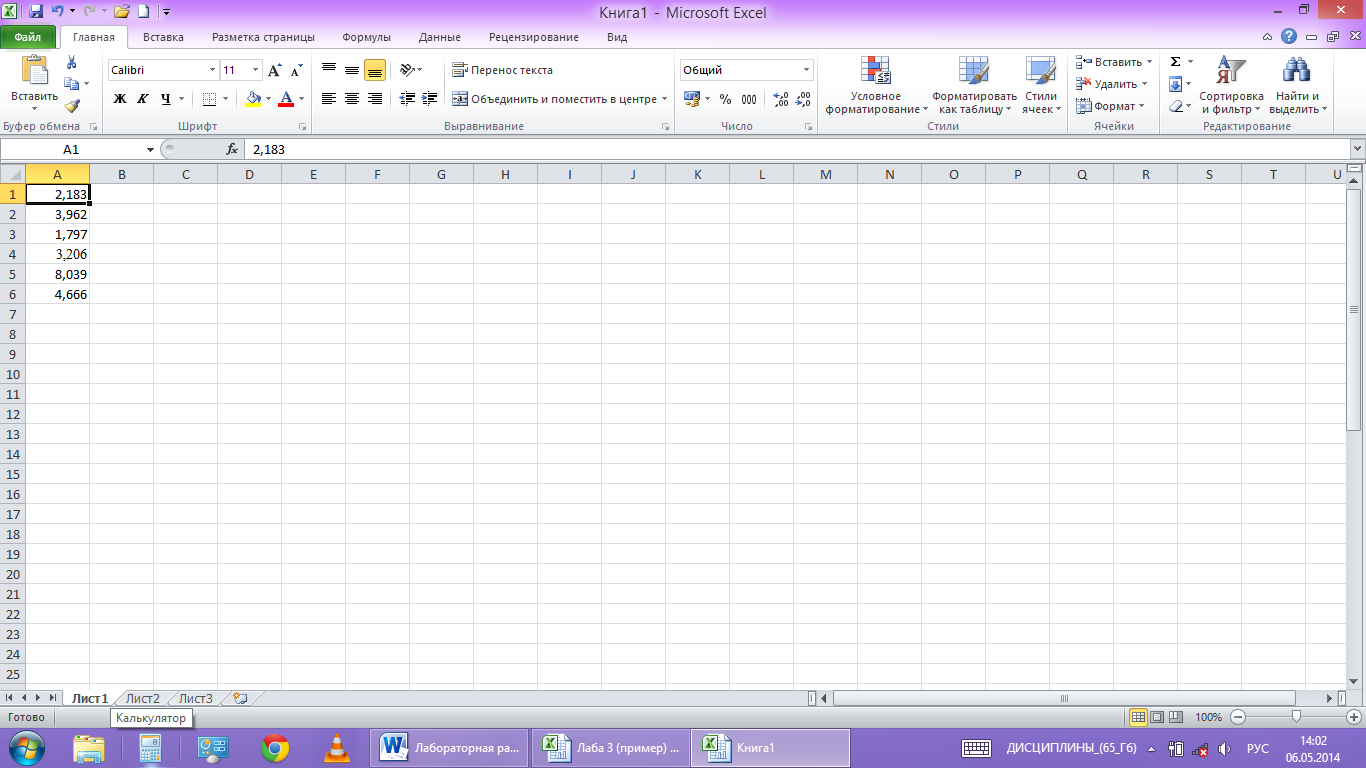
1.Ввод исходных статистических данных.
Вводим данные в первый столбец таблицы (рис.1).
2. Построение вариационного ряда.
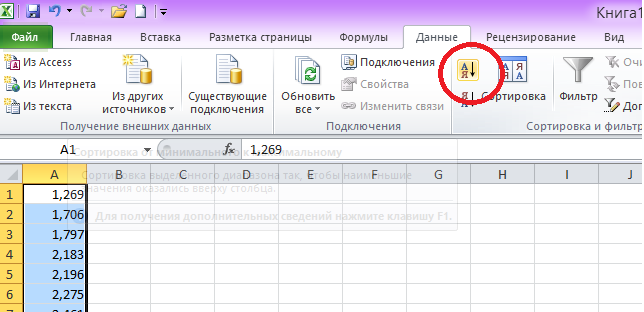
Производим сортировку данных в порядке возрастания. Для этого:
а) выделяем первый столбец;
б) на ленте во вкладке «Данные» выбираем «Сортировка и фильтр» (рис.2)
3. Вычисление статистических характеристик.
На ленте во вкладке «Данные» выбираем «Анализ данных» меню «Описательная статистика» нажимаем ОК.
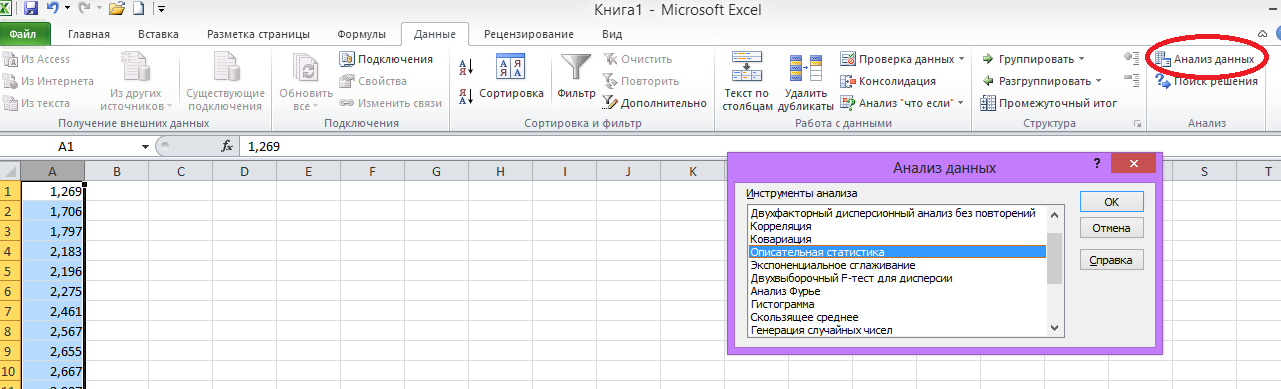
В пункт «Входной интервал» вводим диапазон ячеек с исходными данными $A$1:$A$50, а в пункте «Выходной интервал» обозначим первую ячейку для записи результаов $C$1. Ставим флажок напротив пункта «Итоговая статистика» и нажимаем ОК.(рис.4)
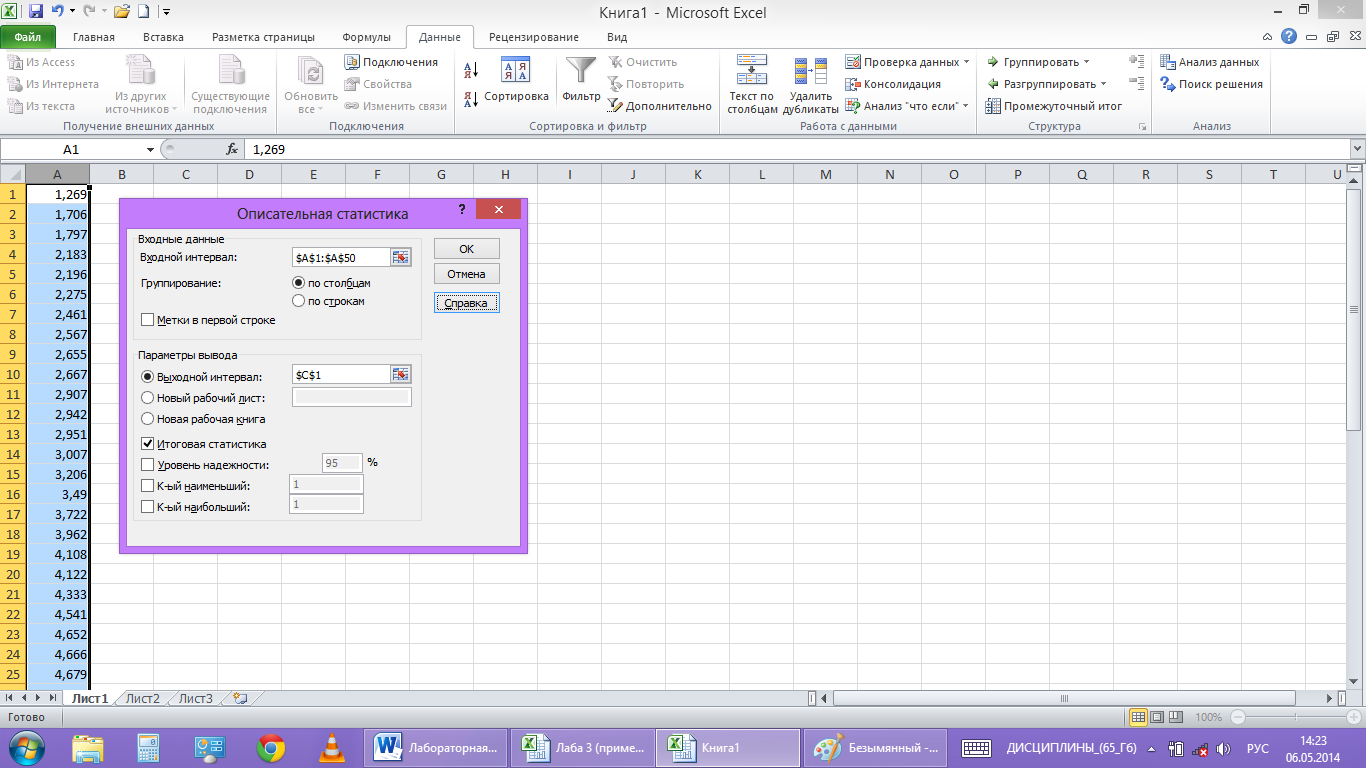
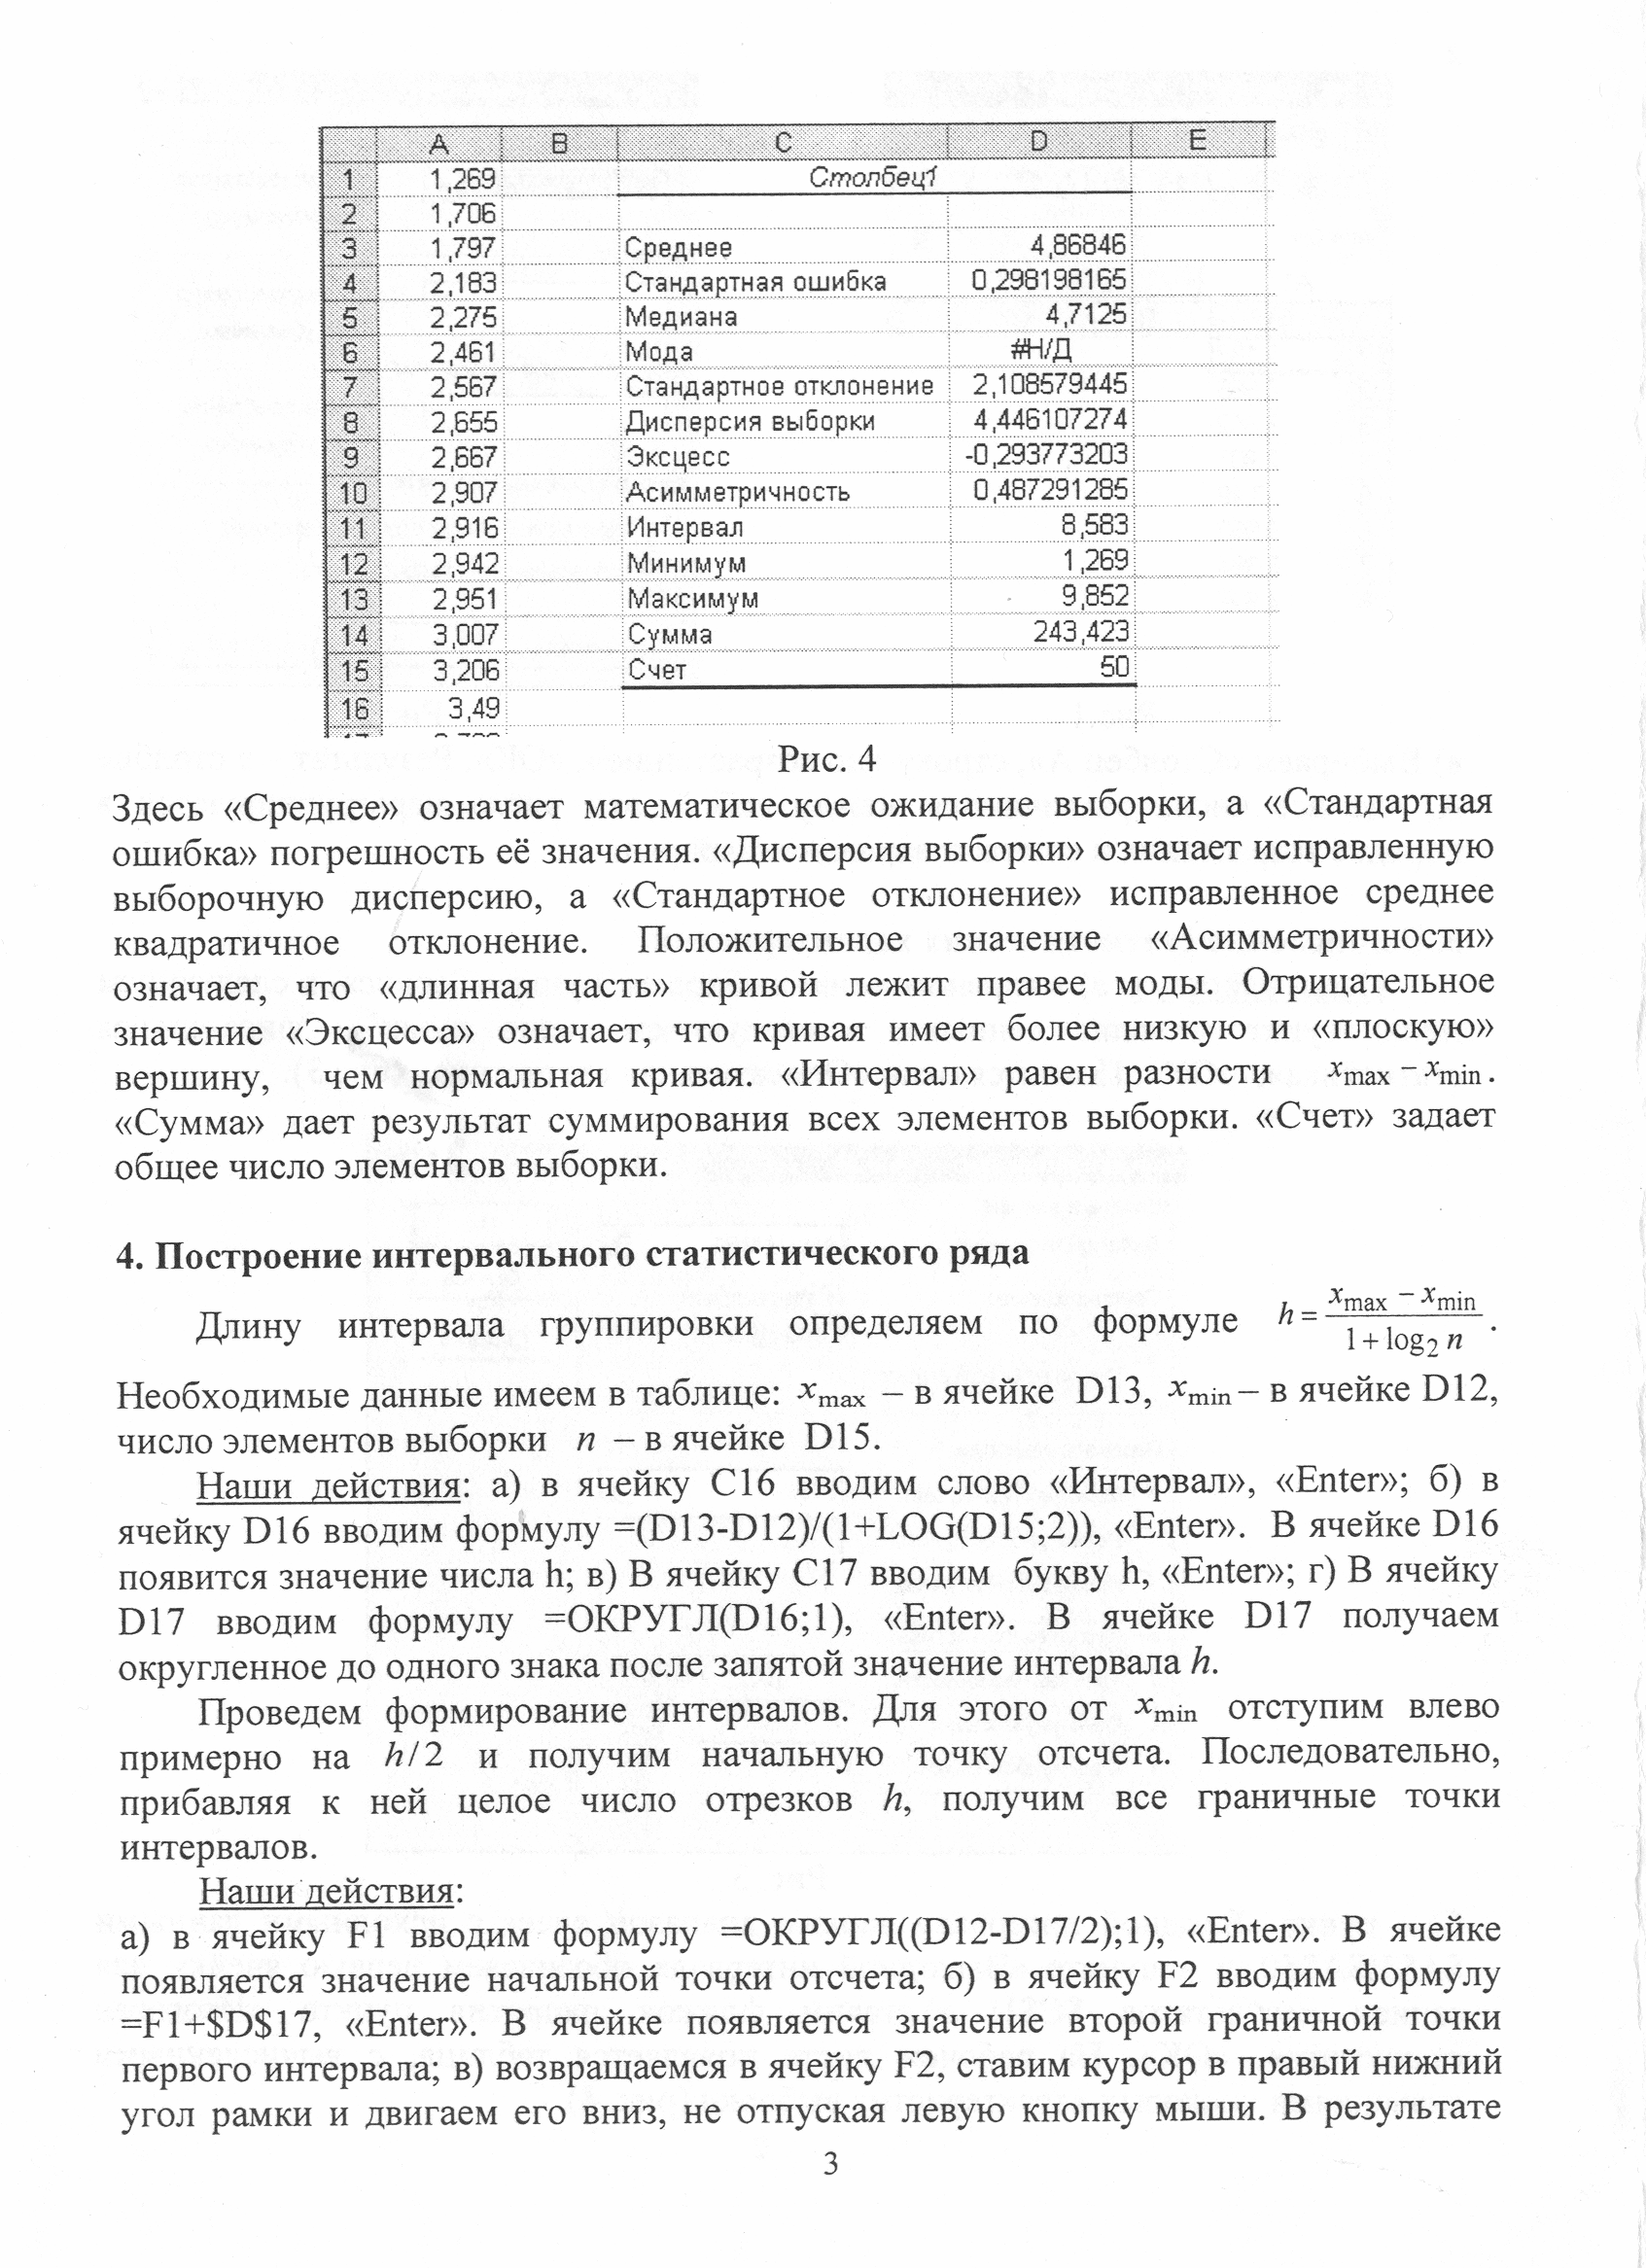
На рабочем листе появляется таблица с вычисленными значениями числовых характеристик выборки (рис.5)
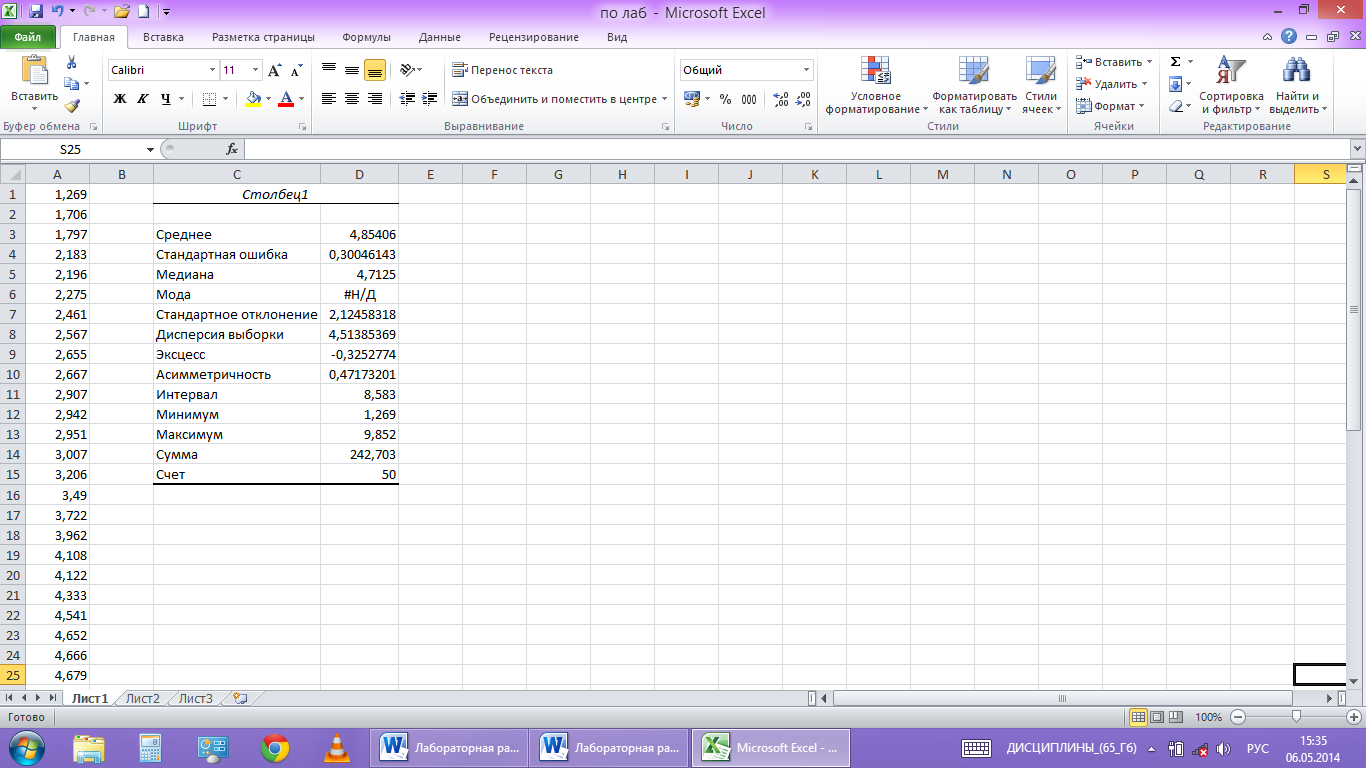
Здесь «Среднее»означает математическое ожидание выборки, а «Стандартная ошибка» — погрешность ее значения. «Дисперсия выборки» означает исправленную выборочную дисперсию, а «Стандартное отклонение» — исправленное среднее квадратичное отклонение. Положительное значение «Асимметричности» означает, что «длинная часть» кривой лежит правее моды. Отрицательное значение «Эксцесса» означает, что кривая имеет более низкую и «плоскую» вершину, чем нормальная кривая. «Интервал» равен разности Xmax−Xmin. «Сумма» дает результат суммирования всех элементов выборки. «Счет» задает общее число элементов выборки.
4. Построение интервального статистического ряда.
Длину интервала группировки определяем по формуле

Необходимые данные имеем в таблице: Xmax – в ячейке D13, Xmin– в ячейке D12, число элементов выборки n — в ячейке D15.
В ячейку С16 вводим слово «Интервал», в ячейку D16 вводим формулу
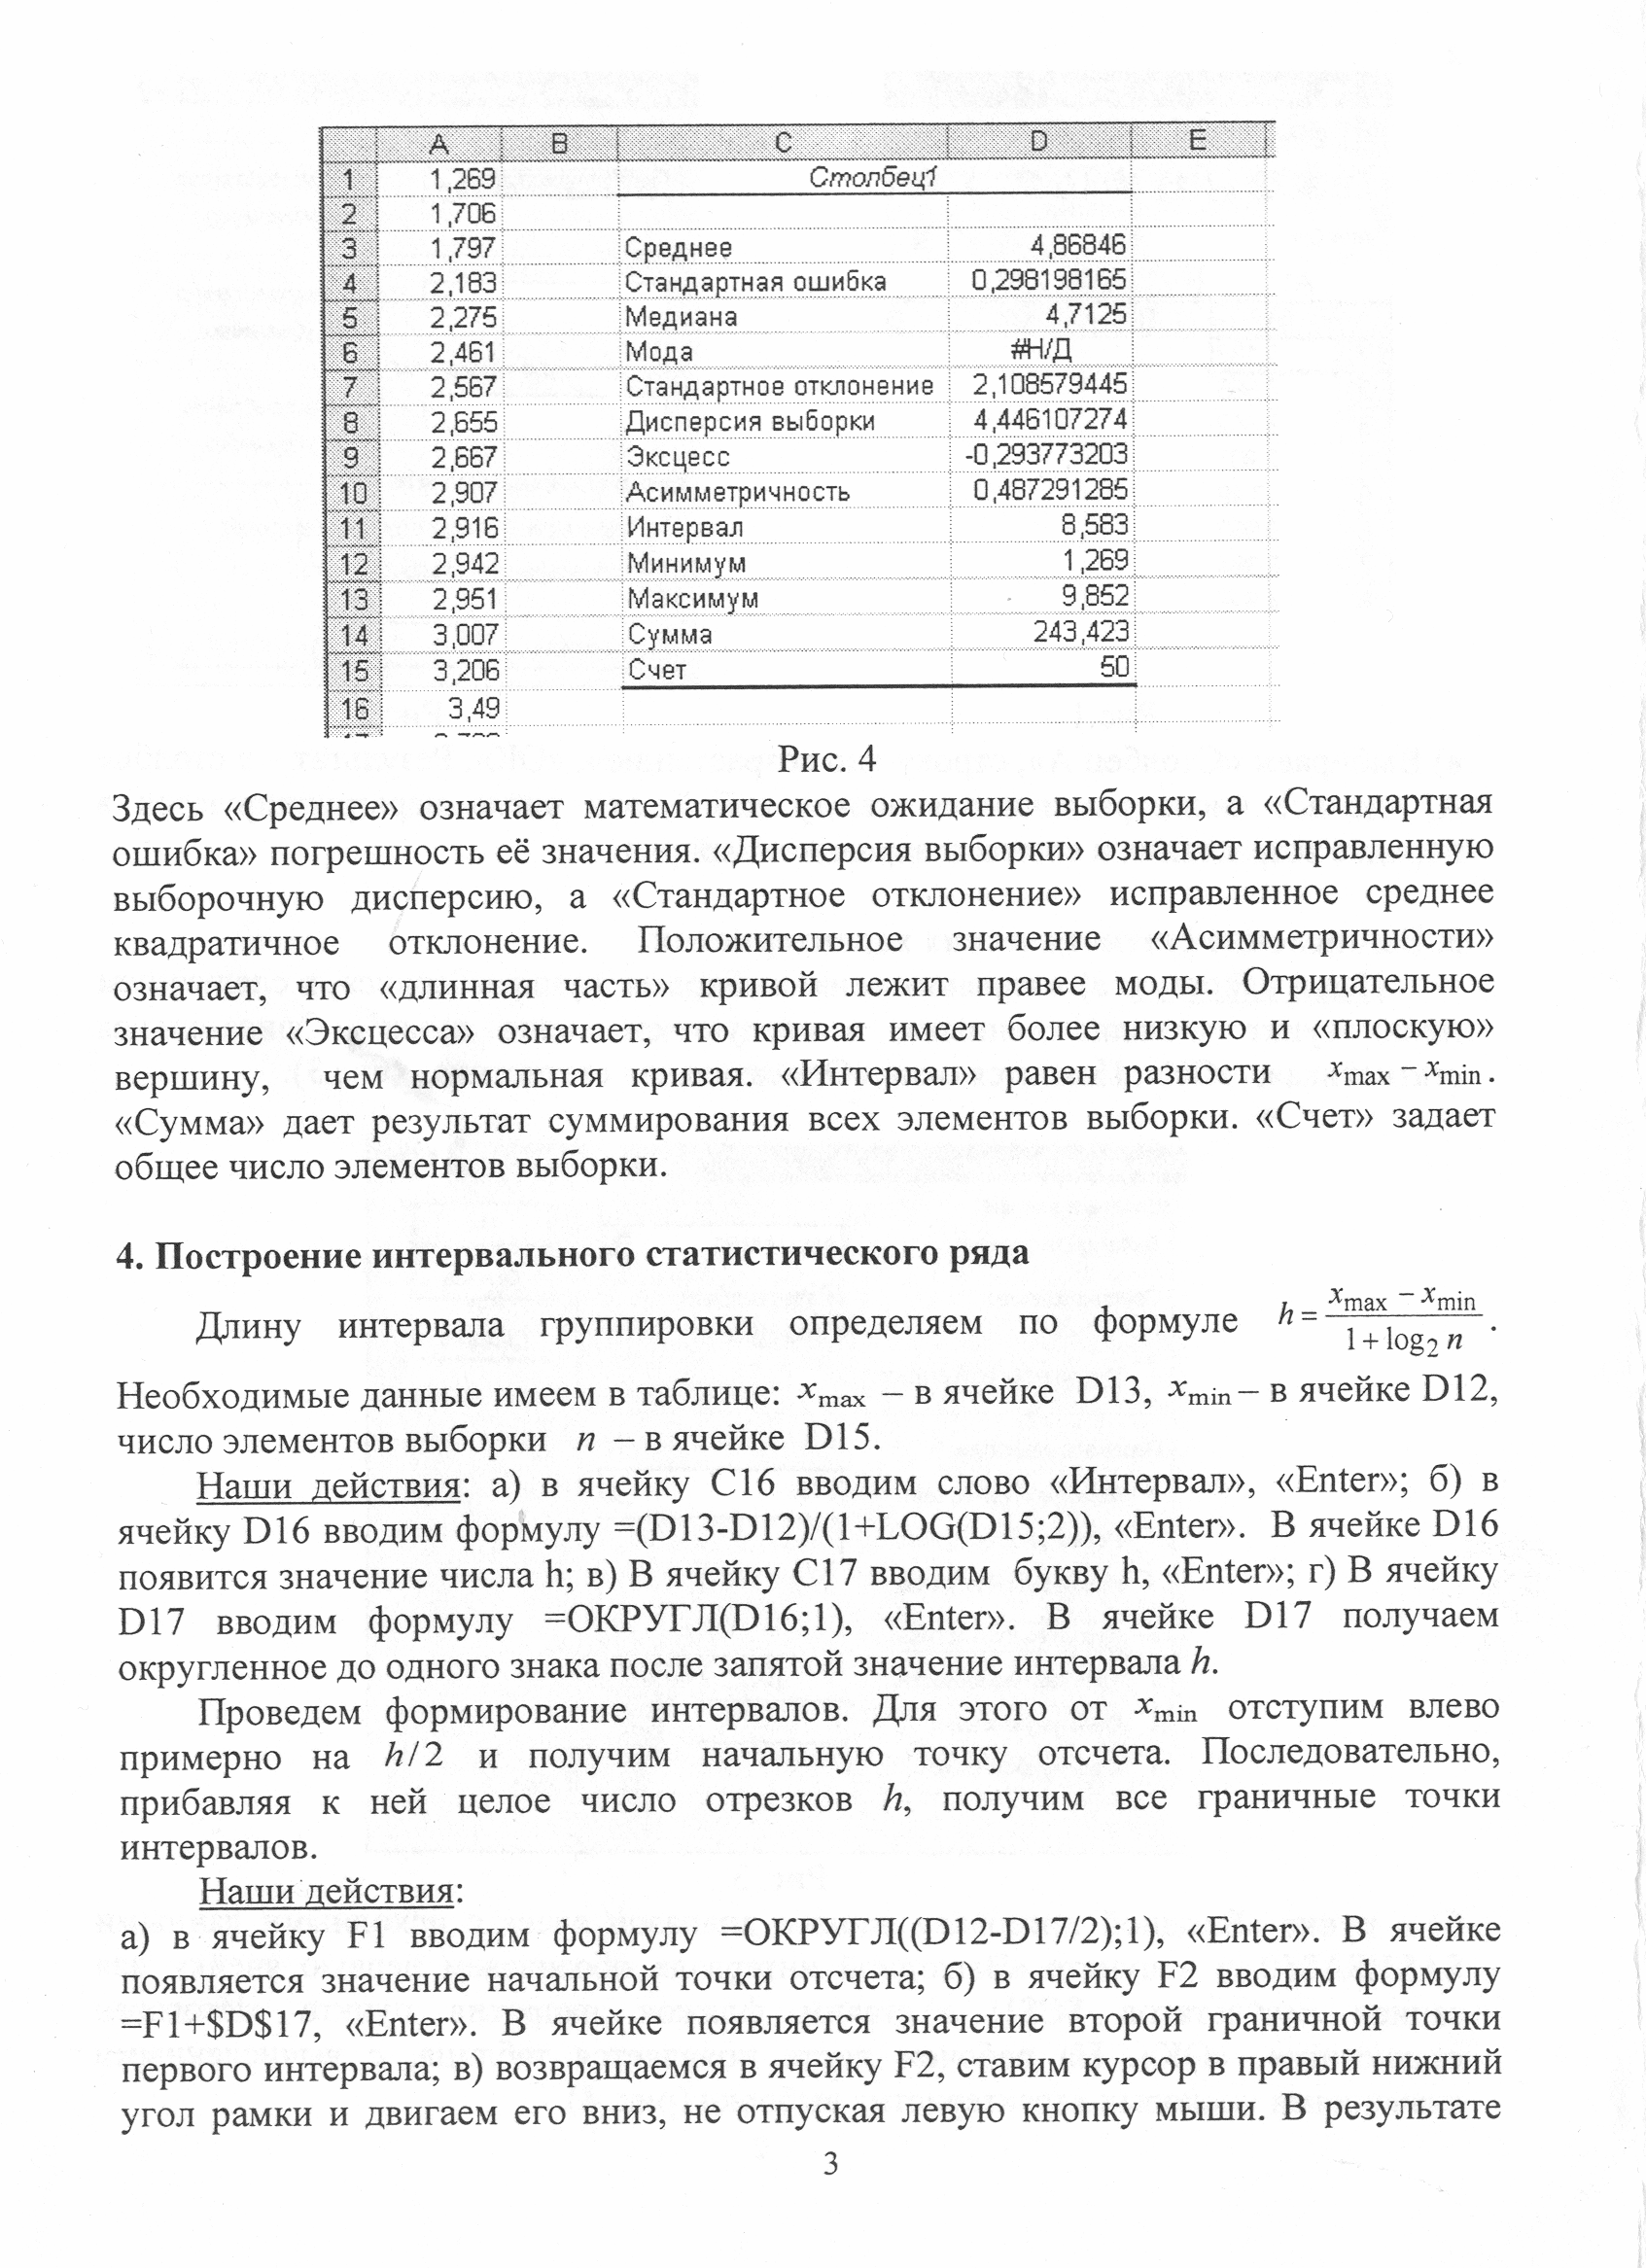
в ячейке D16 появится значение числа h. В ячейку C17 вводим букву h. В ячейку D17 вводим формулу

В ячейке D17 получаем округленное до одного знака после запятой значение интерала h.
Проведем формирование интервалов. Для этого от Xmin отступим влево примерно на h/2 и получим начальную точку отсчета. Последовательно прибавляя к ней целое число отрезков h, получим все граничные точки интервалов.
В ячейку F1 вводим формулу
В этой ячейке появляется значение начальной точки отсчета. В ячейку F2 вводим формулу
В этой ячейке появляется значение второй граничной точки первого интервала. Возвращаемся в ячейку F2, ставим курсор в правый нижний угол рамки и двигаем его вниз, не отпуская левую кнопку мыши. В результате такой процедуры (протяжка) столбец F заполнят граничные точки интервалов. Самый нижний интервал должен включать Xmax (рис.6).
Проведем подсчет числа вариант, попавших в каждый интервал, определим относительные частоты и серединные точки этих интервалов.
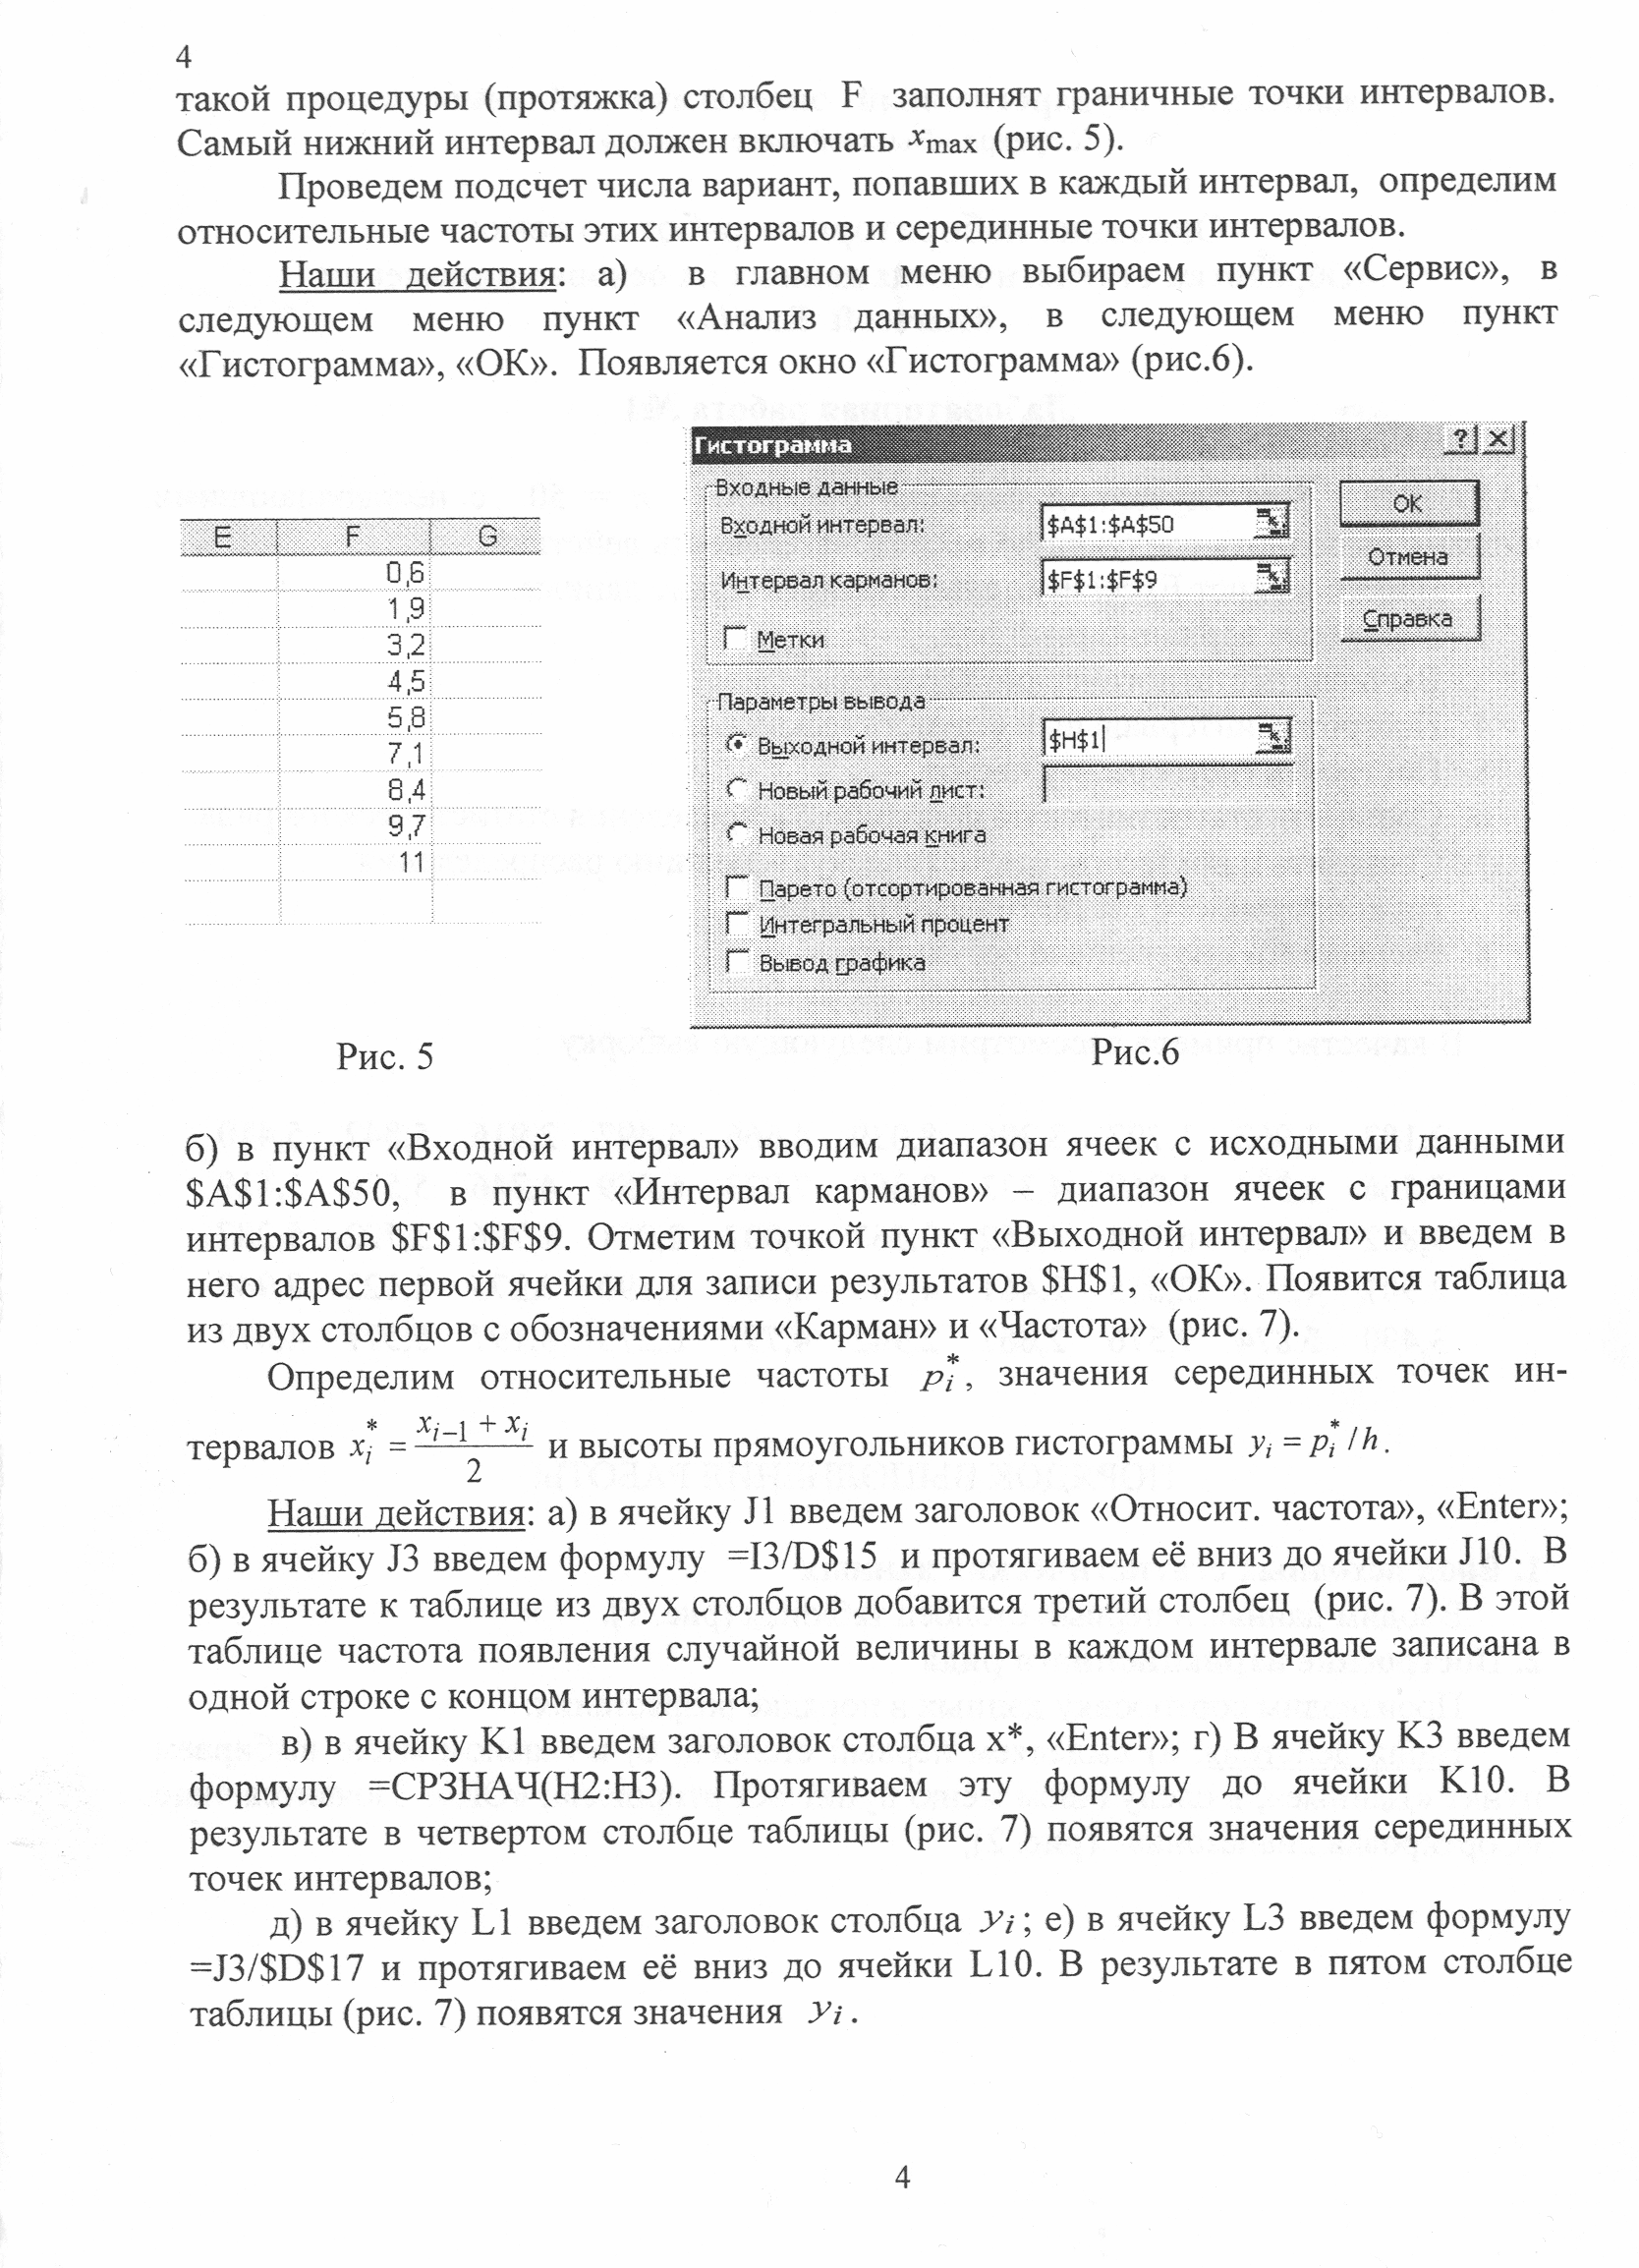
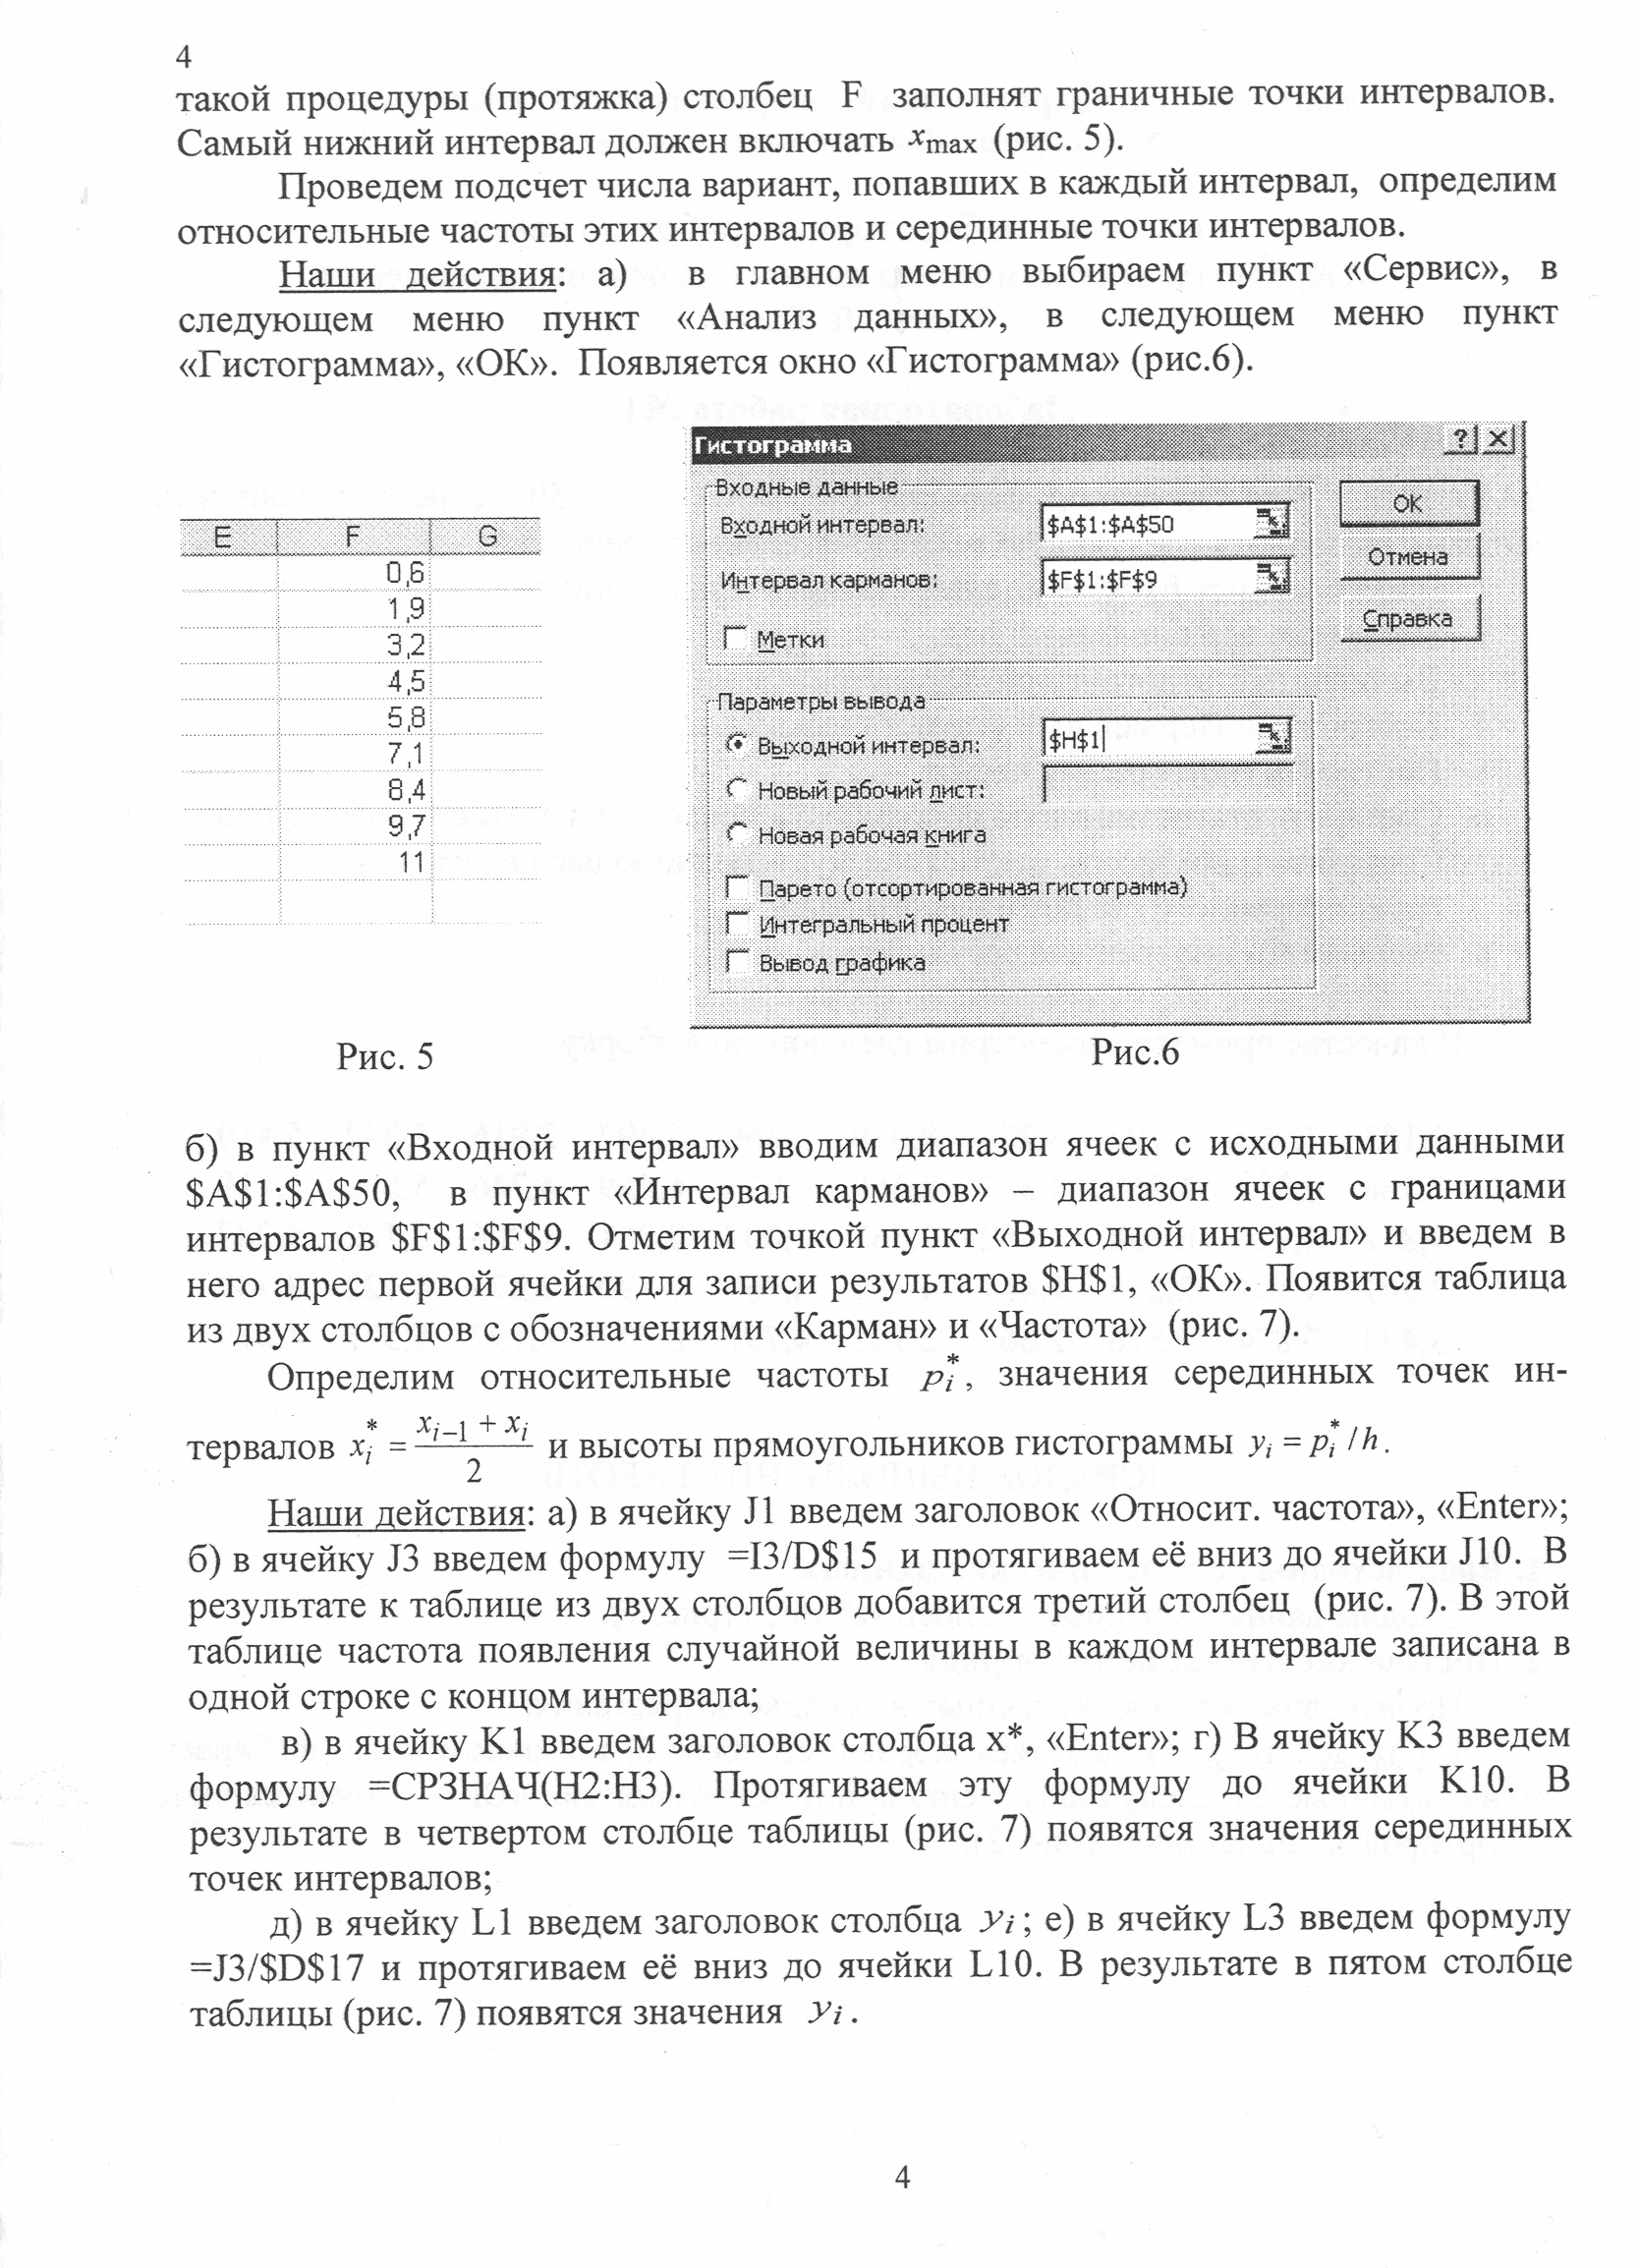
Для этого на ленте во вкладке «Данные» выбираем «Анализ данных» меню «Гистограмма». (рис. 7)
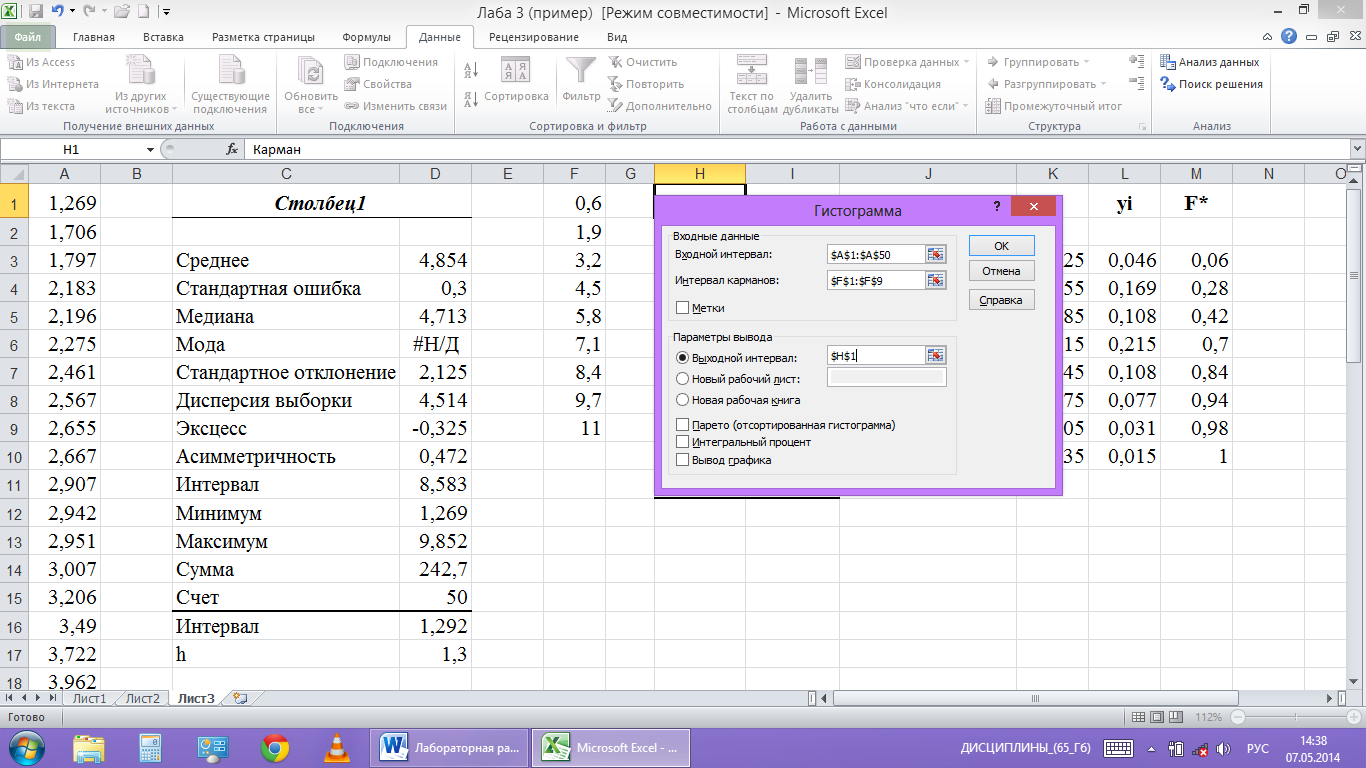
В пункт «Входной интервал» вводим диапазон ячеек с исходными данными $A$1:$A$50, в пункт «Интервал карманов» — диапазон ячеек с границами интервалов $F$1:$F$9. Отметим точкой пункт «Выходной интервал» и введем в него адрес первой ячейки для записи результатов $Н$1. Появится таблица из двух столбцов с обозначениями «Карман» и «Частота» (рис.8).
Определим относительные частоты рi * , значения серединных точек интервалов
и высоты прямоугольников
- в ячейку J1 введем заголовок «Относительная частота»;
- В ячейку J3 введем формулу
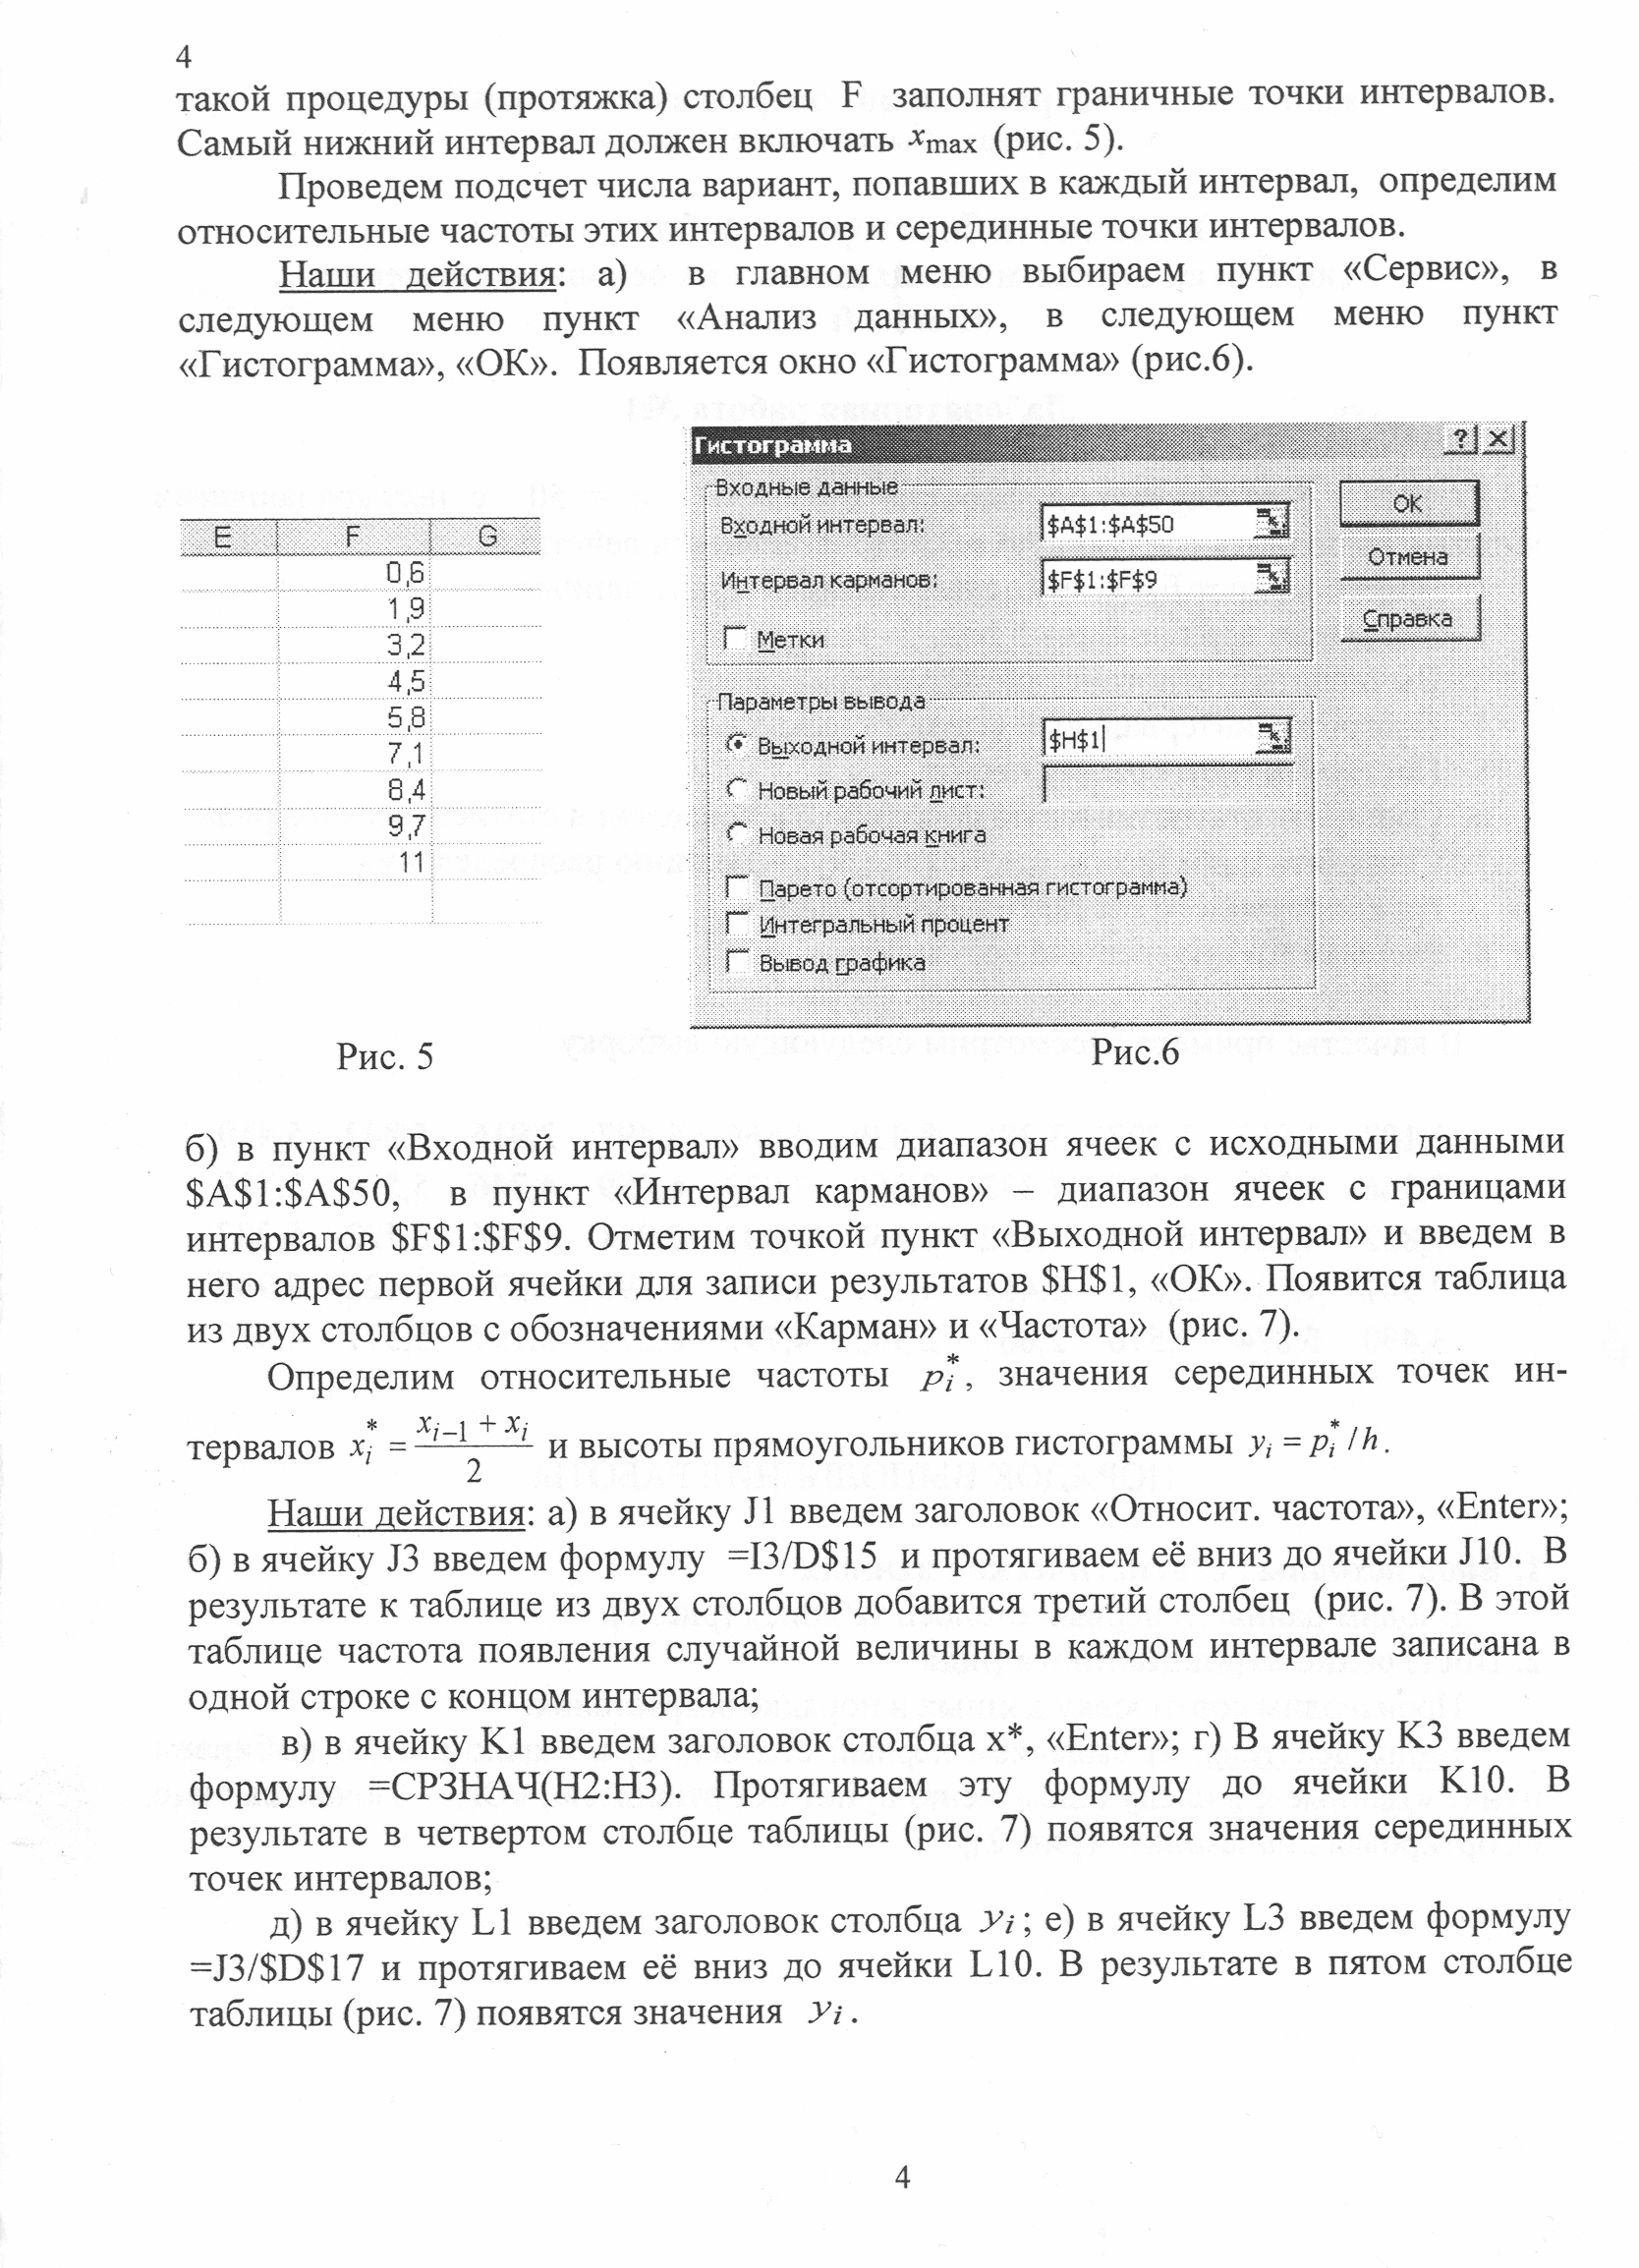 и протягиваем её вниз до ячейки J10. В результате к таблице из двух столбцов добавится третий столбец (рис.8). В этой таблице частота появления случайной величины в каждом интервале записана в одной строке с концом интервала;
- в ячейку K1 введем заголовок столбца Х*;
- в ячейку К3 введем формулу
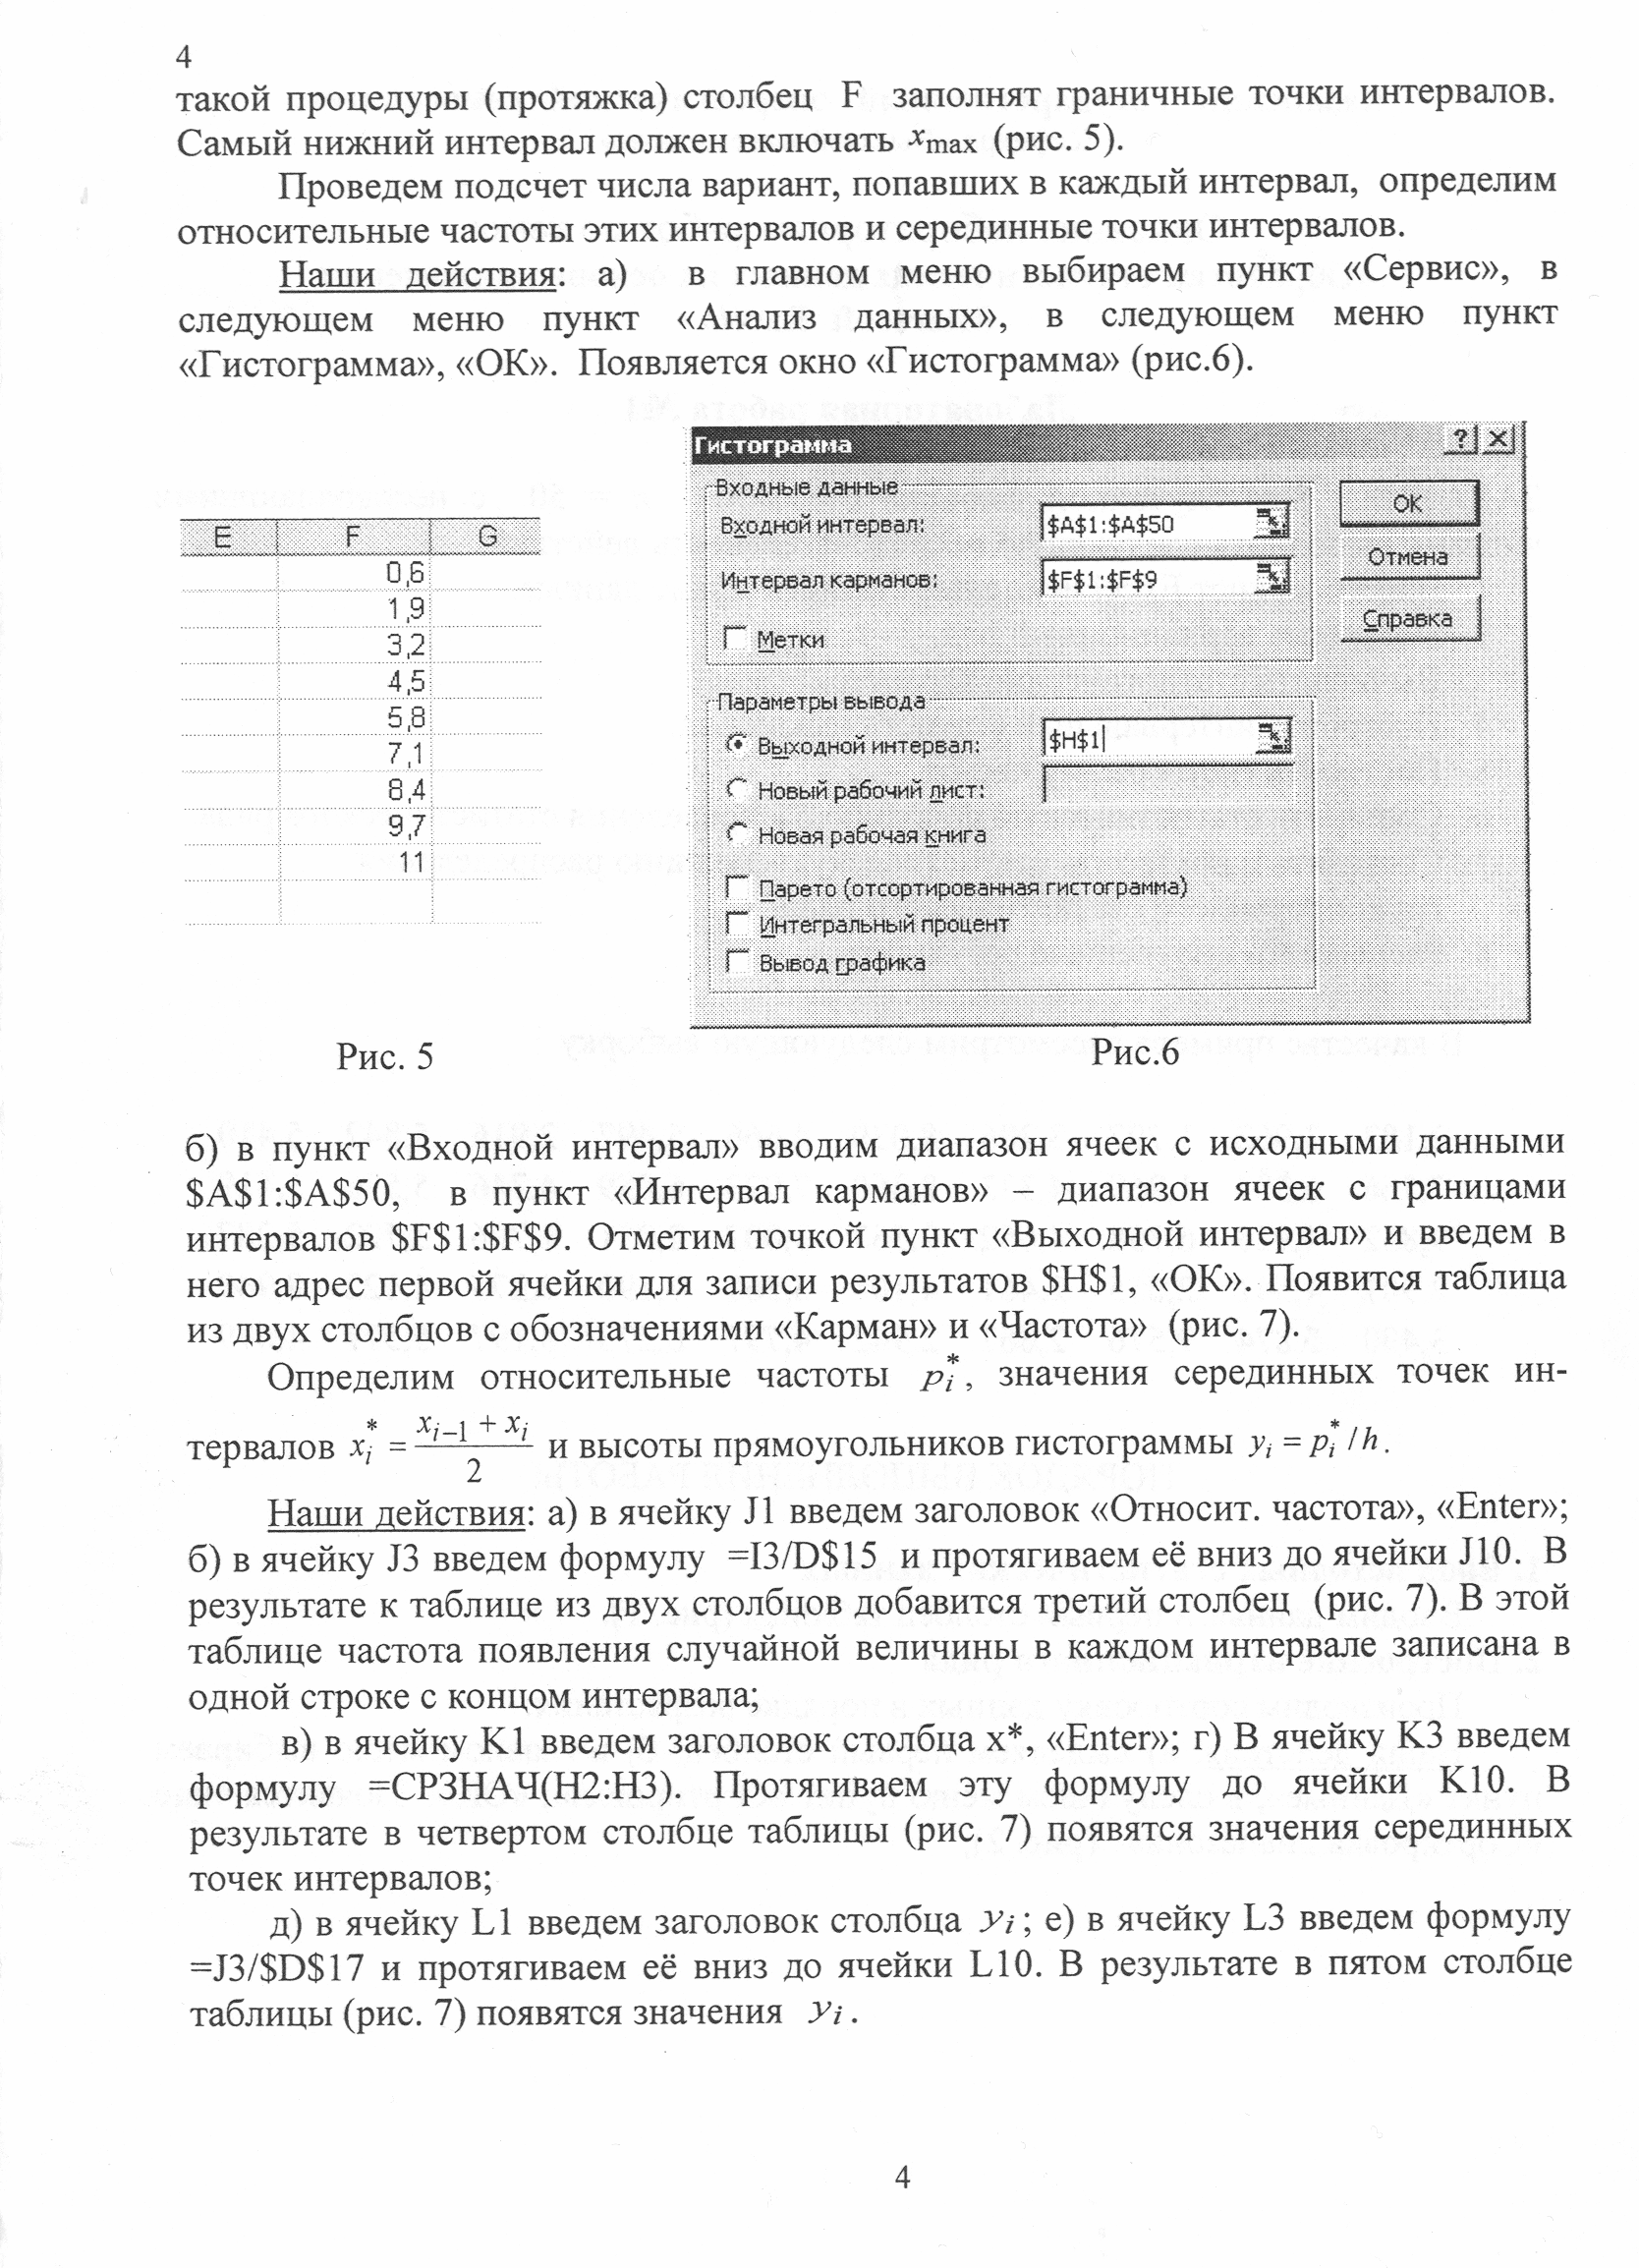 Протягиваем эту формулу до ячейки К10. В результате в четвертом столбце таблицы (рис.8) появятся значения серединных точек интервалов;
- в ячейку L1 введем заголовок столбца Уi;
- в ячейку L3 введем формулу
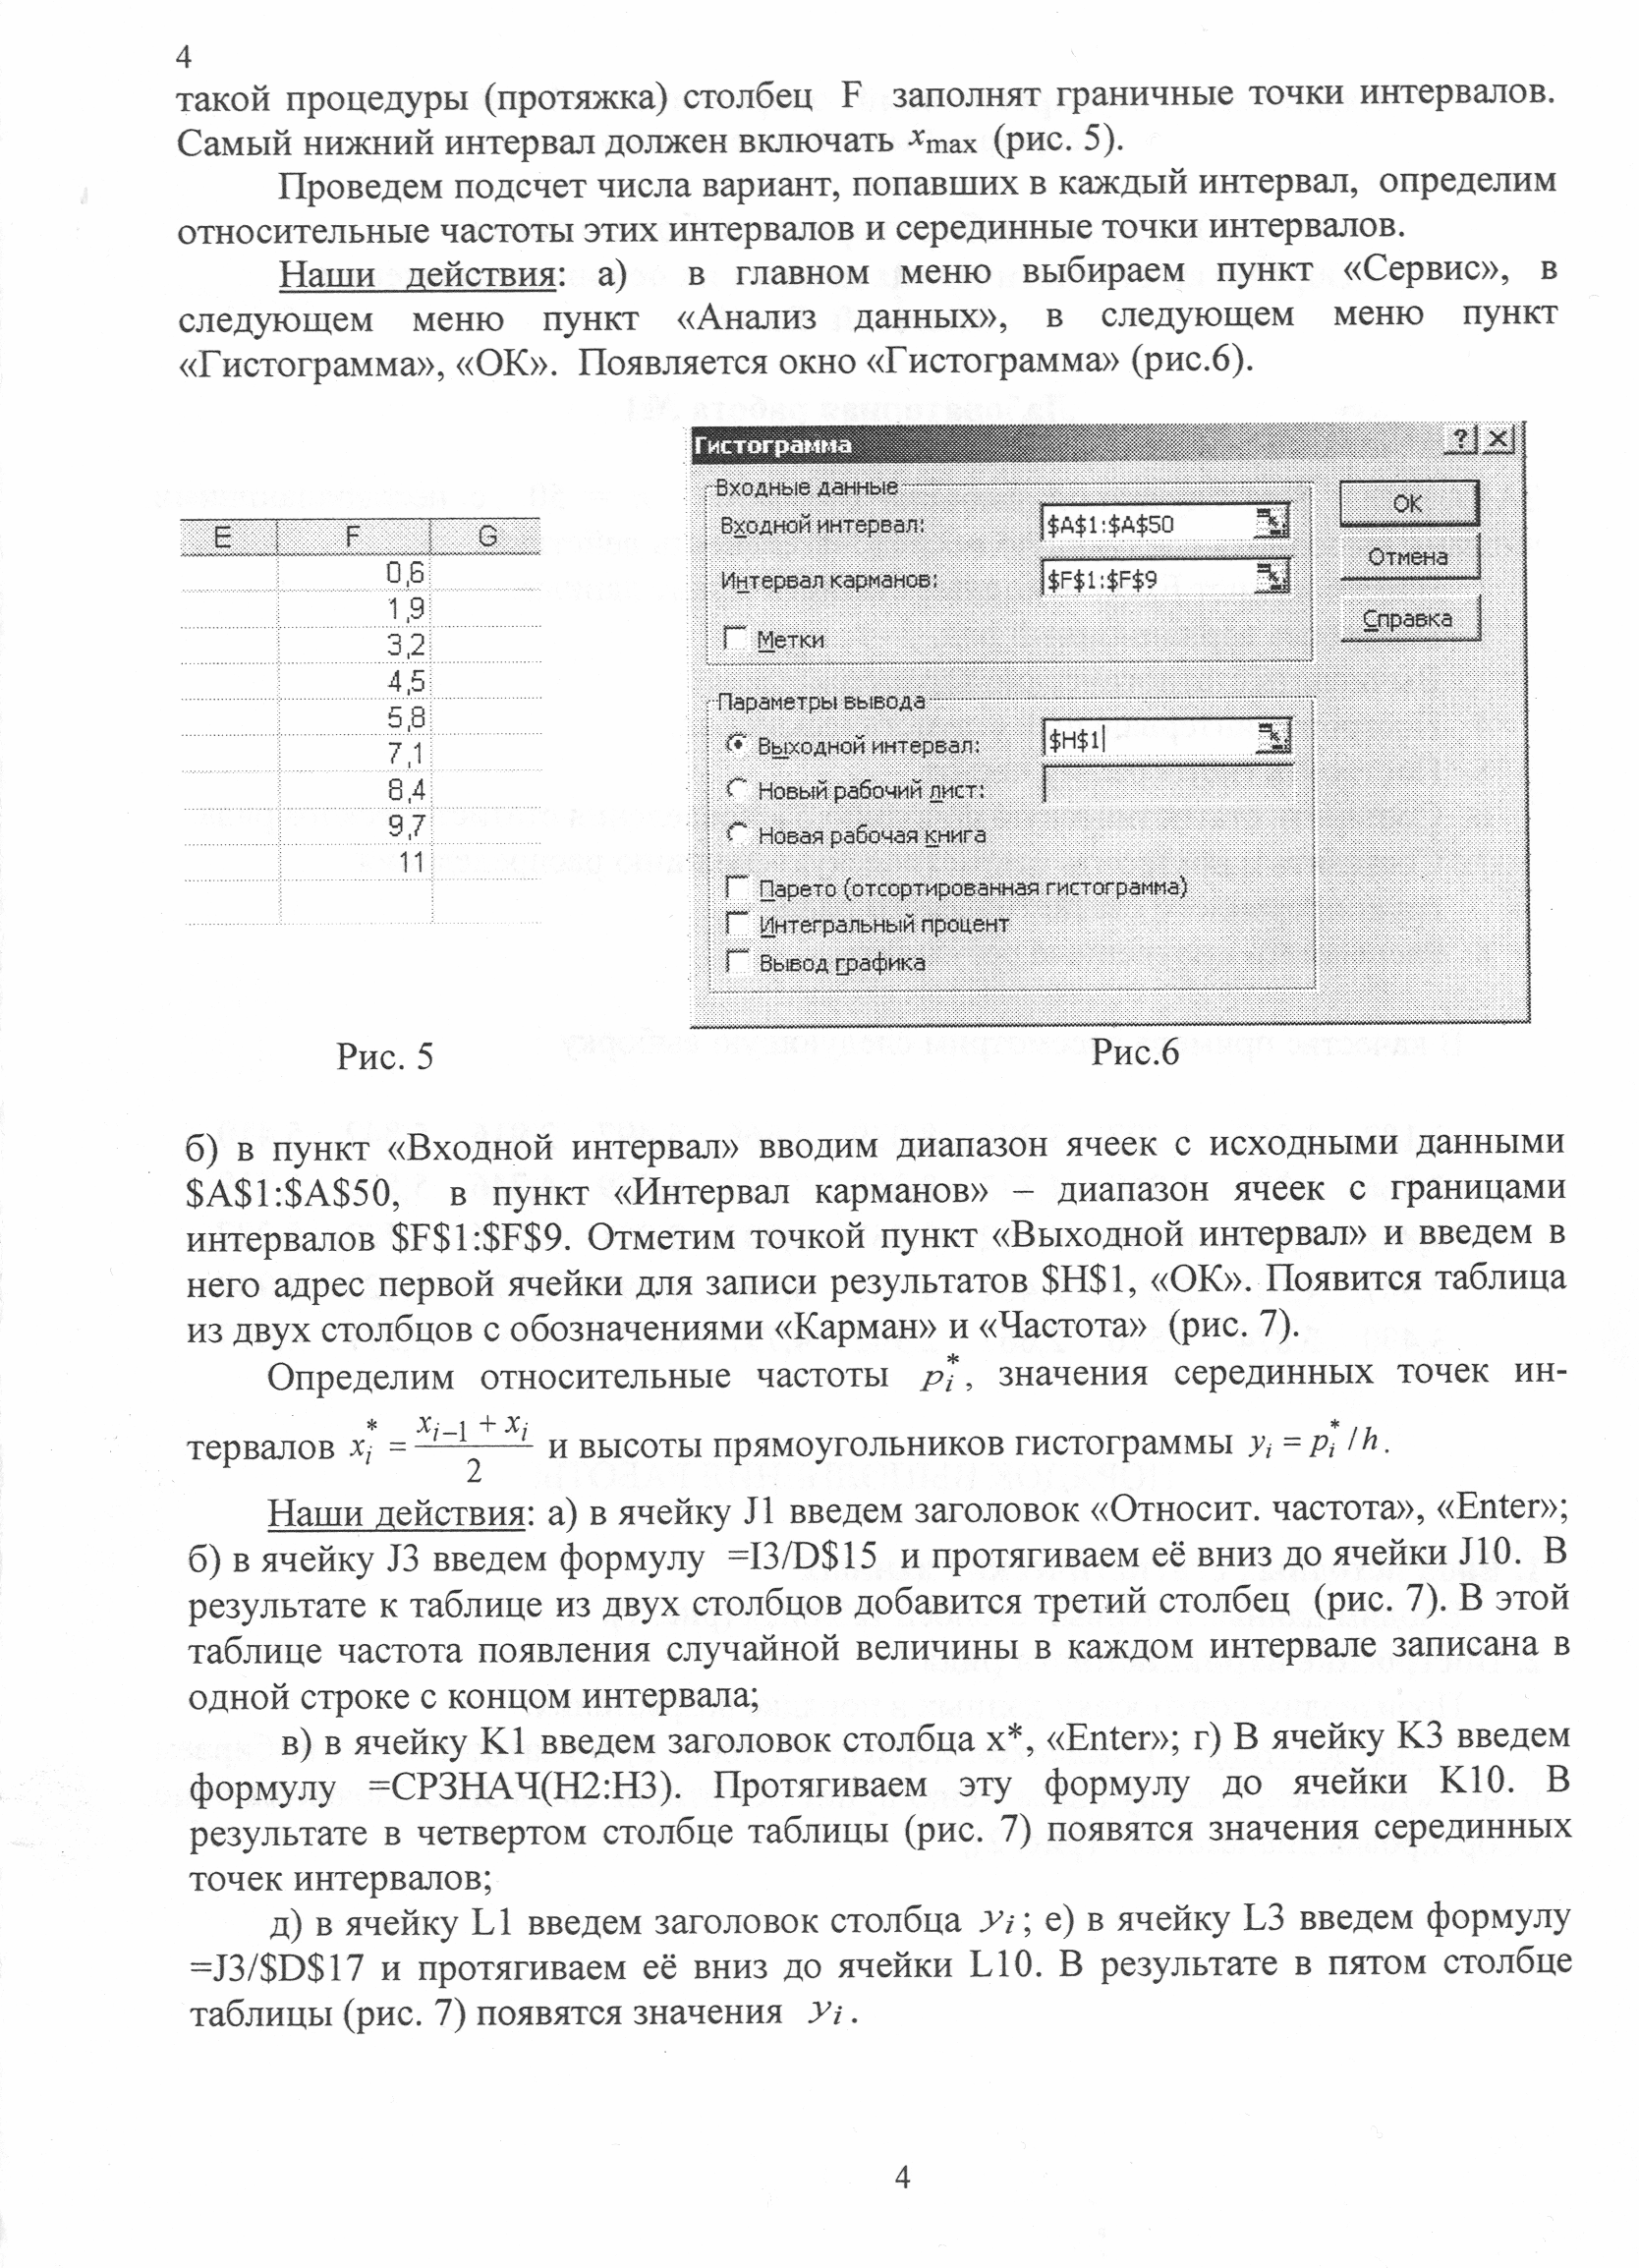 Протягиваем её вниз до ячейки L10. В результате в пятом столбце таблицы (рис.8) появятся значения Уi.
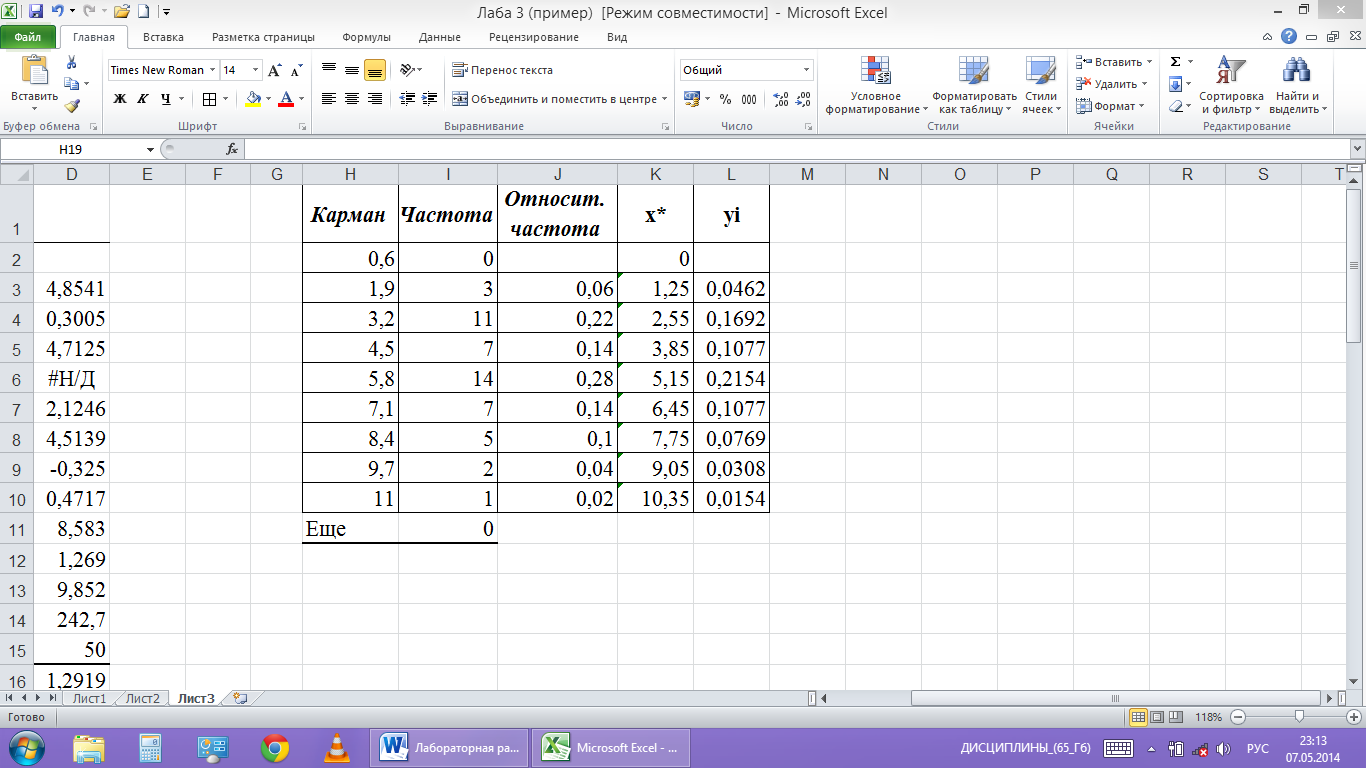 рис.8
Анализ вариационных рядов в Excel
В реальных социально-экономических системах нельзя проводить активные эксперименты, поэтому данные обычно представляют собой наблюдения за происходящим процессом, например: курс валюты на бирже в течение месяца, урожайность пшеницы в хозяйстве за 30 лет, производительность труда рабочих за смену и т.д. Результаты наблюдений — это в общем случае ряд чисел, расположенных в беспорядке, который для изучения необходимо упорядочить (проранжи- ровать).
Операция, заключающаяся в расположении значений признака по возрастанию, называется ранжированием опытных данных.
После операции ранжирования опытные данные можно сгруппировать так, чтобы в каждой группе признак принимал одно и то же значение, которое называется вариантом (х,). Число элементов в каждой группе называется частотой варианта («,).
Размахом вариации называется число

где хтах — наибольший вариант;
x min — наименьший вариант.
Сумма всех частот равна определенному числу л, которое называется объемом совокупности:

Отношение частоты данного варианта к объему совокупности называется относительной частотой, или частостью, этого варианта:

Последовательность вариант, расположенных в возрастающем порядке, называется вариационным рядом (вариация — изменение).
Вариационные ряды бывают дискретными и непрерывными. Дискретным вариационным рядом называется ранжированная последовательность вариант с соответствующими частотами и (или) частостями.
Пример 1. В результате тестирования группа из 24 человек набрала баллы: 4, 0, 3, 4, 1, 0, 3, 1, 0, 4, 0, 0, 3, 1, 0, 1, 1, 3, 2, 3, 1, 2, 1, 2. Построить дискретный вариационный ряд.
Решение. Проранжируем исходный ряд, подсчитаем частоту и частость вариант: 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 3, 3, 3, 3, 3, 4, 4, 4.
В результате получим дискретный вариационный ряд (табл. 3.10).
Ранжированный ряд успеваемости
Балл, х.
Число студентов, л,
Относительная частота, А
В Excel проранжируем исходный ряд. Для этого введем все данные в диапазон А1 :А24 и воспользуемся кнопкой Щ (Сортировка по возрастанию).
Подсчитаем частоту и частость вариант. Построим таблицу в диапазоне D2:G7 (рис. 3.13).

Рис. 3.13. Контекстное меню строки состояния
Рассмотрим два варианта подсчета частот:
- 1) выделим диапазон, в котором находятся нули. Щелкнем в нижней правой части окна Excel правой кнопкой мыши и выберем в контекстном меню вид итога, который по умолчанию будет появляться в итоговой строке при выделении произвольного диапазона (см. рис. 3.13) — количество. Таким образом, последовательно выделяя диапазоны с одинаковыми значениями вариант, мы получим все частоты;
- 2) выполним команду Сервис — Анализ данных — Гистограмма. Заполним диалоговое окно в соответствии с рис. 3.14.

Рис. 3.14. Диалоговое окно инструмента пакета анализа «Гистограмма»
В результате получим таблицу с частотами вариантов и соответствующий график (рис. 3.15).

Рис. 3.15. Результаты применения инструмента «Гистограмма)
Найдем объем выборки, заполнив все частоты вариант в диапазоне ЕЗ:Е7, выделим его левой кнопкой мыши и щелкнем по кнопке ? (автосумма).
В ячейку F3 введем формулу «=ЕЗ/$Е$8», за маркер заполнения (крест в правом нижнем углу ячейки) с помощью мыши скопируем до F7 и выберем кнопку автосумма, в результате получим частоты вариантов и их сумму (1). В ячейку G3 введем частоту варианта 0 — цифру 6 (или ссылку на ячейку, ее содержащую — ЕЗ), в ячейку G4 введем формулу «=G3+E4» и скопируем ее до ячейки G7, в результате получим накопленные частоты. Таким образом, мы получили дискретный вариационный ряд. Естественно, частоты необходимо округлить, но таким образом, чтобы их сумма равнялась 1. Для этого выделим левой кнопкой мыши диапазон частот (F3:F7), щелкнув по правой кнопке, откроем контекстное меню и выполним команду Формат ячеек — Числовой — Число знаков 3 — ОК. Преобразовав обозначения, получим дискретный вариационный ряд, представленный в табл. 3.11.
Дискретный вариационный ряд
Число студентов, я,
Относительная частота, р,
Графическое изображение вариационных рядов в Excel
Excel значительно упрощает построение вариационных рядов.
В Excel открываем файл с данными ПРИМЕР 2.2. Вызываем диалоговое окно Анализ данных, в котором выбирается режим Гистограмма (см. рис. 2.3).
Инструмент «Гистограмма» применяется для вычисления выборочных и интегральных частот попадания данных в указанные интервалы значений. При этом рассчитываются числа попаданий для заданного диапазона ячеек.
Перед нами вкладка Гистограмма. В столбце А — исходные данные измерений. В столбце С — интервал карманов. Заполняем вкладку. Входной интервал — вводим ссылку на ячейки с исходными данными (столбец А). Интервал карманов — вводим ссылку на ячейки, содержащие интервал карманов (столбец Q. В группе Параметры вывода выбираем местоположение выходных данных. Гистограмму можно расположить на том же листе, новом листе в текущей книге или в новой книге.
Установите один или несколько флажков:
Интегральный процент. Отображает суммарные проценты и добавляет в таблицу гистограммы строку суммарных процентов.
Вывод графика. Отображает встроенную таблицу гистограммы.
Нажмите кнопку ОК.

Рис. 2.19. Диалоговое окно гистограммы
В результате работы программы получим результат (рис. 2.20-2.22). Если вы захотите настроить гистограмму, можно изменить подписи и, щелкнув в любом месте гистограммы, использовать кнопки форматирования и макета справа от диаграммы.

Рис. 2.20. Результаты расчетов

Рис. 2.21. Гистограмма

Рис. 2.22. Диалоговое окно форматирования области построения
Используя кнопки форматирования, приводим диаграмму (гистограмму) к виду, показанному на рис. 2.23.
Щелкаем правой кнопкой мыши по полю графика гистограммы и выбираем вкладку Изменить тип диаграммы, на появившейся вкладке (рис. 2.24) выбираем и указываем, какой график, нажимаем ОК.
Перед нами появится Полигон распределения (рис. 2.25).

Рис. 2.23. Гистограмма отформатированная


Рис. 2.25. Полигон распределения

Рис. 2.26. Кумулята

Рис. 2.27. Огива
Аналогично строятся кумулята и огива (рис. 2.26, 2.27).
Построение вариационных рядов в ms Excel
В качестве примера создадим в MSExcel таблицу с результатами обработки измерений массы тела студентов. Для этого, после запуска введите исходные данные (Рисунок 90). 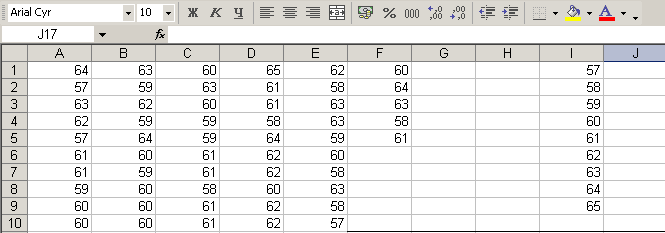 Рисунок 90. Один из вариантов расположение исходных данных для построения вариационного ряда в MSExcel Чтобы выполнить поставленную задачу, перейдите на другой лист MSExcel . Для чего установите указатель мыши на надпись в низу окна таблицы Лист 2 и щелкните левой клавишей мыши. Затем вызовите из меню Сервис> прикладной пакет Анализ данных>. В открывшемся окне Инструменты анализа> выберете Гистограмма>. Заполните поля в открывшемся окне как показано на рисунке.
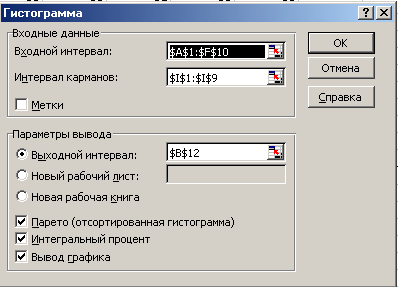 Рисунок 91. Вариант заполнения окна «Гистограмма» В окне (Рисунок 91) имеются следующие поля: 1.Входной интервал: содержит координаты ячеек электронной таблицы с исходными данными. Допускается и прямой ввод в это поле числовых значений анализируемого ряда. 2.Интервал карманов: содержит границы группировок (карманов). В данном случае числа 57, 58, 59, 60, 61, 62, 63, 64 и 65 были введены заранее, последовательно в клетки первого листа (от I1 до I9). В процессе группировки все варианты наблюдения с весом 57 кг отнесены в группу 57.Все варианты с весом 58 кг — в группу 58. Если варианты были бы представлены дробными числами, то варианта 58,8 кг, например, была бы отнесена в группу 58. Можно и не указывать границы группировок. В этом случае их подбор будет осуществлен автоматически. 3. Метки: отмечаются, когда в первой строке исходных данных имеются заголовки, Это делается для того, чтобы они не включались в числовую обработку. 4. В разделе Параметры вывода указывается место, куда будет выводиться результат. В этом же разделе указываются интервалы ячеек, в которых будут располагаться результаты. 5. Парето: группы, сортируются в порядке возрастания частоты; 6.Интегральный процент: накопленные частости, выраженные в %; 7.Вывод графика: диаграмма распределения анализируемого ряда значений.
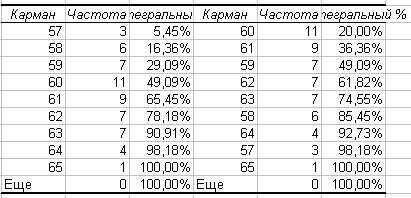 Рисунок 92. Результат построения вариационного ряда Рядом выводится диаграмма полученного распределения.
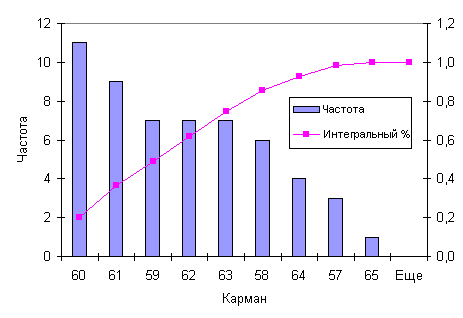 Рисунок 93. Диаграмма распределения параметров сформированного вариационного ряда Внешний вид гистограммы и отдельные элементы экспликации дорабатываются пользователем в соответствии с его предпочтениями с помощью обычных приемов обработки графических изображений в Excel.
Показатели центра распределения. Средние величины
Важным свойством статистической совокупности является положение центра ряда распределения. В примере (Таблица 96) представлены данные о распределении 80 мужчин и 33 женщин по росту и соответствующие полигоны частот (Рисунок 94). Таблица 96
Распределение мужчин и женщин по росту
| Рост (см) V | Рост (см) Vср | Частоты | VP1 | VP2 | |
| женщин P1 | мужчин P2 | ||||
| 150-151 | 151 | 1 | 1 | 151 | 151 |
| 152-153 | 153 | 3 | 4 | 459 | 612 |
| 154-155 | 155 | 5 | 8 | 775 | 1240 |
| 156-157 | 157 | 7 | 11 | 1099 | 1727 |
| 158-159 | 159 | 6 | 14 | 954 | 2226 |
| 160-161 | 161 | 5 | 17 | 805 | 2737 |
| 162-163 | 163 | 3 | 15 | 489 | 2445 |
| 164-165 | 165 | 2 | 9 | 330 | 1485 |
| 166-167 | 167 | 1 | 1 | 167 | 167 |
| Итого | P1=33 | P2=80 | VP2=5229 | VP2=12790 | |
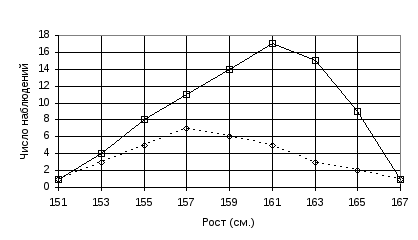
Рисунок 94. Распределение мужчин и женщин по росту Из этих данных видно, что кривые распределения показателей у мужчин и женщин имеют отличия. Они связаны с различным числом наблюдений и поэтому имеют разные высоты кривых, а также сдвинуты одна относительно другой. Параметры распределения, с помощью которых можно оценить величину этого сдвига, характеризуют распределение ряда положением его середины и называются средними величинами. Средняя величина выражает характерную, типичную для данного ряда величину признака. Эта величина образуется в данных условиях места и времени под воздействием всей совокупности действующих факторов. Средняя величина является равнодействующей всех этих факторов. В средней величине погашаются индивидуальные различия отдельных единиц наблюдения, обусловленные случайными, привходящими обстоятельствами.