Как обнаружить активный в данный момент узел в кластере SQL Server? И как эмулировать отказ.
В этом посте я продемонстрирую как обнаружить активный в данный момент узел в кластере SQL Server, и как выполнить ручной отказ другого узла. Отмечу, что отказ скажется на среде вашего SQL Server в очень короткий период времени. Это происходит потому, что восстановление будет произведено на новом узле кластера SQL Server. В среде с долгосрочными транзакциями, время восстановления может быть значительнее. Поэтому не выполняйте отказ в производственной среде без острой необходимости. Желательно сначала все попробовать сделать в тестовой среде кластера. В данной демонстрации я использую Windows Server 2012 R2 и SQL Server 2014. Мой кластер состоит из двух узлов (WIN-2012SQL01 и WIN-2012SQL02), оба находятся в общем режиме SQL Server. Кластер называется SQL2014CLU. Для установки виртуальной среды для того, чтобы поэкспериментировать со своим кластером SQL Server, я следовал серии блога Jonathan Kehayias “Building a Completely Free Playground for SQL Server”. В этой серии используются Windows 2008 R2 и SQL Server 2008 R2, но с минимальными изменениями инструкция может быть использована для создания тест-среды с Windows 2012 R2 и SQL Server 2014.
Поиск активного узла в кластере SQL Server
Чтобы проверить на каком узле физически запущен SQL Server , выполняем запрос:
select SERVERPROPERTY (‘ ComputerNamePhysicalNetBIOS ‘)
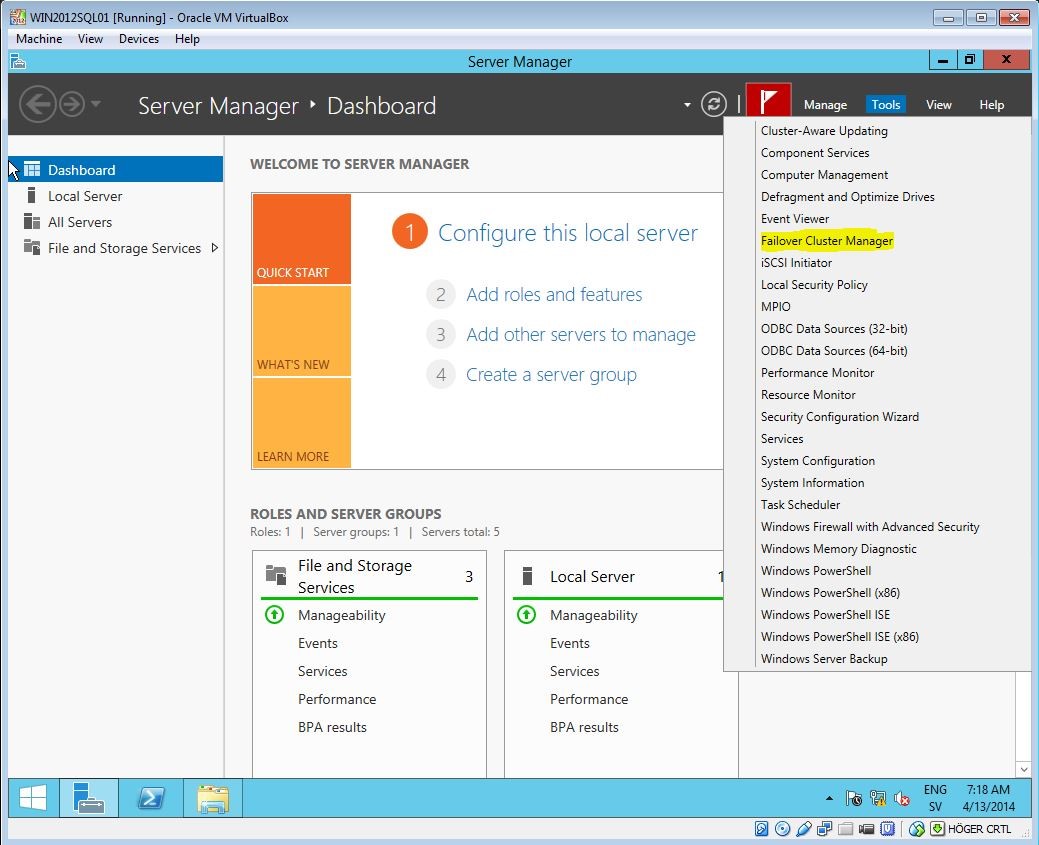
С любого узла в кластере (активного или пассивного) запустите Failover Cluster Manager из Server Manager:
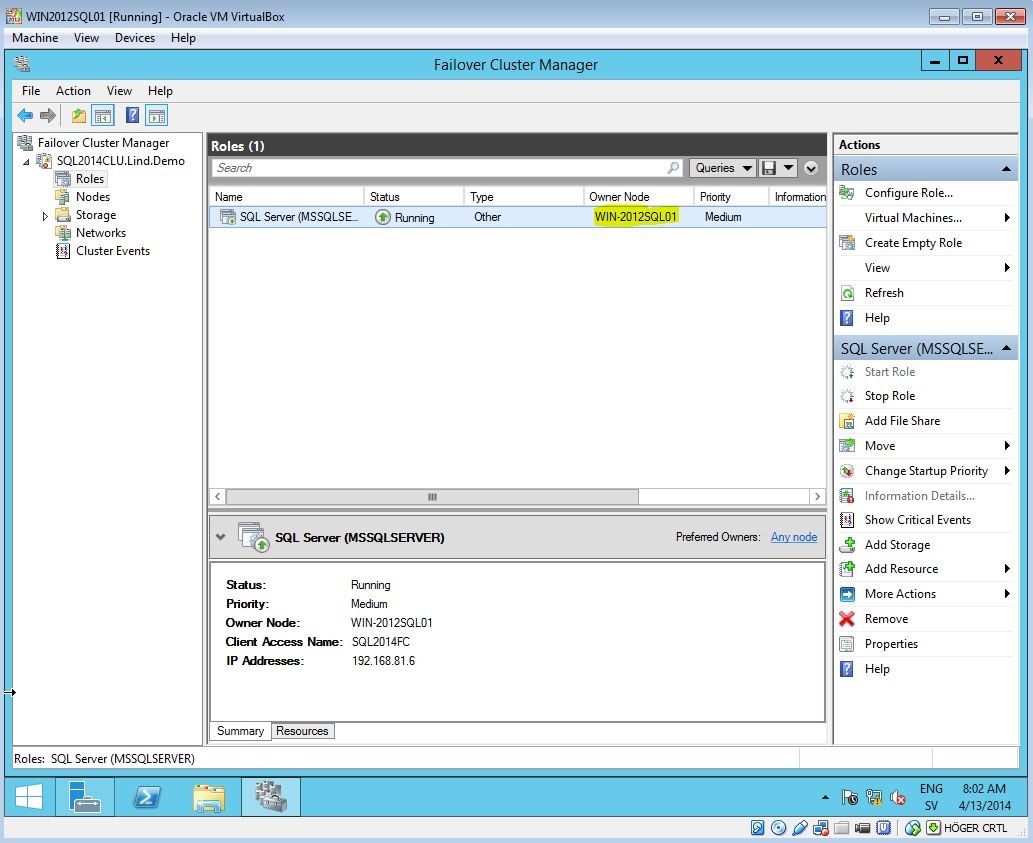
Выберите ваш кластер из правого меню, выберите “Roles” и вы увидите узел владельца:
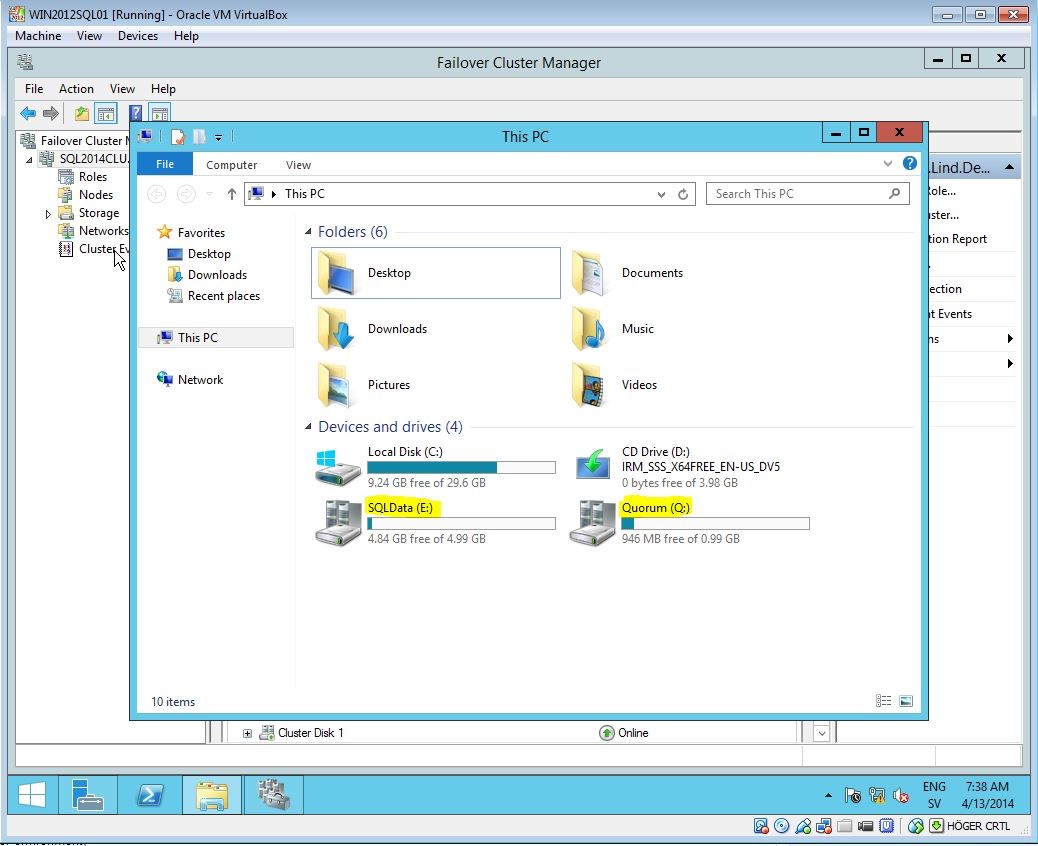
Только на активном узле кластера, расшаренный диск будет доступен:
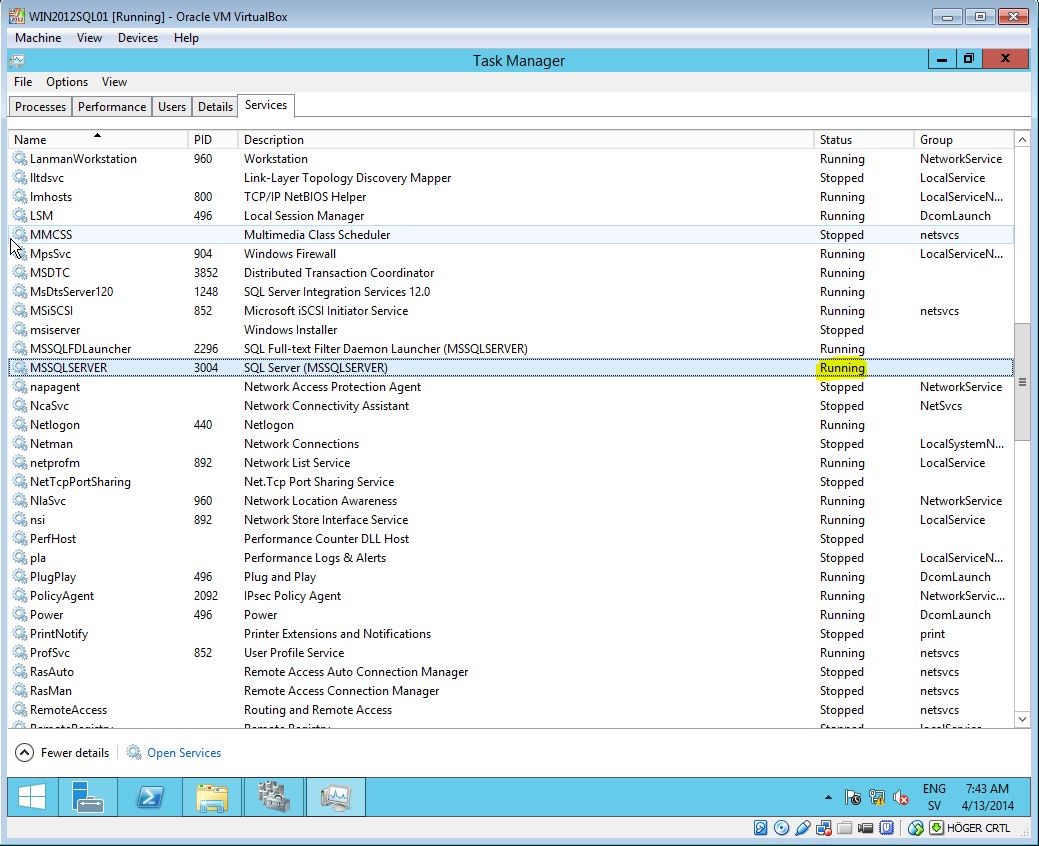
Так же только на активном узле SQL Server процесс будет запущен:
Разумеется, любое событие которое делает активный узел недоступным, сделает один из пассивных доступным. Но если вы, к примеру, хотите выполнять задачи на активном в данный момент узле, значение кластера может быть изменено в Failover Cluster Manager. В правом меню выберите “Roles”. Правой кнопкой мыши кликните на кластере и выберите “Move” -> “Select Node”:
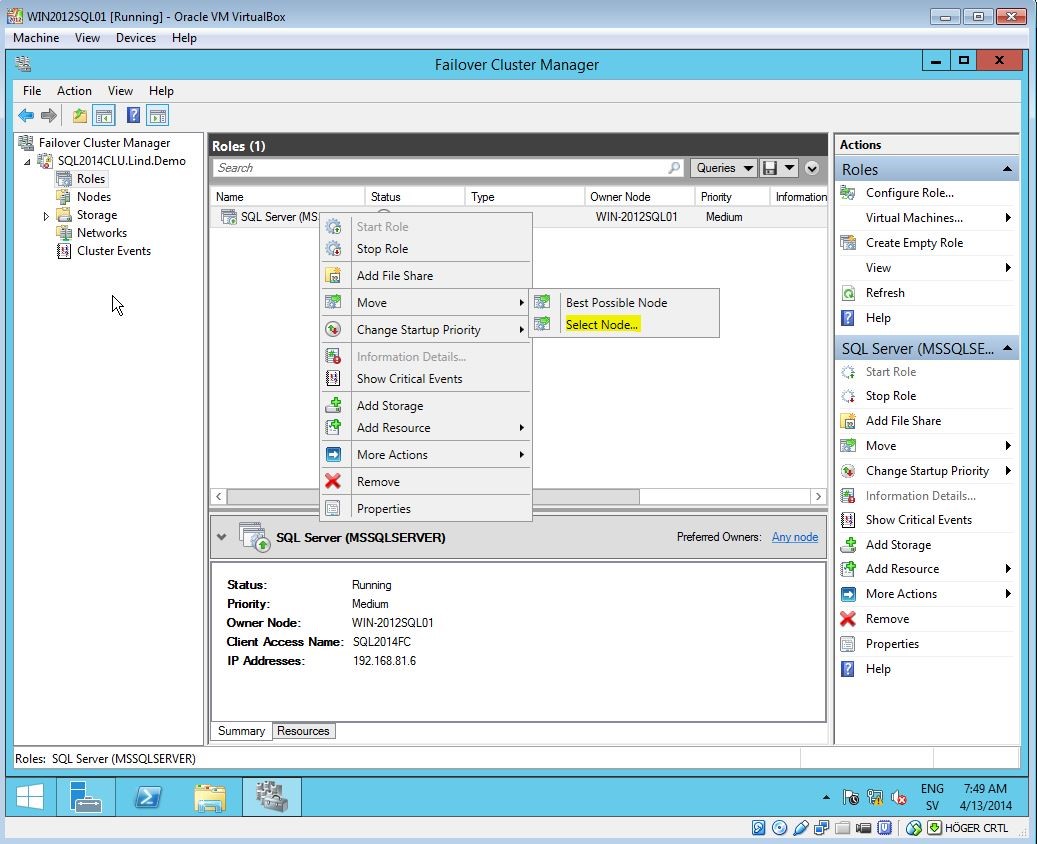
Теперь выберите один пассивный узел, который вы хотите переместить и жмите “ОК”(У меня только один пассивный):
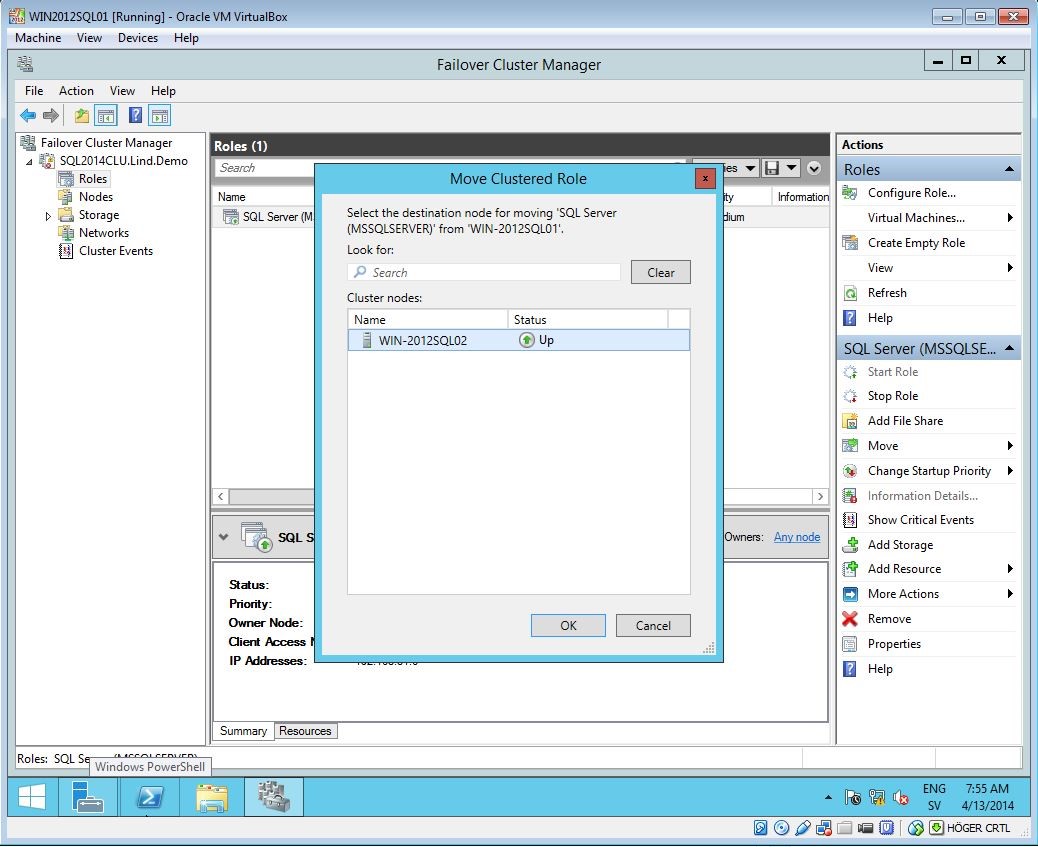
Через некоторое время (SQL Server начнет восстановление на новом активном узле) значения будут изменены.
Диагностика отказоустойчивого кластера
Первым шагом диагностики является проверка нового кластера. Дополнительные сведения о проверке см. в разделе Создание отказоустойчивого кластера: проверка конфигурации. Эту процедуру можно выполнить без нарушения работы службы, поскольку она не влияет на ресурсы кластера в сети. Проверку можно провести в любое время после установки функции отказоустойчивой кластеризации, включая момент перед развертыванием кластера, во время создания кластера и во время его работы. На самом деле дополнительные тесты выполняются после перевода кластера в рабочий режим и проверяют соблюдение рекомендаций для рабочих нагрузок с высоким уровнем доступности. Из множества тестов лишь немногие повлияют на функционирование рабочих нагрузок кластера. Все они входят в категорию хранилища, поэтому, пропустив эту категорию, можно легко отказаться от тестов с негативными последствиями.
Отказоустойчивая кластеризация располагает встроенными мерами защиты для предотвращения случайного времени простоев при выполнении тестов хранилища во время проверки. Если при инициации проверки в кластере имеются сетевые группы и выбраны тесты хранилища, будет выведен запрос на подтверждение необходимости запуска всех тестов (и возникновения простоя) или пропуска тестирования дисков сетевых групп, чтобы избежать простоя. Если из тестирования была исключена вся категория хранилища, этот запрос не отображается. Проверка кластера будет выполнена без простоев.
Повторная проверка кластера
- В оснастке отказоустойчивого кластера в дереве консоли убедитесь, что выбран параметр Управление отказоустойчивым кластером , а затем в разделе Управлениенажмите кнопку Проверить конфигурацию.
- Следуйте инструкциям мастера по указанию серверов и тестов, а затем выполните тесты. После выполнения тестов откроется страница Сводка .
- На странице Сводка щелкните Просмотреть отчет , чтобы просмотреть результаты теста. Чтобы просмотреть результаты тестов после закрытия мастера, см. %SystemRoot%\Cluster\Reports\Validation Report date and time.html , где % SystemRoot % — это папка, в которой установлена операционная система (например, C:\Windows).
- Чтобы просмотреть разделы справки, которые помогут интерпретировать результаты, щелкните Дополнительные сведения о тестах для проверки кластеров.
Чтобы просмотреть разделы справки о проверке кластера после закрытия мастера, в оснастке отказоустойчивого кластера щелкните Справка, Разделы справки, откройте вкладку Содержимое , разверните содержимое справки по отказоустойчивому кластеру и щелкните Проверка конфигурации отказоустойчивого кластера. После завершения работы мастера проверки результаты появятся в сводном отчете . Все выполненные тесты должны быть отмечены зеленой галочкой или в некоторых случаях желтым треугольником (предупреждение). При поиске проблемных областей (отмеченных красными крестиками X или желтыми вопросительными знаками) в части отчета, где приведена сводка результатов теста, щелкните отдельный тест, чтобы просмотреть подробные сведения. Все проблемы, отмеченные красными крестиками X, необходимо разрешить до устранения неполадок SQL Server .
Установка обновлений
Установка обновлений является важной частью предотвращения проблем в системе. Полезные ссылки
- Рекомендуемые исправления и обновления для отказоустойчивых кластеров Windows Server 2012 R2.
- Рекомендуемые исправления и обновления для отказоустойчивых кластеров Windows Server 2012.
- Рекомендуемые исправления и обновления для отказоустойчивых кластеров Windows Server 2008 R2.
- Рекомендуемые исправления и обновления для отказоустойчивых кластеров Windows Server 2008.
Восстановление по журналу после сбоя отказоустойчивого кластера
Обычно сбой отказоустойчивого кластера возникает в следующих случаях.
- Сбой оборудования в одном из узлов двухузлового кластера. Такой сбой оборудования может быть вызван сбоем SCSI-контроллера или ОС. Для восстановления после такого сбоя удалите неисправный узел из отказоустойчивого кластера с помощью программы установки SQL Server , устраните сбой оборудования, переключив компьютер в режим «вне сети», восстановите машину и добавьте восстановленный узел снова к экземпляру отказоустойчивого кластера. Дополнительные сведения см. в статьях Создание нового экземпляра отказоустойчивого кластера Always On (программа установки) и Восстановление после сбоя экземпляра отказоустойчивого кластера.
- Ошибка операционной системы. В этом случае данный узел отключен, но не является окончательно неисправным. Для восстановления после сбоя ОС восстановите данный узел и проверьте отработку отказа. Если данный экземпляр SQL Server не переключается на другой ресурс должным образом, необходимо программой установки SQL Server удалить SQL Server из отказоустойчивого кластера, произвести необходимые восстановительные процедуры, восстановить резервную копию и снова добавить восстановленный узел к экземпляру отказоустойчивого кластера. Восстановление по журналу после сбоя ОС может занять значительное время. Если восстановить ОС после сбоя можно более простым способом, не прибегайте к этому методу. Дополнительные сведения см. в статьях Создание нового экземпляра отказоустойчивого кластера Always On (программа установки) и Восстановление после сбоя экземпляра отказоустойчивого кластера.
Разрешение общих проблем
В следующем списке приведено описание общих проблем и даны объяснения по их устранению.
Проблема. Неверное использование синтаксиса командной строки при установке SQL Server
Причина 1. Диагностировать проблемы программы установки при использовании в командной строке параметра /qn трудно, поскольку параметр /qn подавляет все диалоговые окна программы установки и сообщения об ошибках. Если указан параметр /qn , все сообщения программы установки, включая сообщения об ошибках, записываются в файлы журналов программы установки. Дополнительные сведения о файлах журналов см. в разделе Просмотр и чтение файлов журналов программы установки SQL Server.
Решение 1. Используйте параметр /qb вместо /qn. При использовании параметра /qb на каждом шаге отображается интерфейс пользователя, в том числе сообщения об ошибках.
Проблема. Серверу SQL Server не удается подключиться к сети после его перемещения на другой узел.
Причина 1. Учетные записи службы SQL Server не могут связаться с контроллером домена.
Решение 1. Проверьте журналы событий на наличие записей о проблемах сети, например о сбоях адаптеров или проблемах с DNS. Проверьте контроллер домена командой ping.
Причина 2. Пароли к учетным записям службы SQL Server отличаются на разных узлах кластера, или узел не перезапускает службу SQL Server, которая была перенесена с неисправного узла.
Решение 2. Измените пароли учетной записи службы SQL Server с помощью диспетчера конфигурации SQL Server. Если это не было сделано, а пароли учетной записи службы SQL Server изменены на одном узле, необходимо также изменить их на всех остальных узлах. SQL Server выполняет это автоматически.
Проблема. SQL Server не может получить доступ к дискам кластера.
Причина 1. Встроенное ПО или драйверы обновлены не на всех узлах.
Решение 1. Проверьте, установлены ли на всех узлах правильное встроенное ПО и одинаковые версии драйверов.
Причина 2. Узел не может восстановить диски кластера, перенесенные с неисправного узла на общий диск кластера с другой буквой диска.
Решение 2. Буквы для дисков кластера должны совпадать на обоих серверах. Если это не так, проверьте исходную установку ОС и службы кластеров (MSCS) Microsoft .
Проблема. Сбой службы SQL Server вызывает отработку отказа.
Решение. Чтобы сбой определенных служб не вызывал перехода группы SQL Server на другой ресурс, настройте эти службы при помощи программы администрирования кластеров Windows следующим образом.
- Сбросьте флажок Применить к группе на вкладке Дополнительно диалогового окна Свойства полного текста . Однако, если SQL Server вызовет отработку отказа, служба полнотекстового поиска будет перезапущена.
Проблема. SQL Server не запускается автоматически.
Решение. С помощью администратора кластеров в MSCS настройте автоматический запуск отказоустойчивого кластера. Не следует настраивать службу SQL Server для запуска вручную, нужно настроить приложение «Администратор кластеров» в MSCS для запуска службы SQL Server . Дополнительные сведения см. в разделе Управление службами.
Проблема. Сетевой ресурс, к которому выполняется обращение по имени, находится не в сети, и нельзя подключиться к SQL Server по протоколу TCP/IP.
Причина 1. Сбой службы DNS, в то время как для ресурсов кластера настроено использование DNS.
Решение 1. Устраните проблемы с DNS.
Причина 2. Повторяющееся имя в сети.
Решение 2. С помощью программы NBSTAT найдите повторяющееся имя и устраните проблему.
Причина 3. Не удается соединиться с SQL Server с помощью именованных каналов.
Решение 3. Для подключения через именованные каналы создайте псевдоним с помощью диспетчера конфигурации SQL Server, чтобы подключиться к нужному компьютеру. Например, при использовании кластера с двумя узлами (Узел A и Узел B) и экземпляра отказоустойчивого кластера (Virtsql) с экземпляром по умолчанию подключиться к серверу, ресурс сетевого имени которого находится вне сети, можно, выполнив следующие шаги.
- При помощи администратора кластеров определите, на каком узле группы запущен экземпляр SQL Server . Например, это Узел A.
- Запустите службу SQL Server на этом компьютере с помощью команды net start. Дополнительные сведения об использовании команды net startсм. в разделе Запуск SQL Server вручную.
- Запустите диспетчер конфигурации SQL Server на Узле A. Просмотрите именованный канал, по которому прослушивает этот сервер. Название будет похоже на \\.\$$\VIRTSQL\pipe\sql\query.
- На клиентском компьютере запустите диспетчер конфигурации SQL Server.
- Создайте псевдоним SQLTEST1 для соединения с этим каналом по протоколу именованных каналов. Для этого укажите Узел A в поле имени сервера и измените имя канала на \\.\pipe\$$\VIRTSQL\sql\query.
- Подключитесь к экземпляру сервера с использованием псевдонима SQLTEST1 в качестве имени сервера.
Проблема. Программа установки SQL Server в кластере завершилась с кодом ошибки 11001.
Проблема. Потерян раздел реестра в ветке [HKEY_LOCAL_MACHINE\SOFTWARE\Microsoft\Microsoft SQL Server\MSSQL.X\Cluster].
Решение. Убедитесь в том, что куст реестра MSSQL.X в настоящее время не используется, и удалите этот ключ кластера.
Проблема. Ошибка установки кластера: «У установщика недостаточно прав доступа к каталогу: \Microsoft SQL Server. Невозможно продолжить установку. Войдите в систему как администратор или обратитесь к системному администратору»
Проблема. Эта ошибка произошла из-за неправильного разбиения на разделы общего диска SCSI.
Решение. Создайте повторно один раздел на этом общем диске, выполнив указанные ниже действия.
- Удалите данный дисковый ресурс из кластера.
- Удалите на этом диске все разделы.
- Проверьте в свойствах диска, что он является основным.
- Создайте на этом общем диске один раздел, отформатируйте диск и присвойте ему букву.
- Добавьте этот диск к кластеру с помощью администратора кластеров (cluadmin).
- Запустите программу установки SQL Server .
Проблема. Приложениям не удается включить ресурсы SQL Server в список в распределенной транзакции.
Причина. Поскольку координатор распределенных транзакций Microsoft (MS DTC) настроен в Windows не полностью, то приложениям, возможно, не удастся прикрепить ресурсы SQL Server к распределенной транзакции. Эта проблема касается связанных серверов, распределенных запросов и удаленных хранимых процедур, использующих распределенные транзакции. Дополнительные сведения о настройке MS DTC см. в разделе Before Installing Failover Clustering.
Решение. Для предотвращения этой проблемы необходимо полностью включить службы MS DTC на серверах, на которых установлен SQL Server и настроен MS DTC.
Для полного включения служб MS DTC выполните следующие шаги.
- На панели управления откройте Администрирование, затем Управление компьютером.
- В левой панели окна «Управление компьютером» раскройте Службы и приложенияи щелкните Службы.
- В правой панели окна «Управление компьютером» щелкните правой кнопкой мыши Координатор распределенных транзакцийи выберите Свойства.
- В окне Координатор распределенных транзакций перейдите на вкладку Общие и нажмите кнопку Стоп , чтобы остановить службы.
- В окне Координатор распределенных транзакций перейдите на вкладку Вход в систему и выберите в качестве учетной записи входа NT AUTHORITY\NetworkService.
- Нажмите кнопки Применить и ОК , чтобы закрыть окно Координатор распределенных транзакций . Закройте окно Управление компьютером . Закройте окно Администрирование .
Использование расширенных хранимых процедур и объектов COM
При использовании расширенных хранимых процедур в конфигурациях с отказоустойчивой кластеризацией все такие процедуры должны быть установлены на диск кластера под управлением SQL Server. Это обеспечивает возможность использования расширенных хранимых процедур после перехода узла на другой ресурс.
Если эти расширенные хранимые процедуры используют компоненты COM, администратор должен зарегистрировать эти компоненты на каждом узле кластера. Чтобы компоненты COM можно было создать, сведения для их загрузки и выполнения должны содержаться в реестре активного узла. Иначе эти сведения содержатся в реестре компьютера, на котором эти компоненты COM были зарегистрированы в первый раз.
Настройка групп доступности Always On в SQL Server

26.02.2020

insci

SQL Server, Windows Server 2019

комментариев 8
В этой статье мы рассмотрим пошаговую установку и настройку групп доступности Always On в SQL Server в Windows Server 2019, рассмотрим сценарии отработки отказов и ряд других смежных вопросов.
“Always On Availability Groups” или “Группы доступности Always On” это технология для обеспечения высокой доступности в SQL Server. Always On появились в релизе Microsoft SQL Server 2012.
Особенности групп доступности Always On в SQL Server
Для чего могут использоваться группы доступности SQL Server?
- Высокая доступность MS SQL и автоматическая отработка отказа;
- Балансировка нагрузки select запросов между узлами (вторичные реплики могут быть доступны для чтения);
- Резервное копирование с вторичных реплик;
- Избыточность данных. Каждая реплика хранит копии баз данных группы доступности.
Always On работает на платформе Windows Server Failover Cluster (WSFC). WSFC обеспечивает мониторинг узлов участвующих в группе доступности и может осуществлять автоматическую отработку отказа посредством голосования между узлами. Начиная с MS SQL Server 2017 появилась возможность использовать Always On без WSFC, в том числе на Linux системах. При построении кластера на Linux можно использовать Pacemaker как альтернативу WSFC.
Always On доступен в Standard редакции, но с некоторыми ограничениями:
-
Лимит на 2 реплики (основную и вторичную);
В редакции Enterprise ограничений нет.
Особенности лицензирования MS SQL Server.
Разберемся в терминологии:
- Группу доступности Always ON – это набор реплик и баз данных;
- Реплика – это экземпляр SQL Server находящийся в группе доступности. Реплика может быть основная (primary) и вторичная (secondary). Каждая реплика может содержать одну или более баз данных.
В основе Always On лежит WSFC. Каждый узел группы доступности должен быть членом отказоустойчивого кластера Windows. Каждый экземпляр SQL Server может иметь несколько групп доступности. В каждой группе доступности может быть до 8 вторичных реплик.
При отказе основой реплики, кластер проголосует за новую основную реплику и Always On переведёт одну из вторичных реплик в статус основной. Так как при работе с Always On пользователи соединяются с прослушивателем кластера (или Listener, то есть специальный IP адрес кластера и соответствующее ему DNS имя), то возможность выполнять write запросы полностью восстановится. Прослушиватель также отвечает за балансировку select запросов между вторичными репликами.
Настройка Windows Server Failover Cluster для Always On
Прежде всего нам нужно настроить отказоустойчивый кластер на всех узлах, которые будут участвовать в Always On.
- 2 виртуальных машины на Hyper-V с Windows Server 2019;
- 2 экземпляра SQL Server 2019 редакции Enterprise;
В Server Manager добавляем роль Failover Clustering, или установите компонент с помощью PowerShell:
Install-WindowsFeature –Name Failover-Clustering –IncludeManagementTools
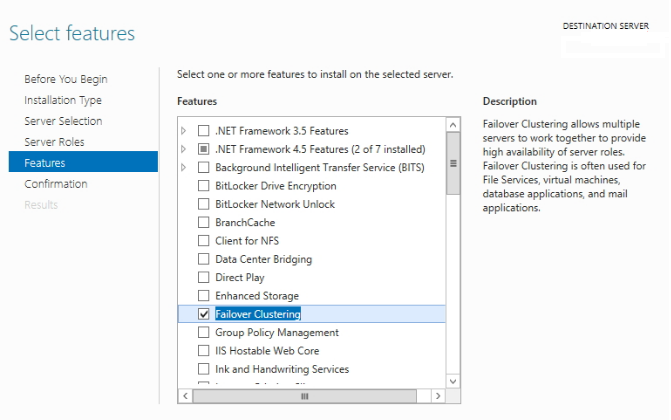
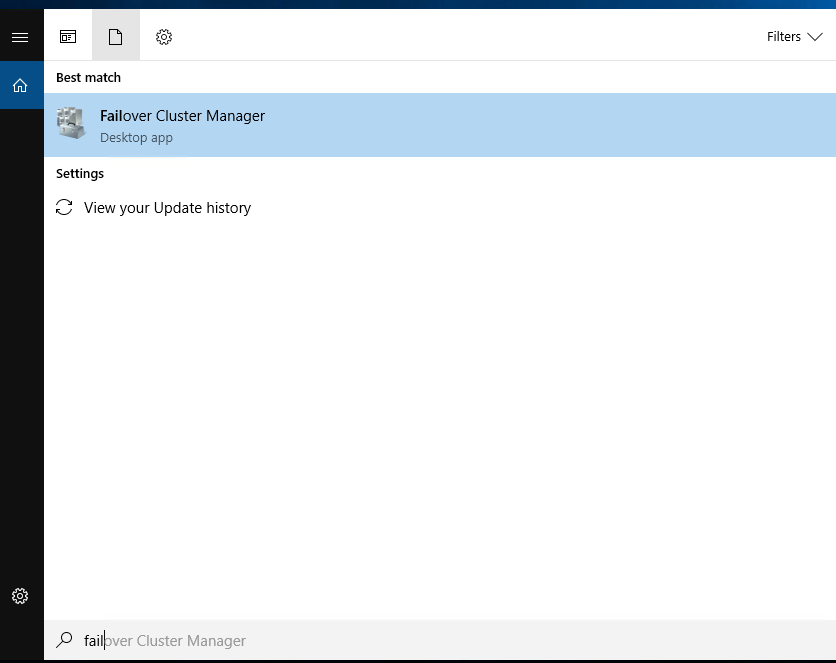
Установка автоматическая, ничего настраивать пока не нужно. После окончания установки запустите оснастку Failover Cluster Manager (FailoverClusters.SnapInHelper.msc).
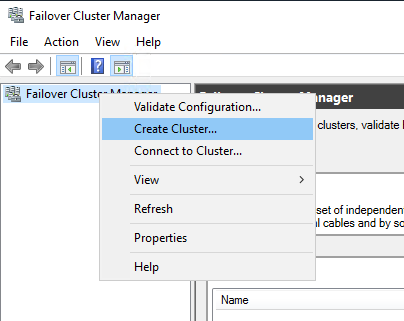
Создаём новый кластер.
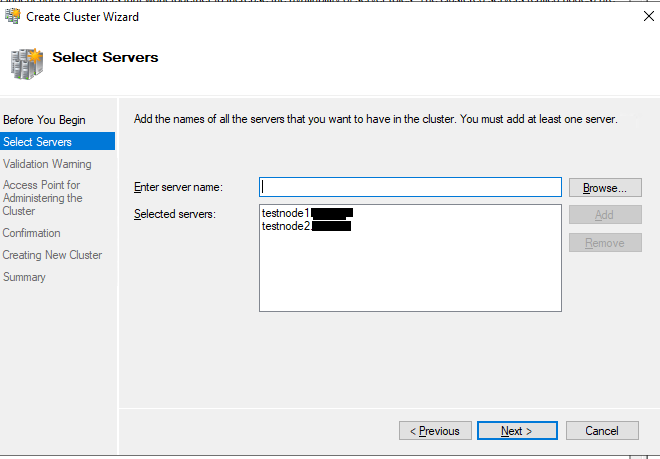
Добавляем имена серверов, которые будут участвовать в кластере.
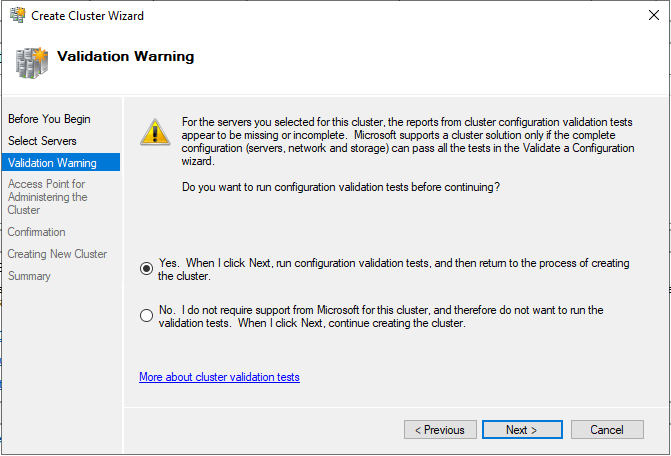
Дальше мастер предлагает пройти тесты. Не отказываемся, выбираем первый пункт.
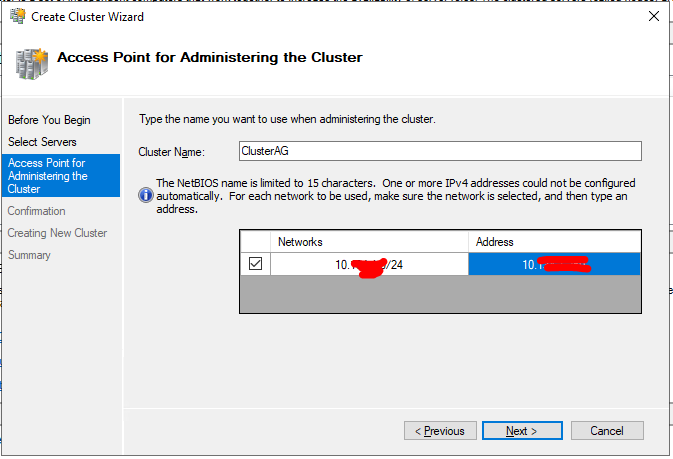
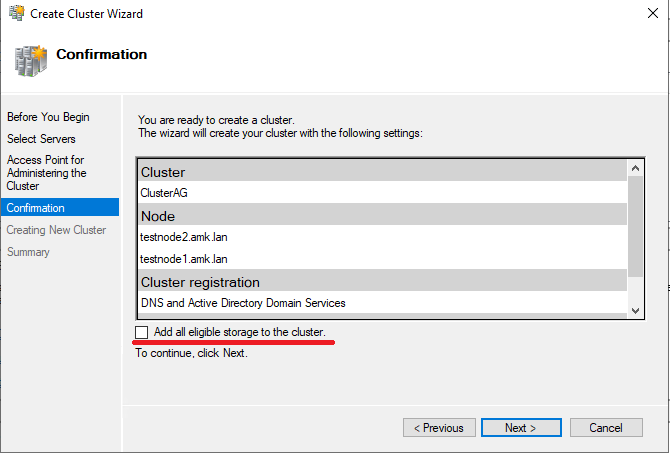
Указываем имя кластера, выбираем сеть и IP адрес кластера. Имя кластера автоматически появится в DNS, прописывать его специально не нужно. В моём случае имя кластера – ClusterAG.
Убираем чебокс “Add all eligible storage to the cluster”, так как диски мы сможем добавить позже.
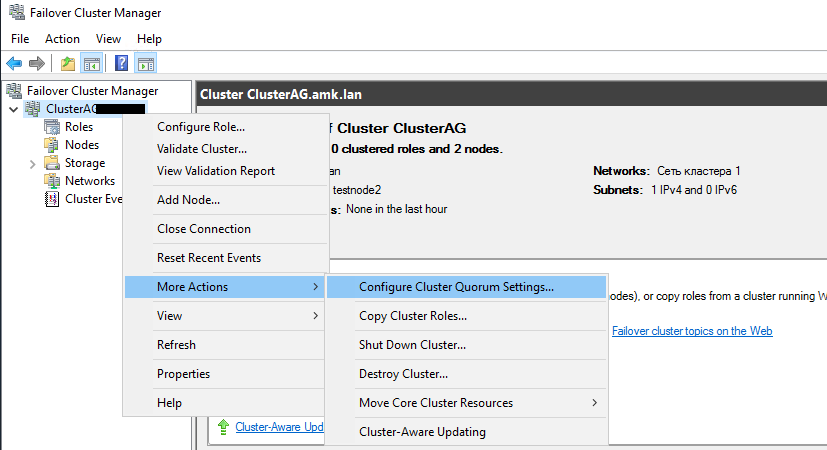
Узлов в кластере всего 2, поэтому необходимо настроить Cluster Quorum. Кворум кластера — это “решающий голос”. Например, если один из узлов кластера становится недоступен, кластеру необходимо определить какие узлы на самом деле доступны и могут видеть друг друга. Кворум нужен для согласованности кластера (Cluster -> More Actions -> Configure Cluster Quorum Settings).
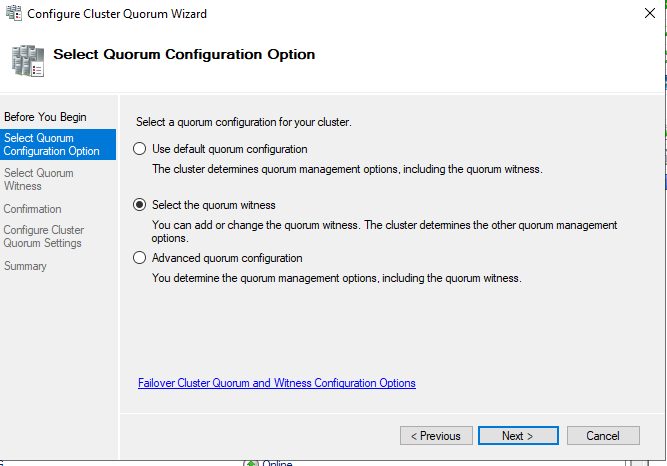
Выберите тип кворума со свидетелем (quorum witness).
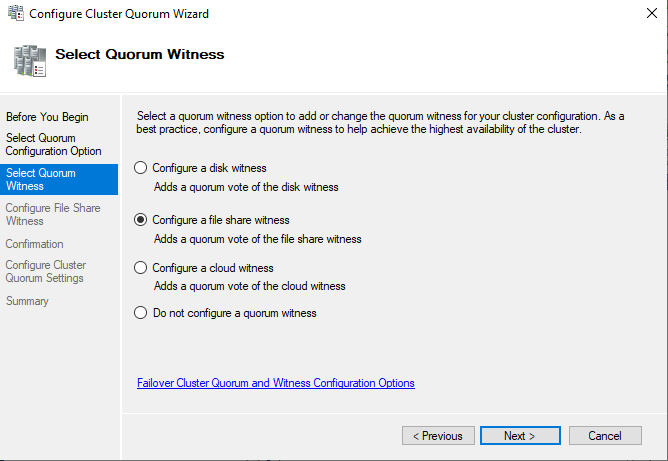
Затем выбираем тип свидетеля – сетевая папка (file share witness).
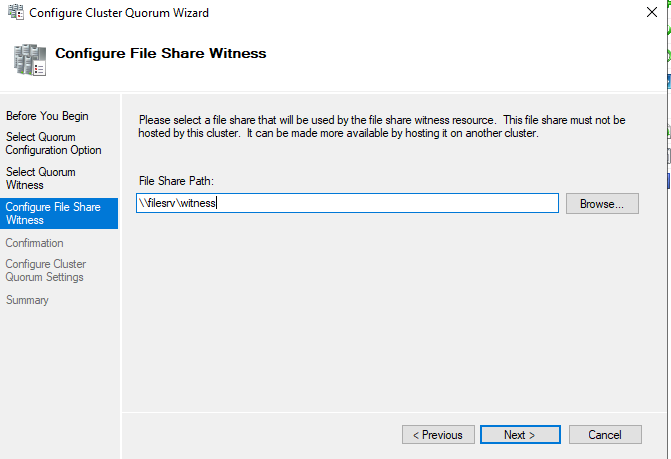
Укажите UNC путь к сетевой папке. Эту директорию нужно создать самостоятельно, и она обязательно должна быть на сервере, который не участвует в кластере.
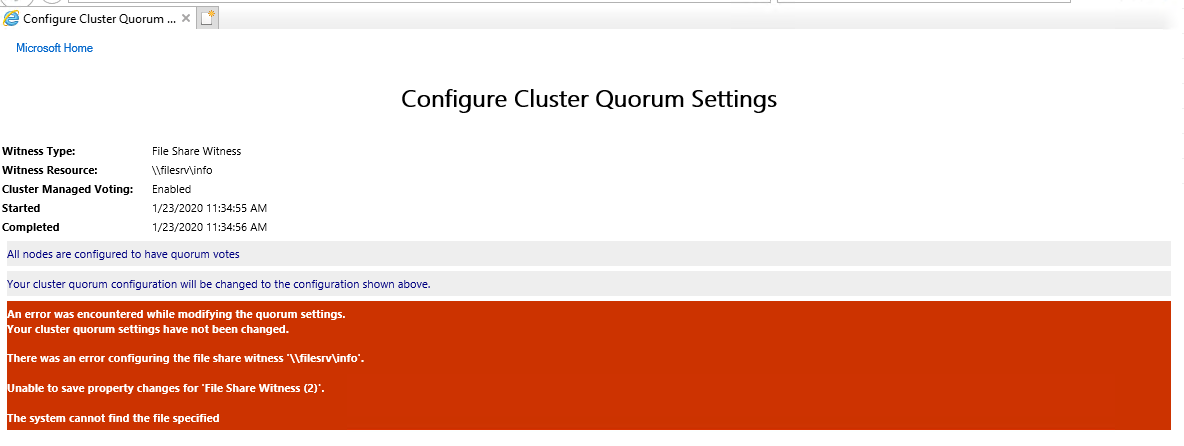
При настройке кластера вы можете получить ошибку:
There was an error configuring the file share witness. Unable to save property changes for File Share Witness. The system cannot find the file specified.
Скорее всего это значит, что у пользователя из-под которого работает кластер нет прав на эту сетевую папку. По-умолчанию кластер работает из-под локального пользователя. Вы можете дать права на эту папку всем компьютерам кластера, либо сменить аккаунт для службы кластера и раздать права ему.
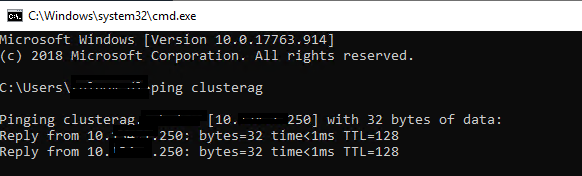
На этом базовая конфигурация кластера закончена. Убедимся, что DNS кластера прописан и отдаёт правильный IP
Настройка Always On в MS SQL Server
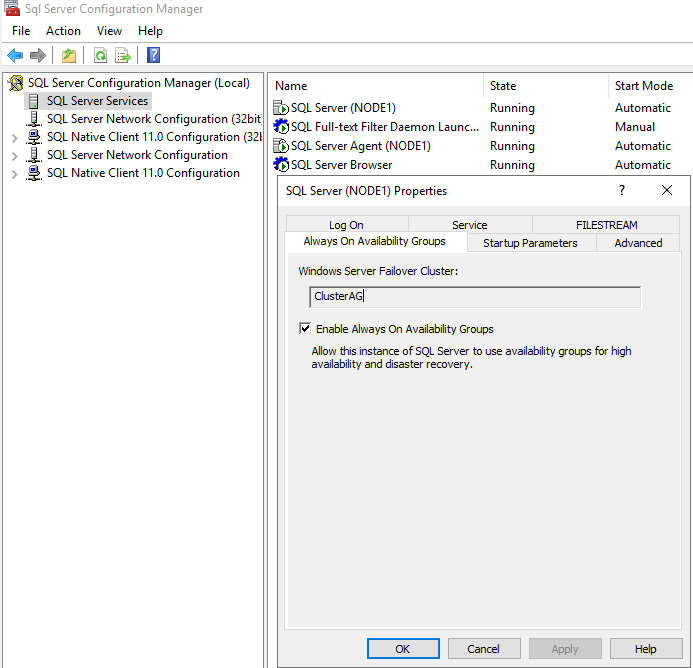
После стандартной установки экземпляра SQL Server вы можете включить и настроить группы доступности Always On. Их нужно включить в SQL Server Configuration Manager в свойствах экземпляра. Как видно на скриншоте, SQL Server уже определил, что он является участником кластера WSFC. Поставьте чекбокс “Enable Always On Availability Groups” и перезагрузите службу экземпляра MSSQL. Выполните те же действия на втором экземпляре.
Совет.. Перед настройкой Always On убедитесь, что службы SQL Server работают не из-под локального аккаунта системы. Рекомендуется использовать Group Managed Service Accounts или обычный доменный аккаунт. В противном случае вы не сможете завершить настройку Always On.
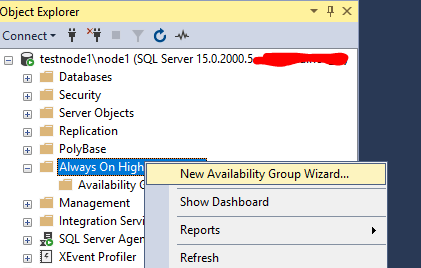
В SQL Server Management Studio щелкните по узлу “Always On High Availability” и запустите мастер настройки группы доступности (New Availability Group Wizard).
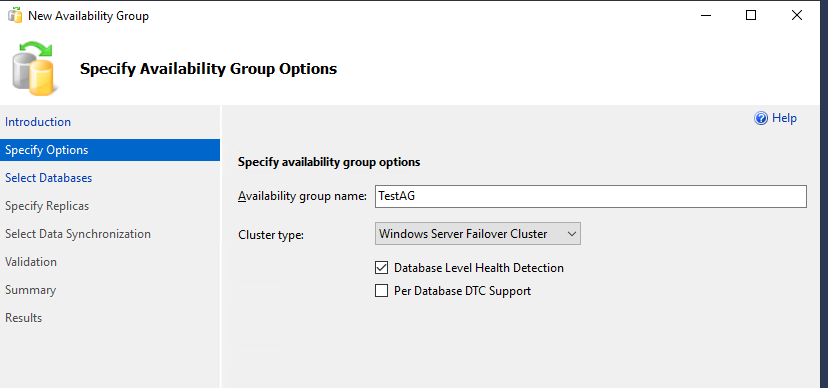
Укажите имя группы доступности Always On и выберите опцию “Database Level Health Detection”. С этой опцией Always On сможет определять, когда база данных находится в нездоровом состоянии.
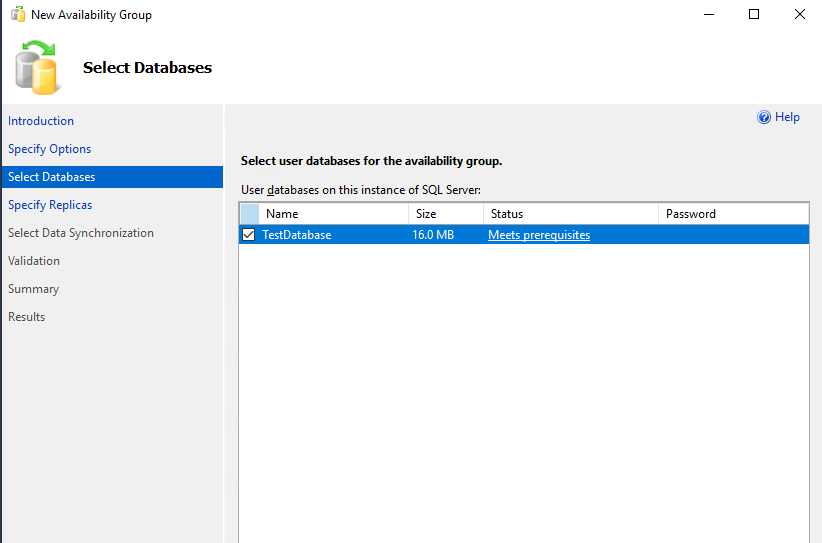
Выберите базы данных SQL Server, которые будут участвовать в группе доступности Always On.
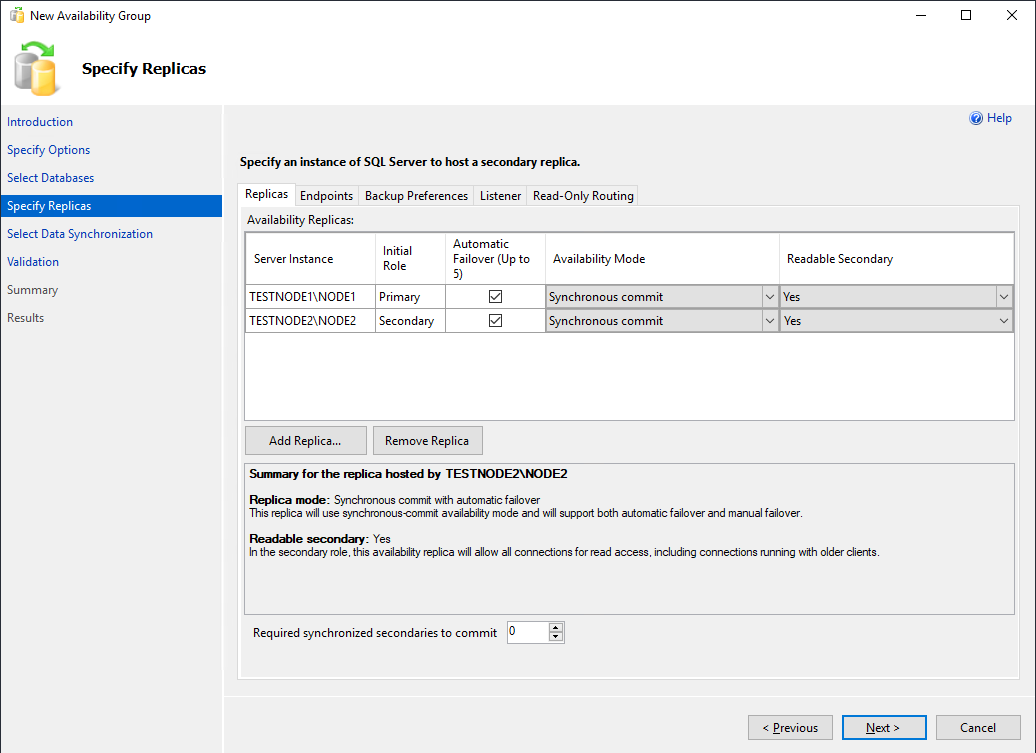
Нажмите “Add Replica…” и подключитесь к второму серверу SQL. Таким образом можно добавить до 8 серверов.
- Initial Role – роль реплики на момент создания группы. Может быть Primary и Secondary;
- Automatic Failover – если база данных станет недоступна, Always On переведёт primary роль на другую реплику. Отмечаем чекбокс;
- Availability Mode – возможно выбрать Synchronous Commit или Asynchronous Commit. При выборе синхронного режима, транзакции, поступающие на primary реплику, будут отправлены на все остальные вторичные реплики с синхронным режимом. Primary реплика завершит транзакцию только после того, как реплики запишут транзакцию на диск. Таким образом исключается возможность потери данных при сбое primary реплики. При асинхронном режиме основная реплика сразу записывает изменения, не дожидаясь ответа от вторичных реплик;
- Readable Secondary – параметр задающий возможность делать select запросы к вторичным репликам. При значении yes, клиенты даже при соединении без ApplicationIntent=readonly смогут получить read-only доступ;
- Required synchronized secondaries to commit – число синхронизированных вторичных реплик для завершения транзакции. Нужно выставлять в зависимости от количества реплик, я поставлю 1. Имейте в виду, что, если вторичных синхронизированных реплик станет меньше указанного числа (например, при аварии), базы данных группы доступности станут недоступны даже для чтения.
Вкладку Endpoints не трогаем.
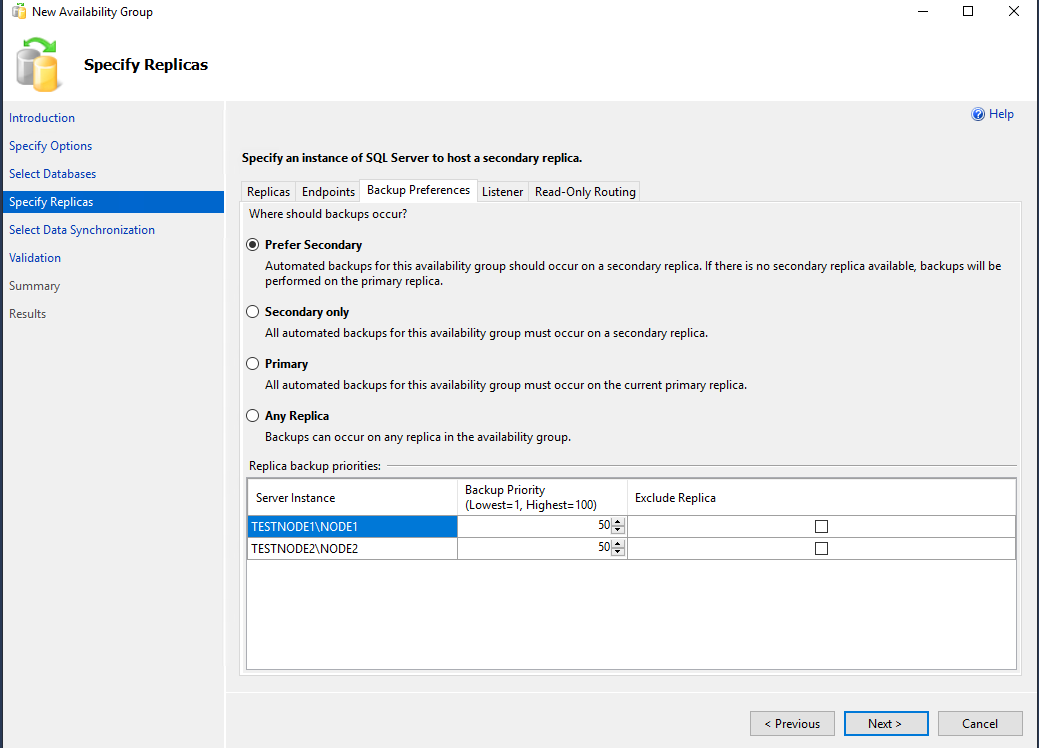
На вкладке Backup Preferences можно выбрать откуда будут делаться бекапы. Оставляем всё по умолчанию – Prefer Secondary.
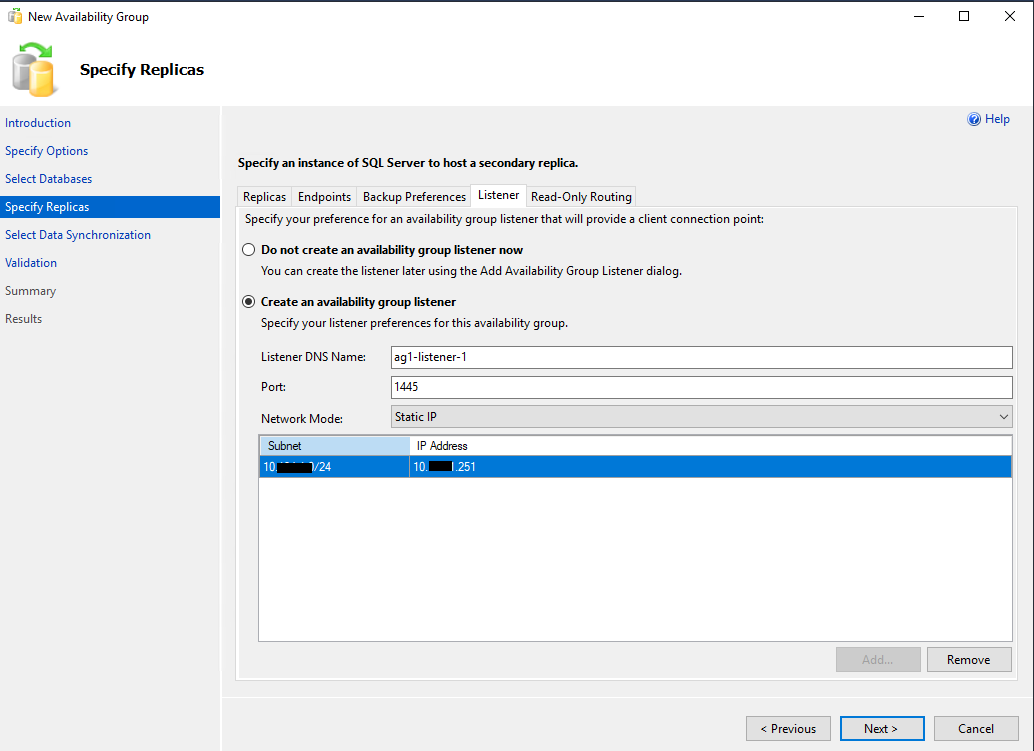
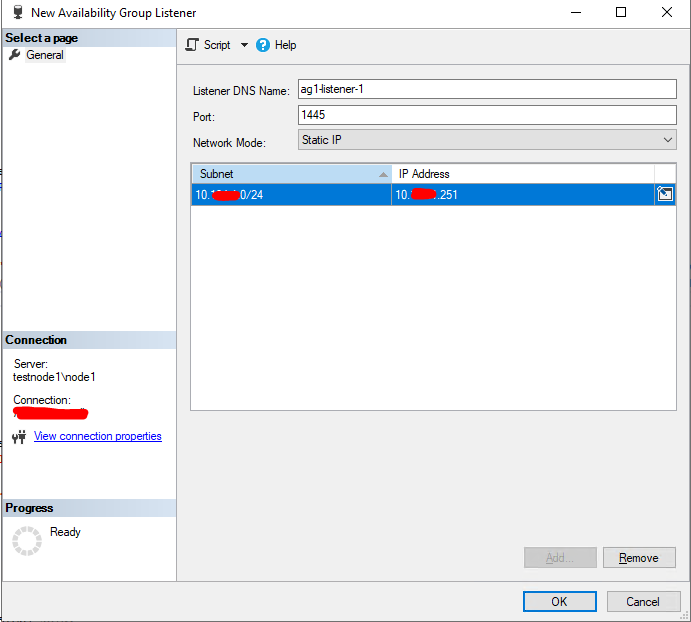
Указываем имя слушателя группы доступности (availability group listener), порт и IP адрес.
Вкладку Read-Only Routing оставляем без изменений.
Выбираем каким образом будут синхронизироваться реплики. Я оставляю первый пункт – автоматическую синхронизацию (Automatic seeding).
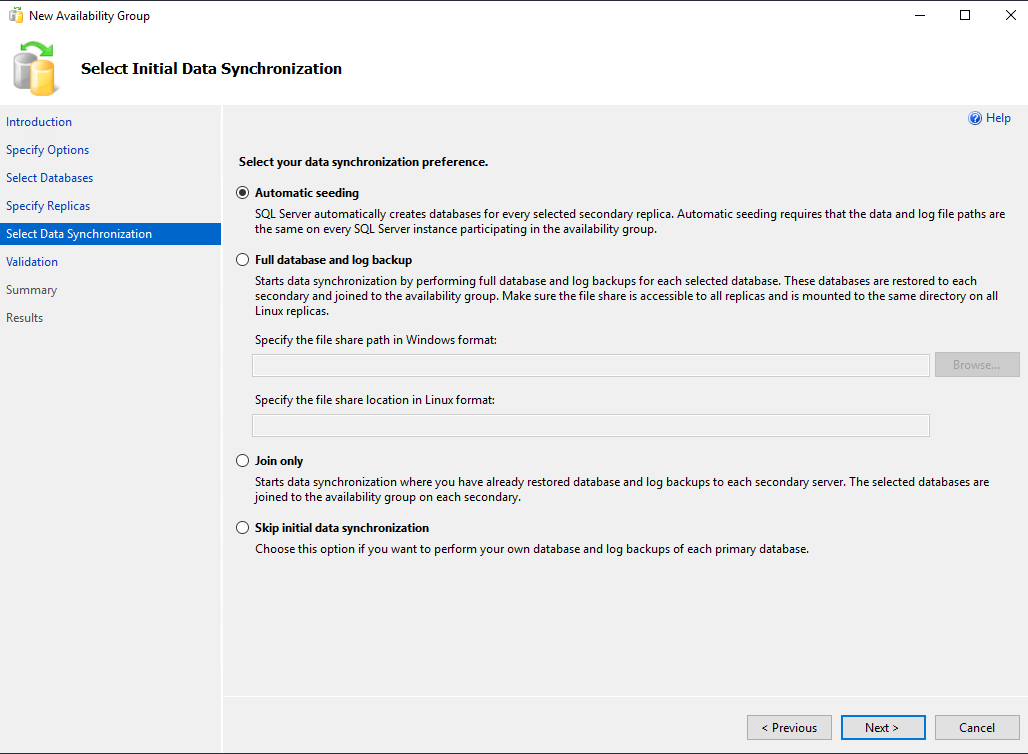
После этого ваши настройки должны пройти валидацию. Если ошибок нет, нажмите Finish для применения изменений.
В моём случае все тесты прошли успешно, но после установки на шаге Results, мастер сообщил об ошибке при создании слушателя группы доступности. В логах кластера была такая ошибка:
Cluster network name resource failed to create its associated computer object in domain.
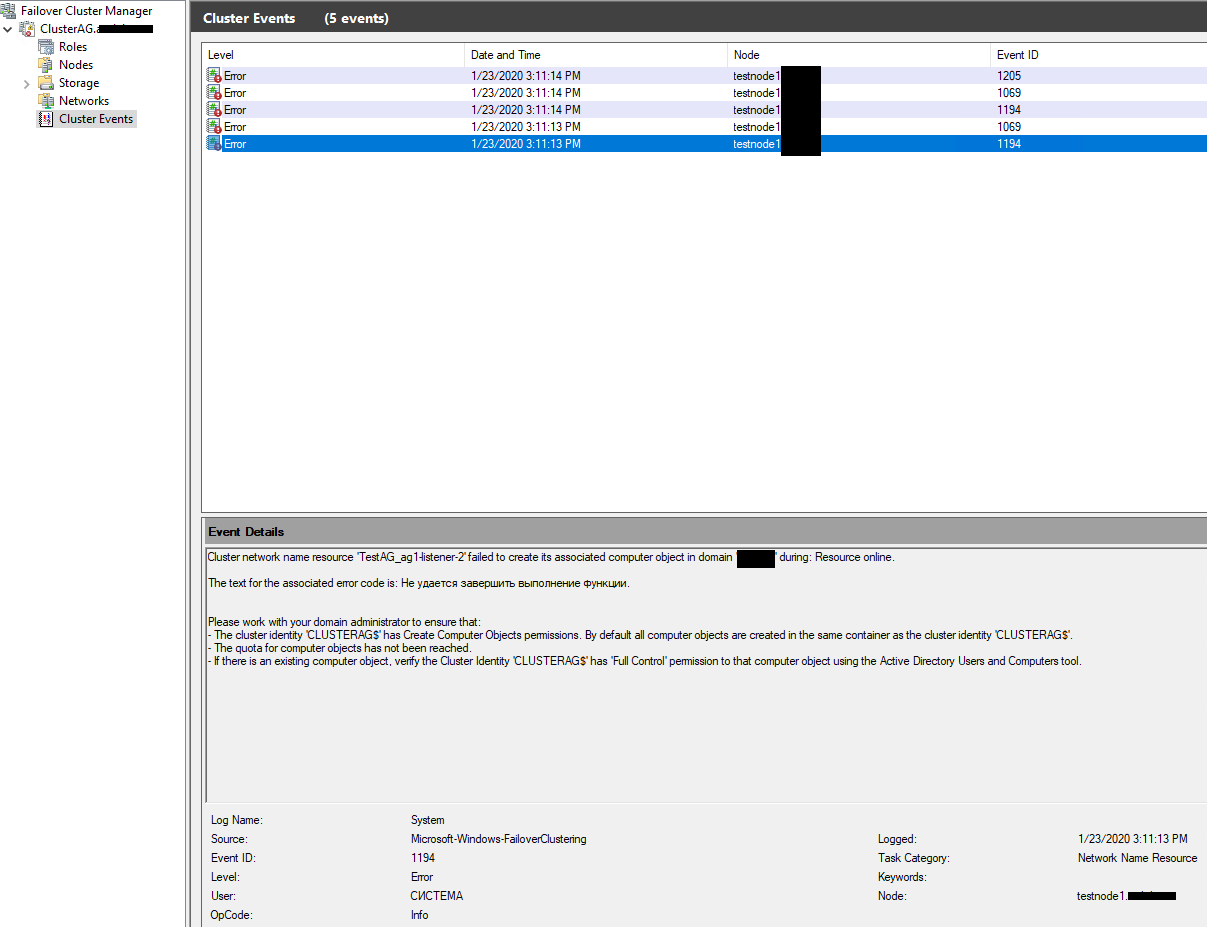
Это означает, что у кластера недостаточно прав для создания слушателя. В документации написано, что достаточно дать разрешение на создание объектов типа “компьютер” объекту вашего кластера. Проще всего это сделать через делегирование полномочий в AD (или, быстрый но плохой вариант — временно добавить объект CLUSTERAG$ в группу Domain Admins).
При диагностике проблем с Always ON и низкой производительностью SQL в группе доступности, кроме стандартных средств диагностики SQL Server, нужно внимательно смотреть логи кластера Windows.
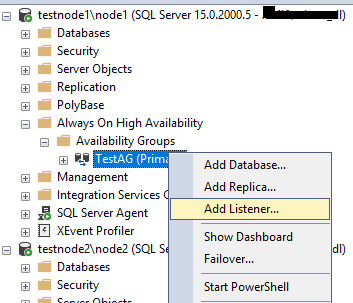
Так как группа доступности у меня создалась, а слушатель нет, я добавил его вручную. Вызываем контекстное меню на группе доступности и жмем Add Listener…
Укажите IP адрес, порт и DNS имя слушателя.
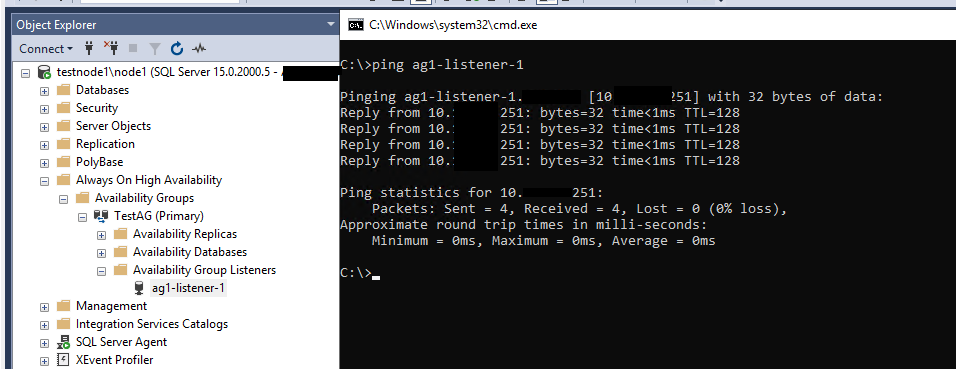
Проверьте, что Listener появился во разделе доступных слушателей группы Always On.
На этом базовая настройка группы доступности Always On закончена.
Always On: проверка работы, автоматическая отработка отказа
Посмотрим на панель мониторинга групп доступности (Show Dashboard).
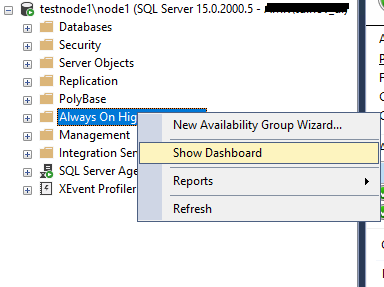
Все OK, группа доступности создана и работает.
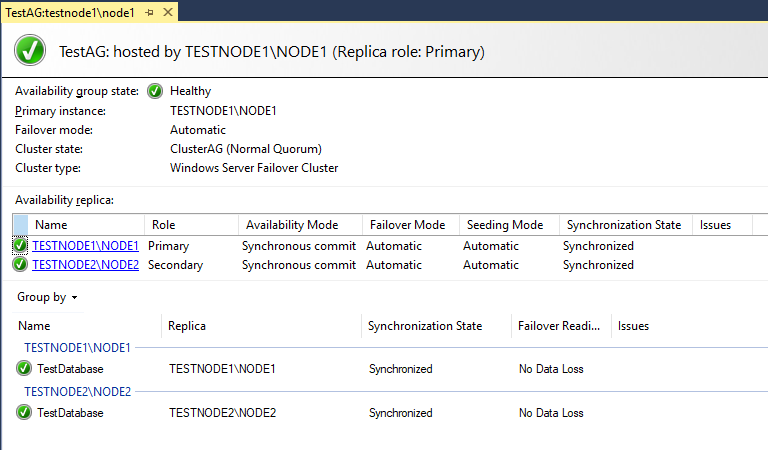
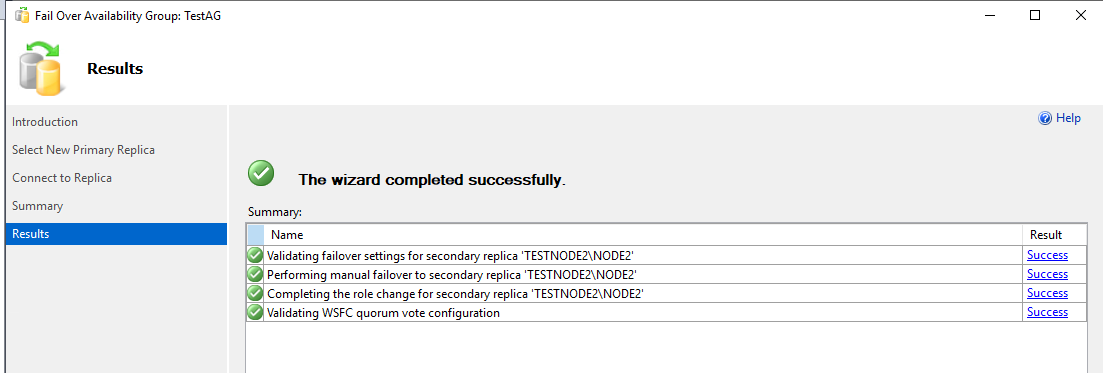
Попробуем перевести основную роль на экземпляр node2 в ручном режиме. Щелкните ПКМ по группе доступности и выберите Failover.
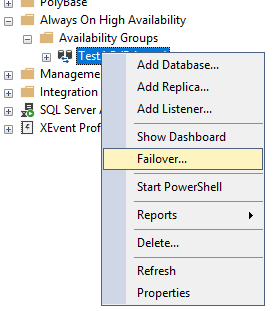
Стоит обратить внимание на пункт Failover Readiness. Значение No data loss значит, что потеря данных при переходе исключена.
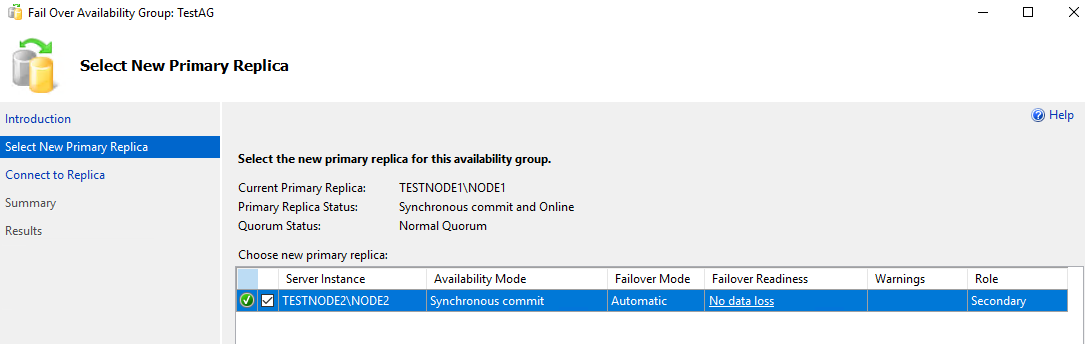
Соединяемся с node2.
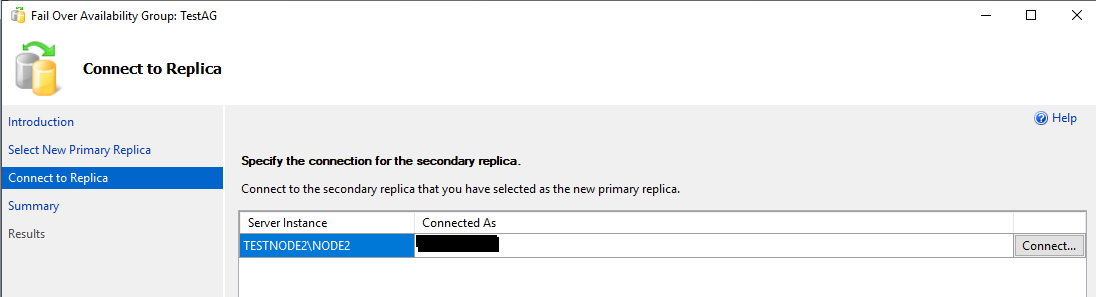
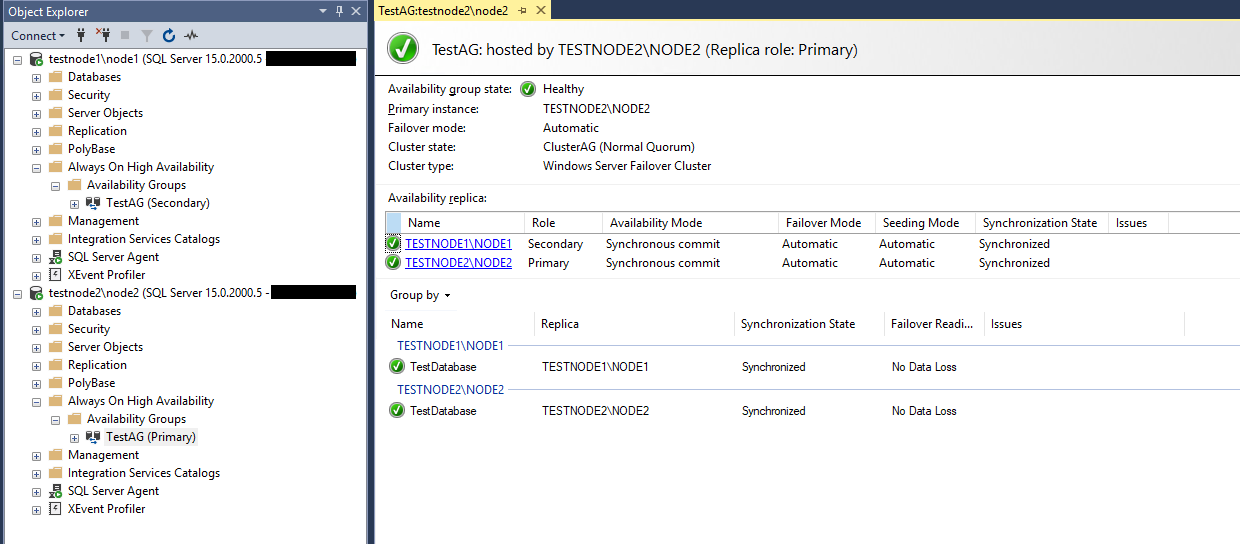
Проверяем, что node2 стал основной репликой в группе доступности (Primary Instance).
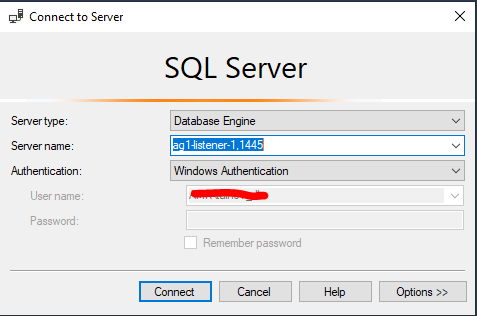
Убедимся, что слушатель работает как надо. В SSMS укажите DNS имя слушателе и порт через запятую: ag1-listener-1,1445
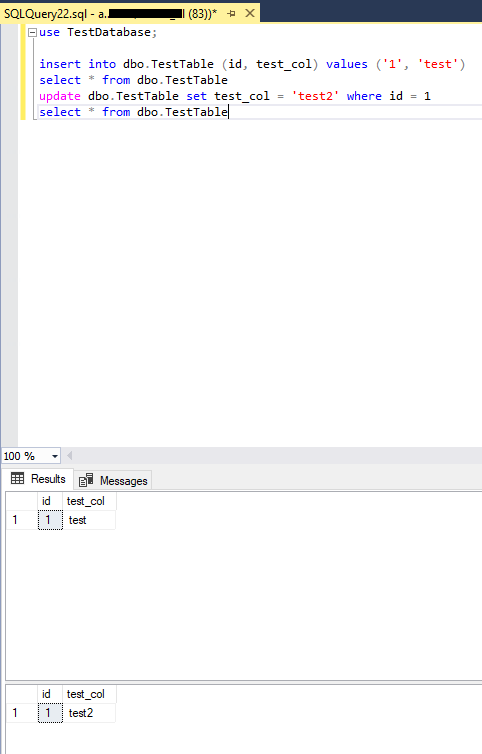
Сделаем простые insert, select и update запросы в нашу базу SQL Server.
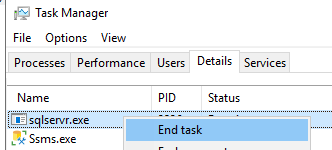
Теперь проверим автоматическую отработку отказа основной реплики. Просто завершите процесс sqlservr.exe на TESTNODE2.
Проверяем состояние группы доступности на оставшемся узле – TESTNODE1\NODE1.
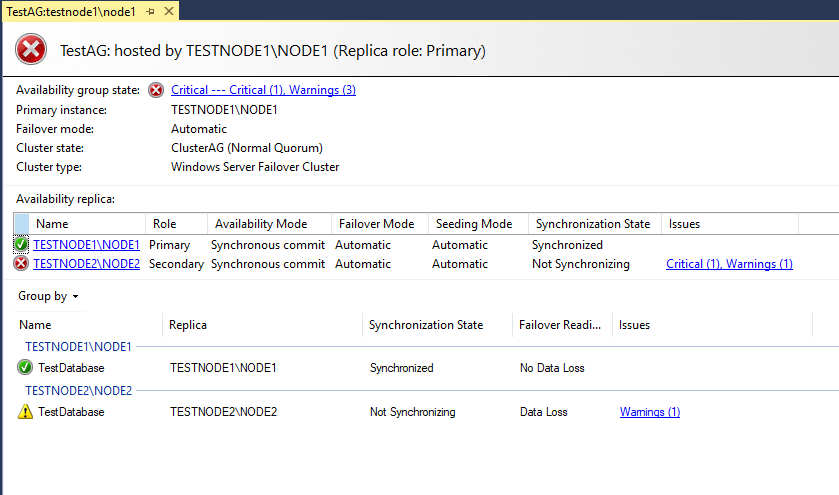
Кластер автоматически перевёл статус реплики testnode1\node1 в primary, так как testnode2\node2 стал недоступен.
Проверим состояние слушателя, потому что соединения клиентов будут поступать именно на него.
В моём случае я успешно соединился со слушателем, но при доступе к базе данных появилась ошибка
Unable to access database 'TestDatabase' because it lacks a quorum of nodes for high availability. Try the operation again later.

Эта ошибка возникла из-за параметра “Required synchronized secondaries to commit”. Так как при настройке мы выставляли это значение в 1, Always On не даёт подключиться к базе данных, потому что у нас осталась всего одна primary реплика.
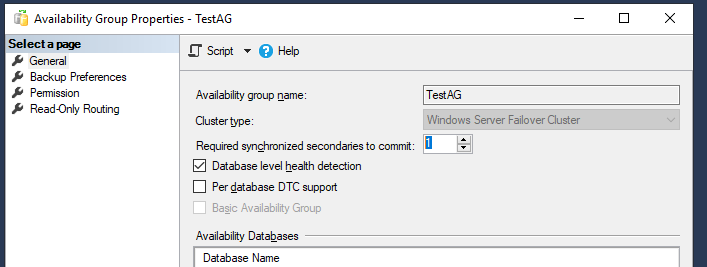
Установим это значение в 0 и попробуем снова.
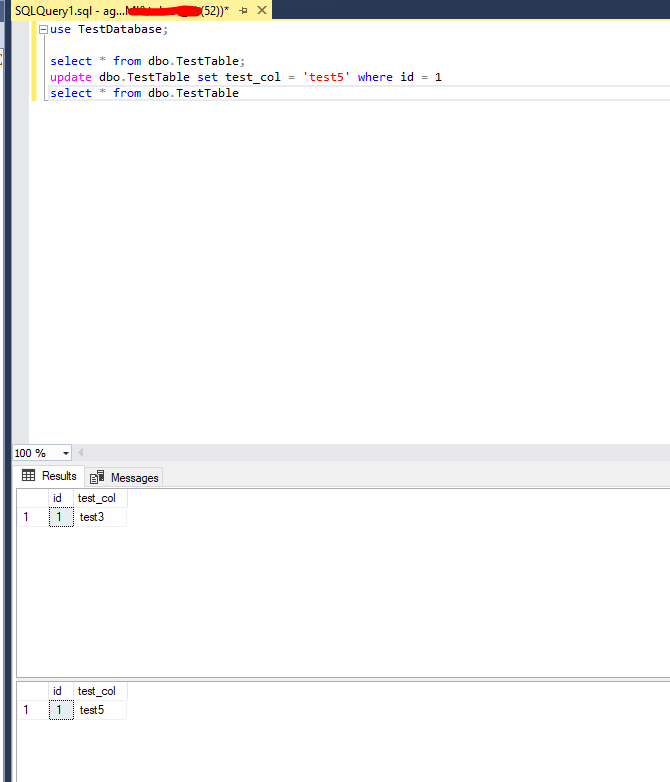
Включаем testnode2 и проверяем статус группы.
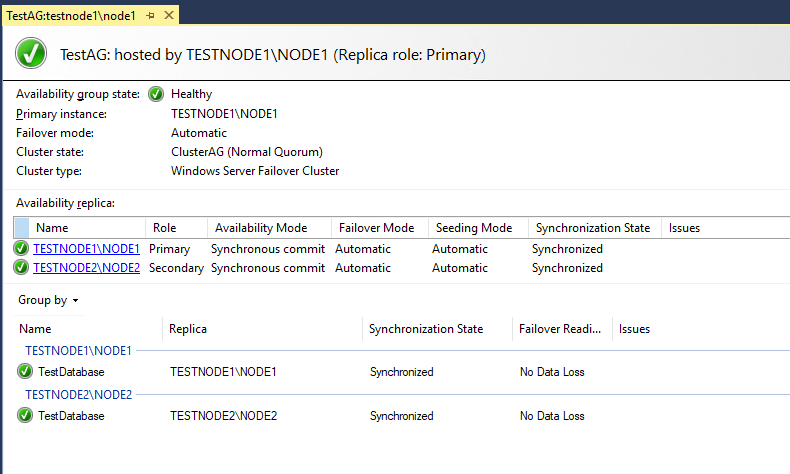
Статус Primary реплики остался у testnode1, а testnode2 стал вторичной репликой. Данные, которые мы меняли на testnode1 при выключенной testnode2 успешно синхронизировались после включения машины.
На этом тестирование закончено. Мы убедились всё работает корректно и при критическом сбое данные останутся доступны для read/write доступа.
Помимо Always On в SQL Server есть еще несколько технологий обеспечения высокой доступности. Например, вы можете настроить транзакционную репликацию между несколькими серверами SQL Server даже в Standard редакции.
Группы доступности Always On достаточно просты в настройке. Если перед вами стоит задача построить отказоустойчивое решение на базе SQL Server, то группы доступности отлично справятся с этой задачей.
С выпуском SQL Server 2017 и SQL Server 2019 в SQL Server Management Studio 18.x появились настройки Always On, которые раньше были доступны только через T-SQL, поэтому рекомендуется пользоваться последней версией SSMS.
 Предыдущая статья Следующая статья

Как развернуть отказоустойчивый кластер MS SQL Server 2012 на Windows Server 2012R2 для новичков
Данный топик будет интересен новичкам. Бывалые гуру и все, кто уже знаком с этим вопросом, вряд ли найдут что-то новое и полезное. Всех остальных милости прошу под кат.
Задача, которая стоит перед нами, – обеспечить бесперебойную работу и высокую доступность базы данных в клиент-серверном варианте развертывания.
Тип конфигурации — active/passive.
P.S. Вопросы резервирования узлов не относящихся к MSSQL не рассмотрены.
Этап 1 — Подготовка
- Наличие минимум 2-х узлов(физических/виртуальных), СХД
- MS Windows Server, MS SQL ServerСХД
- СХД
- Доступный iSCSI диск для баз данных
- Доступный iSCSI диск для MSDTC
- Quorum диск
- Windows Server 2012R2 с ролями AD DS, DNS, DHCP(WS2012R2AD)
- Хранилище iSCSI*
- 2xWindows Server 2012R2(для кластера WS2012R2C1 и WS2012R2C2)
- Windows Server 2012R2 с поднятой службой сервера 1С (WS2012R2AC)
Технически можно обойтись 3 серверами совместив все необходимые роли на домен контроллере, но в полевых условиях так поступать не рекомендуется.
Вначале вводим в домен сервера WS2012R2C1 и WS2012R2C2; на каждом из них устанавливаем роль «Отказоустойчивая кластеризация».
После установки роли, запускаем оснастку «Диспетчер отказоустойчивости кластеров» и переходим в Мастер создания кластеров, где конфигурируем наш отказоустойчивый кластер: создаем Quorum (общий ресурс) и MSDTC(iSCSI).
Этап 2 – Установка MS SQL Server
Важно: все действия необходимо выполнять от имени пользователя с правом заведения новых машин в домен. (Спасибоminamoto за дополнение)
Для установки нам понадобится установочный дистрибутив MS SQL Server. Запусткаем мастер установки и выбераем вариант установки нового экземпляра кластера:
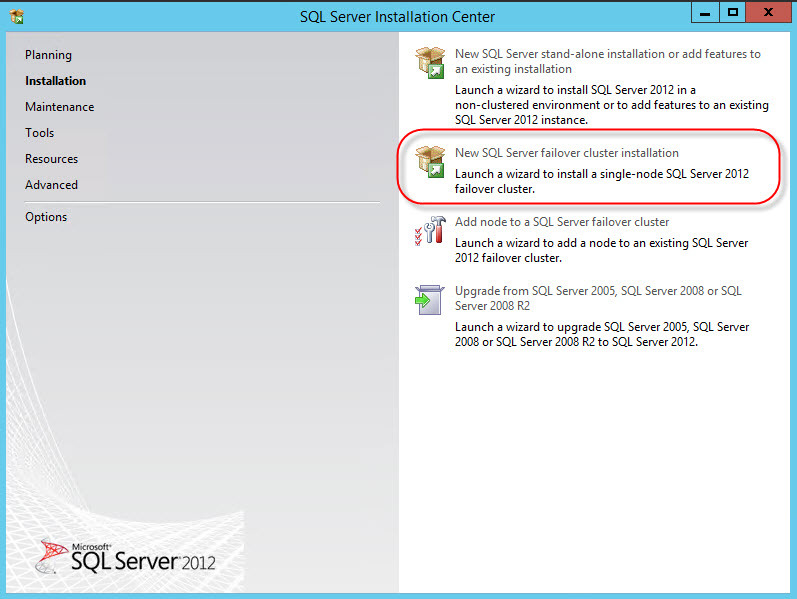
Далее вводим данные вашего лицензионного ключа:

Внимательно читаем и принимаем лицензионное соглашение:

Получаем доступные обновления:
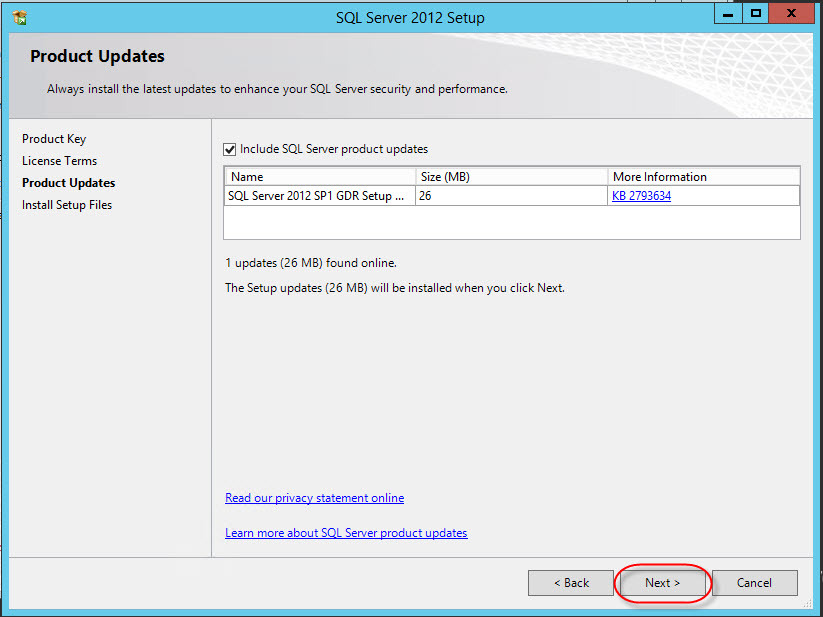
Проходим проверку конфигурации (Warning MSCS пропускаем):
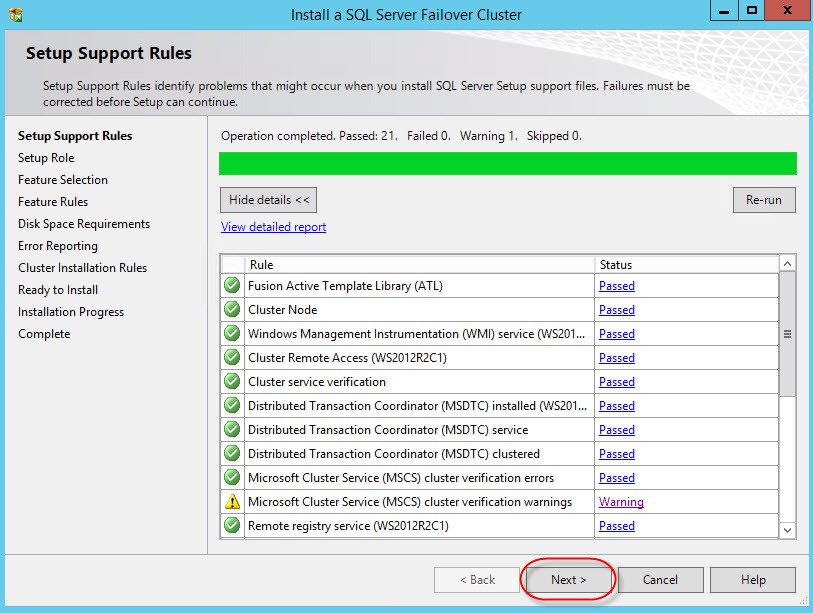
Выбираем вариант целевого назначения установки:
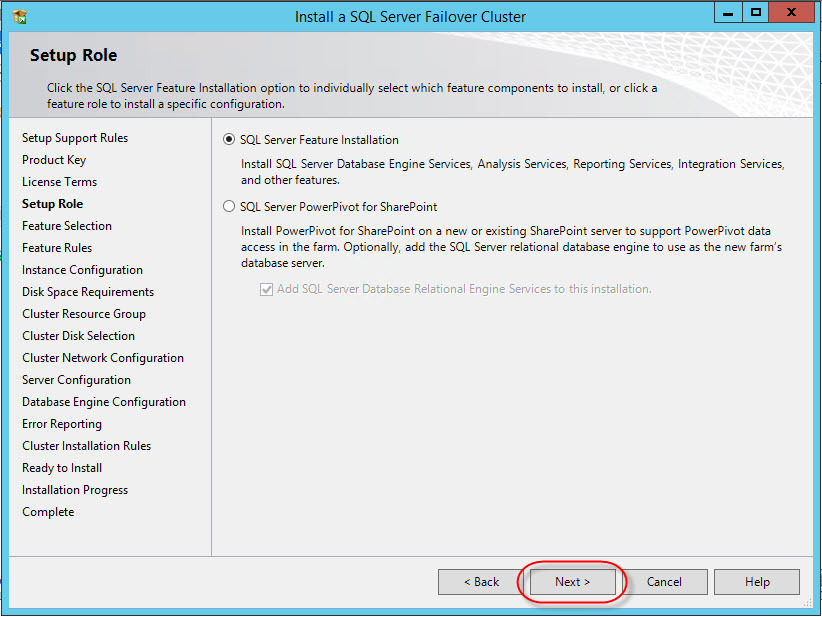
Выбираем компоненты, которые нам необходимы (для поставленной задачи достаточно основных):

Еще одна проверка установочной конфигурации:
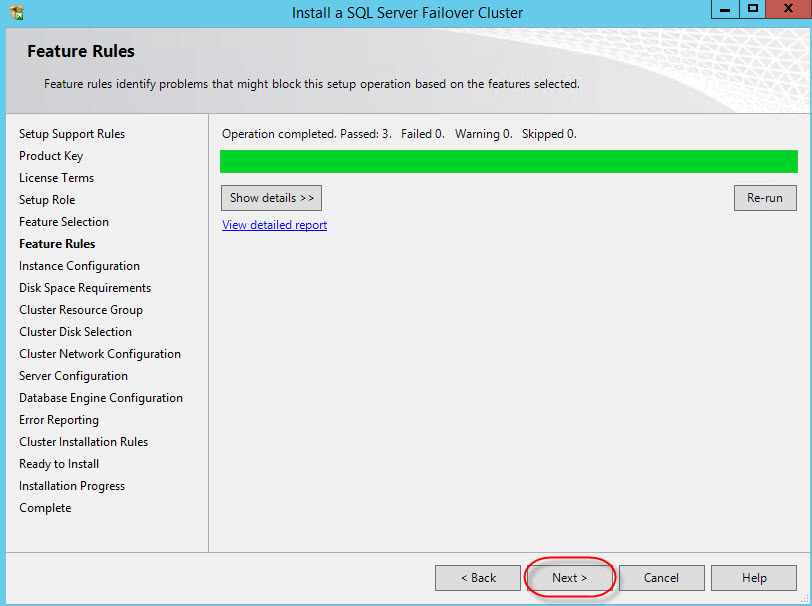
Далее — важный этап, выбор сетевого имени для кластера MSSQL (instance ID – оставляем):

Проверка доступного пространства:
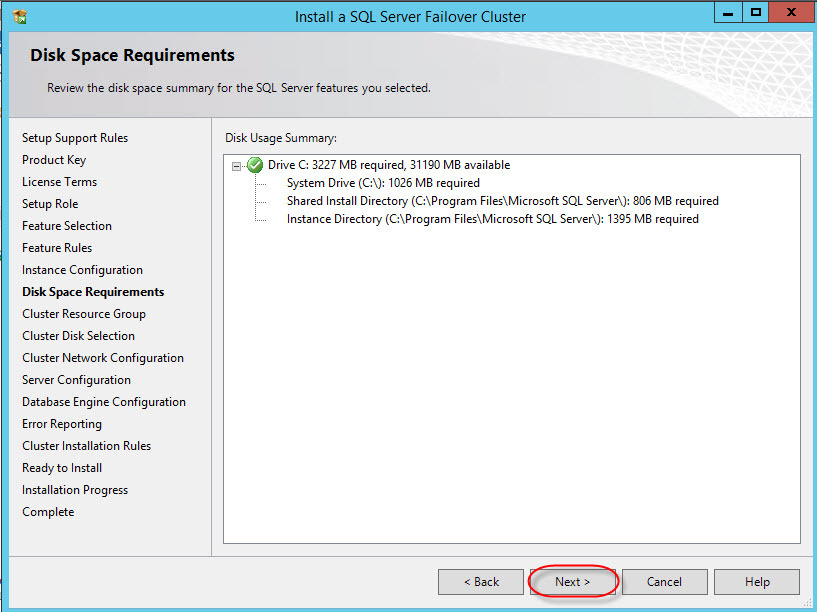
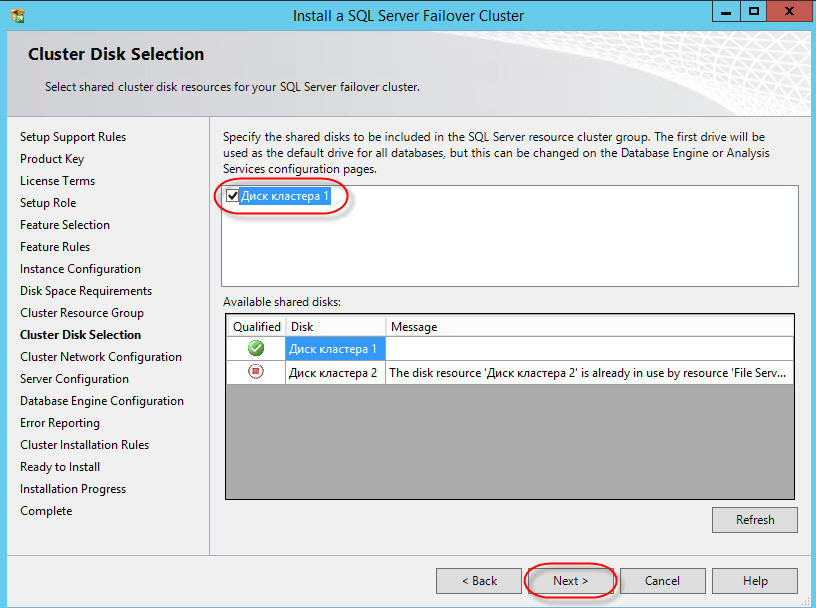
После чего — список доступных хранилищ, данных (сконфигурировано на этапе подготовки):

Выбираем диск для расположения баз данных кластера:
Конфигурацию сетевого интерфейса кластера рекомендуется указать адрес вручную:

Указываем данные администратора (можно завести отдельного пользователя для MSSQL):
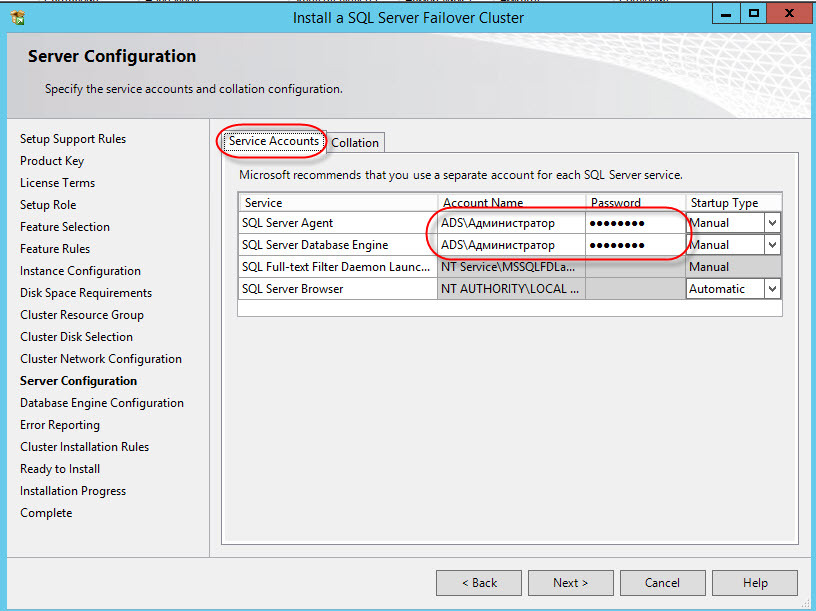
Еще один важный этап – выбор порядка сортировки (Collation). После инсталляции изменить крайне проблематично:
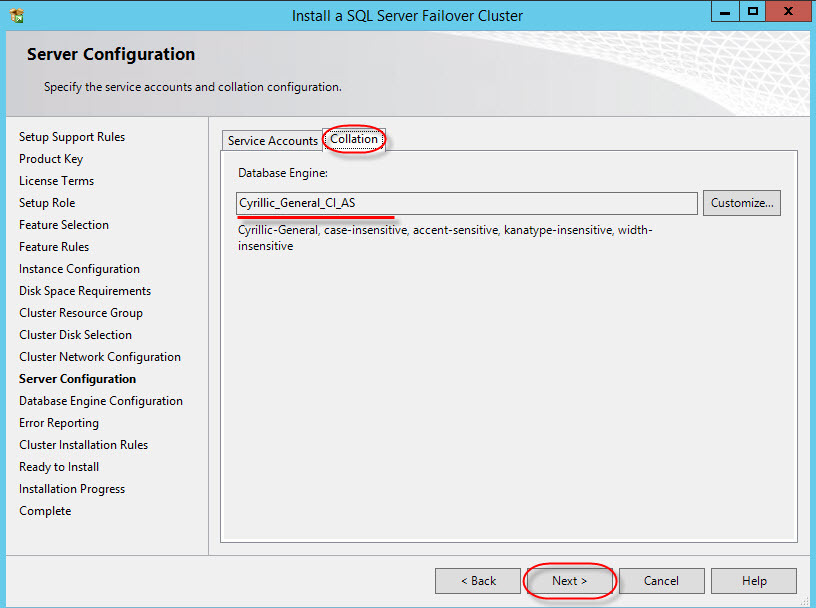
Параметры аутентификации на сервере (в нашем случае выбран смешанный вариант, хотя безопаснее использовать только доменную аутентификацию):
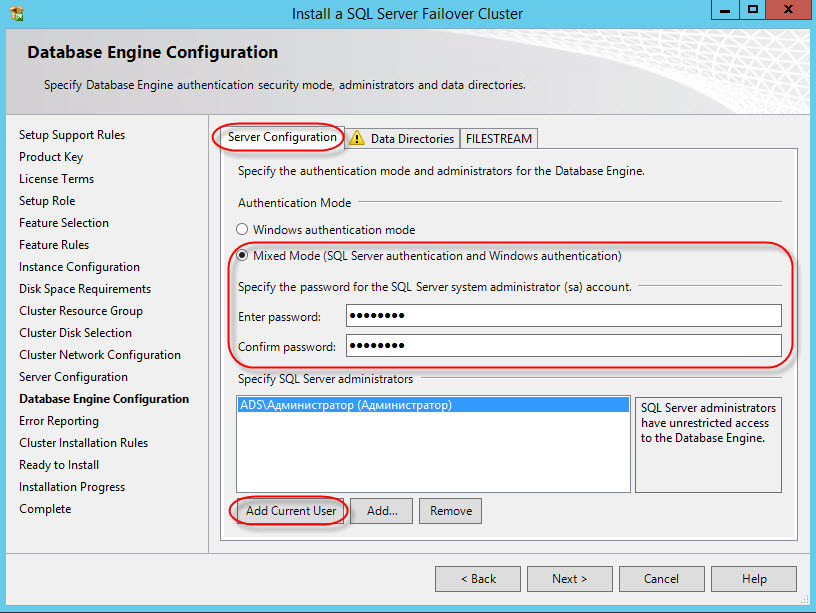
Выбор директорий хранения общих файлов кластера (в версиях MS SQL Server 2012 и старше TempDB можно хранить на каждой ноде и не выносить в общее хранилище):

Еще пару проверок:


Наконец приступаем к установке (процесс может занять длительное время):
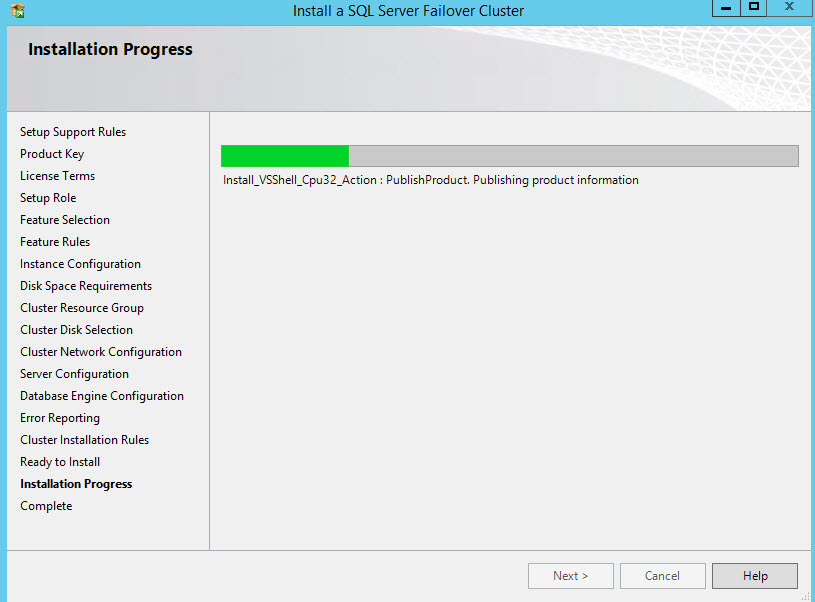
Настройка и установка базовой ноды закончена, о чем нам сообщает «зеленый» рапорт

Этап 3 – добавление второй ноды в кластер MSSQL
Дальше необходимо добавить в кластер вторую ноду, т.к. без нее об отказоустойчивости говорить не приходится.
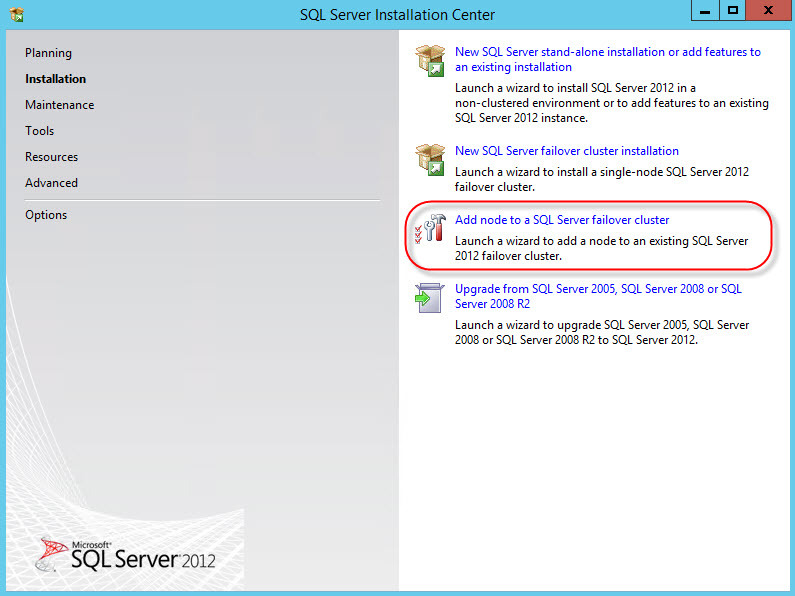
Настройка и установка намного проще. На втором сервере (ВМ) запускаем мастер установки MS SQL Server:
- Проходим стартовый тест
- Вводим лицензионный ключ:
- Читаем и принимаем лицензионное соглашение:
- Получаем обновления:
- Проходим тесты по выполнению требований для установки ноды (MSCS warning – пропускаем):
Выбираем: в какой кластер добавлять ноду:

Просматриваем и принимаем сетевые настройки экземпляра кластера:

Указываем пользователя и пароль (те же, что и на первом этапе):
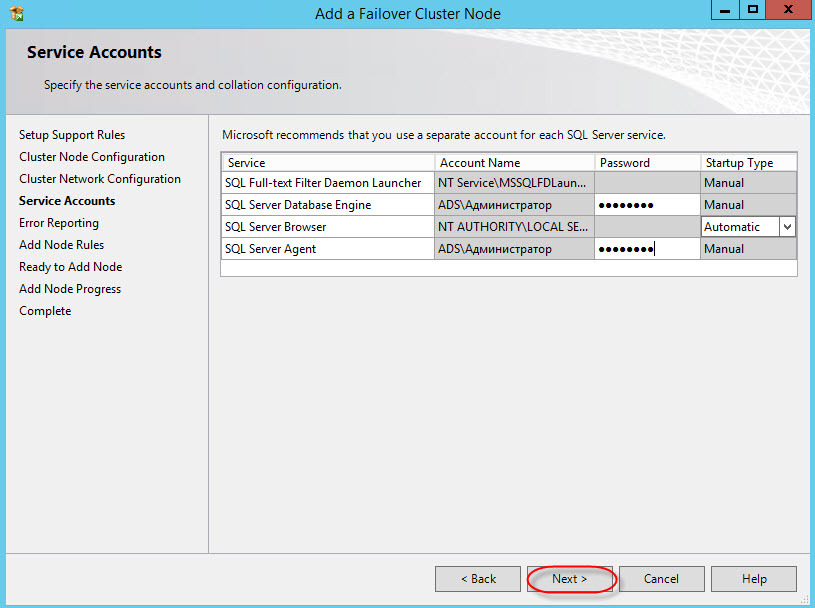
Снова тесты и процесс установки:
По завершению мы должны получить следующую картину:
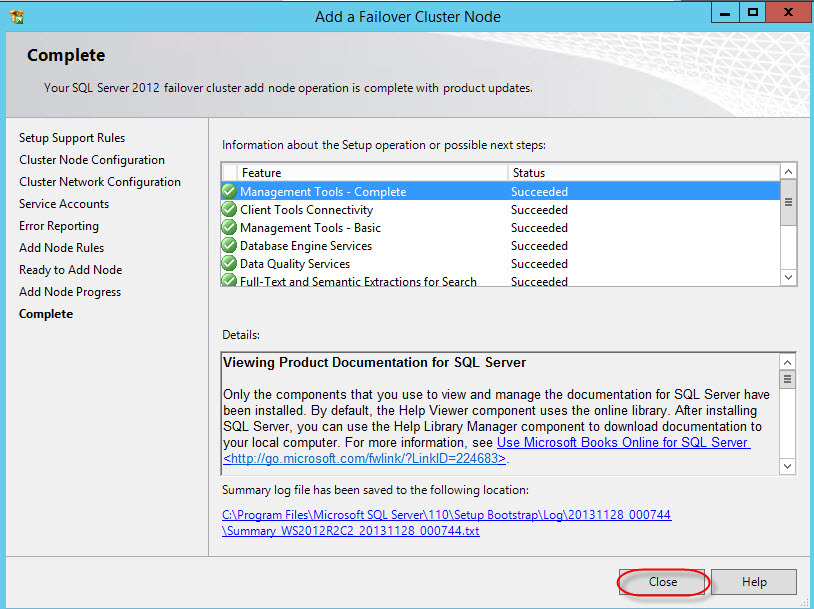
Поздравляю, установка закончена.
Этап 4 – проверка работоспособности
Удостоверимся, что все работает как надо. Для этого перейдем в оснастку «Диспетчер отказоустойчивого кластера»:
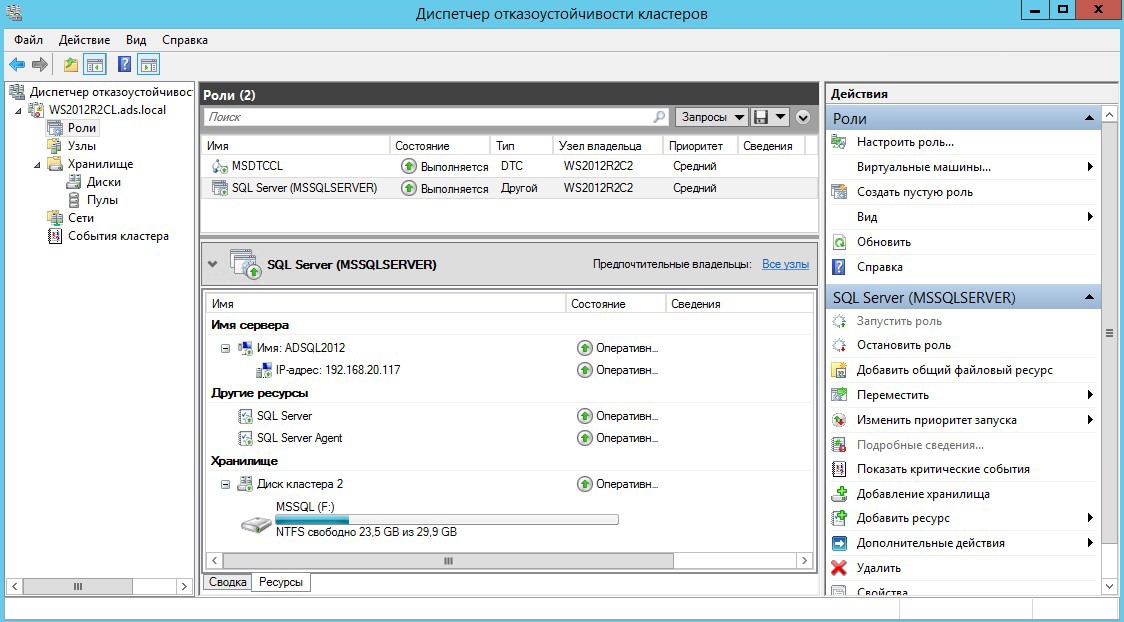
На данный момент у нас используется вторая нода(WS2012R2C2) в случае сбоя произойдет переключение на первую ноду(WS2012R2C1).
Попробуем подключиться непосредственно к кластеру сервера MSSQL, для этого нам понадобится любой компьютер в доменной сети с установленной Management Studio MSSQL. При запуске указываем имя нашего кластера и пользователя (либо оставляем доменную авторизацию).
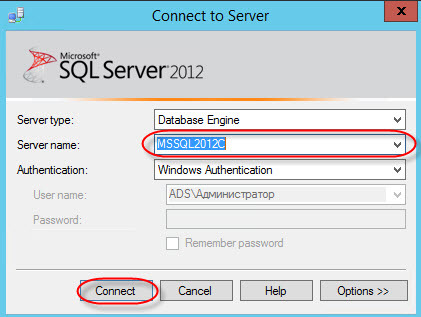
После подключения видим базы которые крутятся в кластере (на скриншоте присутствует отдельно добавленная база, после инсталляции присутствуют только системные).
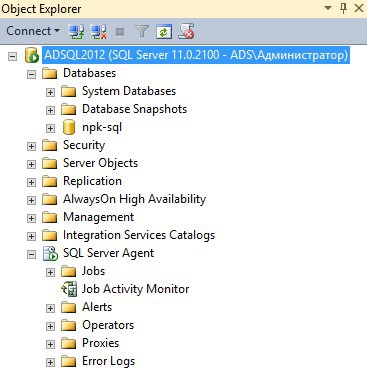
Данный экземпляр отказоустойчивого кластера полностью готов к использованию с любыми базами данных, например, 1С(для нас ставилась задача развернуть такую конфигурацию для работы именно 1С-ки). Работа с ним ничем не отличается от обычной, но основная особенность — в надежности такого решения.
В тестовых целях рекомендую поиграть с отключением нод и посмотреть как происходит миграция базы между ними; проконтролировать важные для вас параметры, например, сколько по времени будет длиться переключение.
У нас при отказе одной из нод – происходит разрыв соединения с базой и переключение на вторую (время восстановления работоспособности: до минуты).
В полевых условиях для обеспечения надежности всей инфраструктуры необходимо обработать точки отказа: СХД, AD и DNS.
P.S. Удачи в построении отказоустойчивых решений.